새 학기 첫날, 서른 명 남짓한 반에서 담임 선생님이 이렇게 묻습니다. “이 반에 생일이 같은 사람이 있을까요?” 1년이 365일이나 되니 서른 명 정도로는 겹치기 어렵다고 생각하기 쉽습니다. 그런데 실제로 계산해 보면 생일이 같은 두 사람이 있을 확률은 약 70%나 됩니다.
직관과 계산이 이렇게 크게 어긋나는 현상을 ‘생일 역설(Birthday Paradox)’이라고 부릅니다. 생일 역설이란 쉽게 말해 ‘몇십 명만 모여도 생일이 같은 사람이 있을 확률이 생각보다 훨씬 높다’는 사실을 의미합니다. 논리적으로 모순이 있는 것은 아니지만 처음 들으면 틀린 것처럼 느껴져 역설이라는 이름이 붙었습니다.
본 자료에서는 생일 역설이 무엇인지부터 확률을 계산하는 원리, 우리가 왜 이렇게 착각하는지, 그리고 이 원리가 정보 보안 같은 현실에서 어떻게 쓰이는지까지 차례로 살펴보겠습니다.
생일 역설의 원리와 활용
23명이면 반반이 되는 확률
생일 역설은 보통 몇 가지 가정을 두고 계산합니다. 계산을 단순하게 만들기 위해서입니다.
- 1년의 길이(Days in a Year): 1년은 365일로 보고, 4년에 한 번 오는 2월 29일은 뺍니다.
- 고른 분포(Uniform Distribution): 모든 날짜에 태어날 가능성이 똑같다고 봅니다.
- 독립성(Independence): 한 사람의 생일이 다른 사람의 생일에 영향을 주지 않는다고 보며, 쌍둥이는 없다고 가정합니다.
이 조건에서 생일이 같은 사람이 적어도 한 쌍 있을 확률은 10명일 때 약 11.7%로 아직 드문 일입니다. 그러나 23명이 되면 약 50.7%로 처음 절반을 넘고, 30명이면 약 70.6%, 50명이면 약 97%, 70명이면 약 99.9%까지 올라갑니다. 사람 수는 조금씩 늘어나는데 확률은 가파르게 치솟는 셈입니다.
반대로 생일이 반드시 겹치려면 366명이 필요합니다. 날짜가 365개뿐이니 366명째는 누군가와 겹칠 수밖에 없기 때문입니다. 그런데 1년 365일의 15분의 1에도 못 미치는 23명만 모여도 확률이 절반을 넘는다는 점이 이 현상을 역설처럼 보이게 만듭니다.
실제로는 특정 계절이나 요일에 아기가 더 많이 태어나기 때문에 생일이 고르게 퍼져 있지 않습니다. 이렇게 고르지 않으면 겹칠 확률은 오히려 조금 더 높아지지만, 그 차이가 크지 않아 실제 출생 자료로 따져 봐도 절반을 넘는 기준은 여전히 23명입니다.
확률을 계산하는 두 가지 열쇠
생일 역설을 이해하는 열쇠는 두 가지입니다.
(1) 반대 경우부터 세기
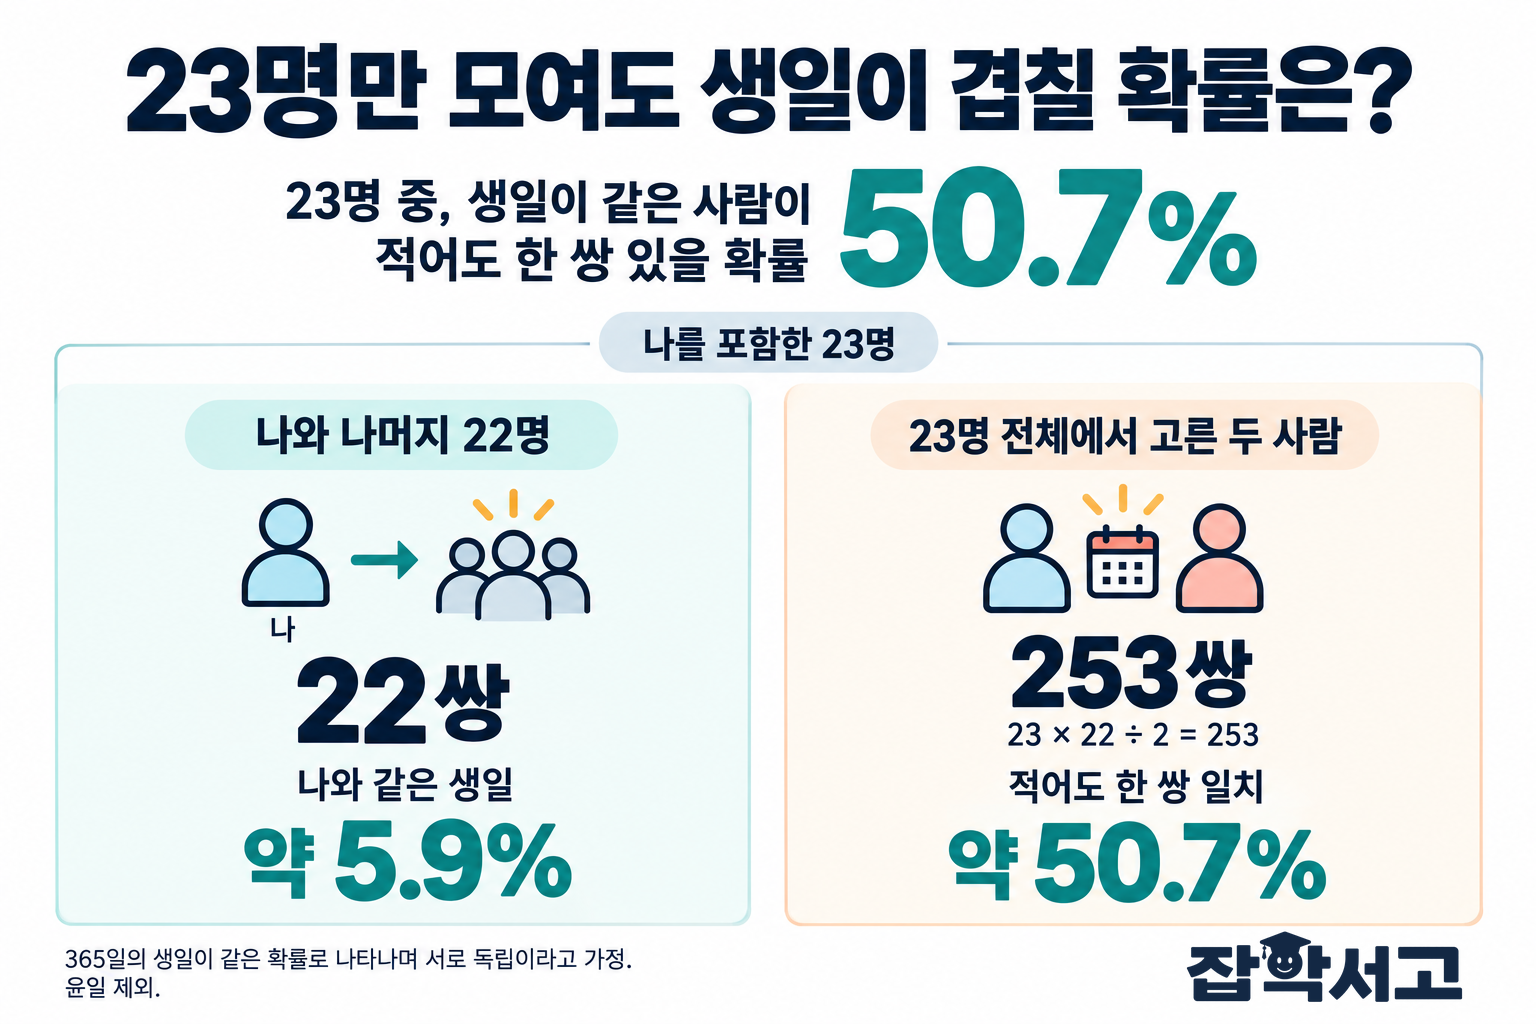
‘누군가 겹칠 확률’을 바로 구하면 경우가 너무 많습니다. 그래서 ‘모두 다를 확률’을 먼저 구한 뒤 1에서 빼는 방법을 씁니다. 두 번째 사람이 첫 사람과 다를 확률은 364/365이고, 세 번째 사람이 앞의 두 사람과 모두 다를 확률은 363/365입니다. 이렇게 23명까지 곱하면 모두 다를 확률은 약 49.3%가 되고, 나머지 약 50.7%가 누군가 겹칠 확률입니다.
(2) 사람이 아니라 짝을 세기
23명이 모이면 두 사람씩 짝을 짓는 방법은 23×22÷2, 곧 253가지입니다. 한 쌍이 겹칠 확률은 365분의 1로 작지만, 253번이나 기회가 주어지면 그중 한 번은 맞아떨어질 가능성이 커집니다. 사람 수가 늘면 짝의 수는 그보다 훨씬 빠르게 늘어납니다. 사람이 2배가 되면 짝은 대략 4배가 되기 때문에, 겹칠 기회도 그만큼 빠르게 불어납니다.
한 명씩 차례로 방에 들어온다고 생각해 보면, 생일이 같은 첫 짝이 나타날 때까지 평균 약 25명이 들어와야 합니다. 이 역시 365라는 숫자에 비하면 아주 작은 수입니다.
직관이 확률을 놓치는 이유
이 현상이 놀랍게 느껴지는 까닭은 질문을 다르게 알아듣기 때문입니다. 많은 사람은 ‘누군가 나와 생일이 같을 확률’을 떠올립니다. 이 확률은 23명이 모여도 약 6%에 그치고, 50%를 넘기려면 253명이 필요합니다. 하지만 생일 역설이 묻는 것은 나를 포함한 ‘아무나 두 사람’의 생일이 같을 확률입니다.
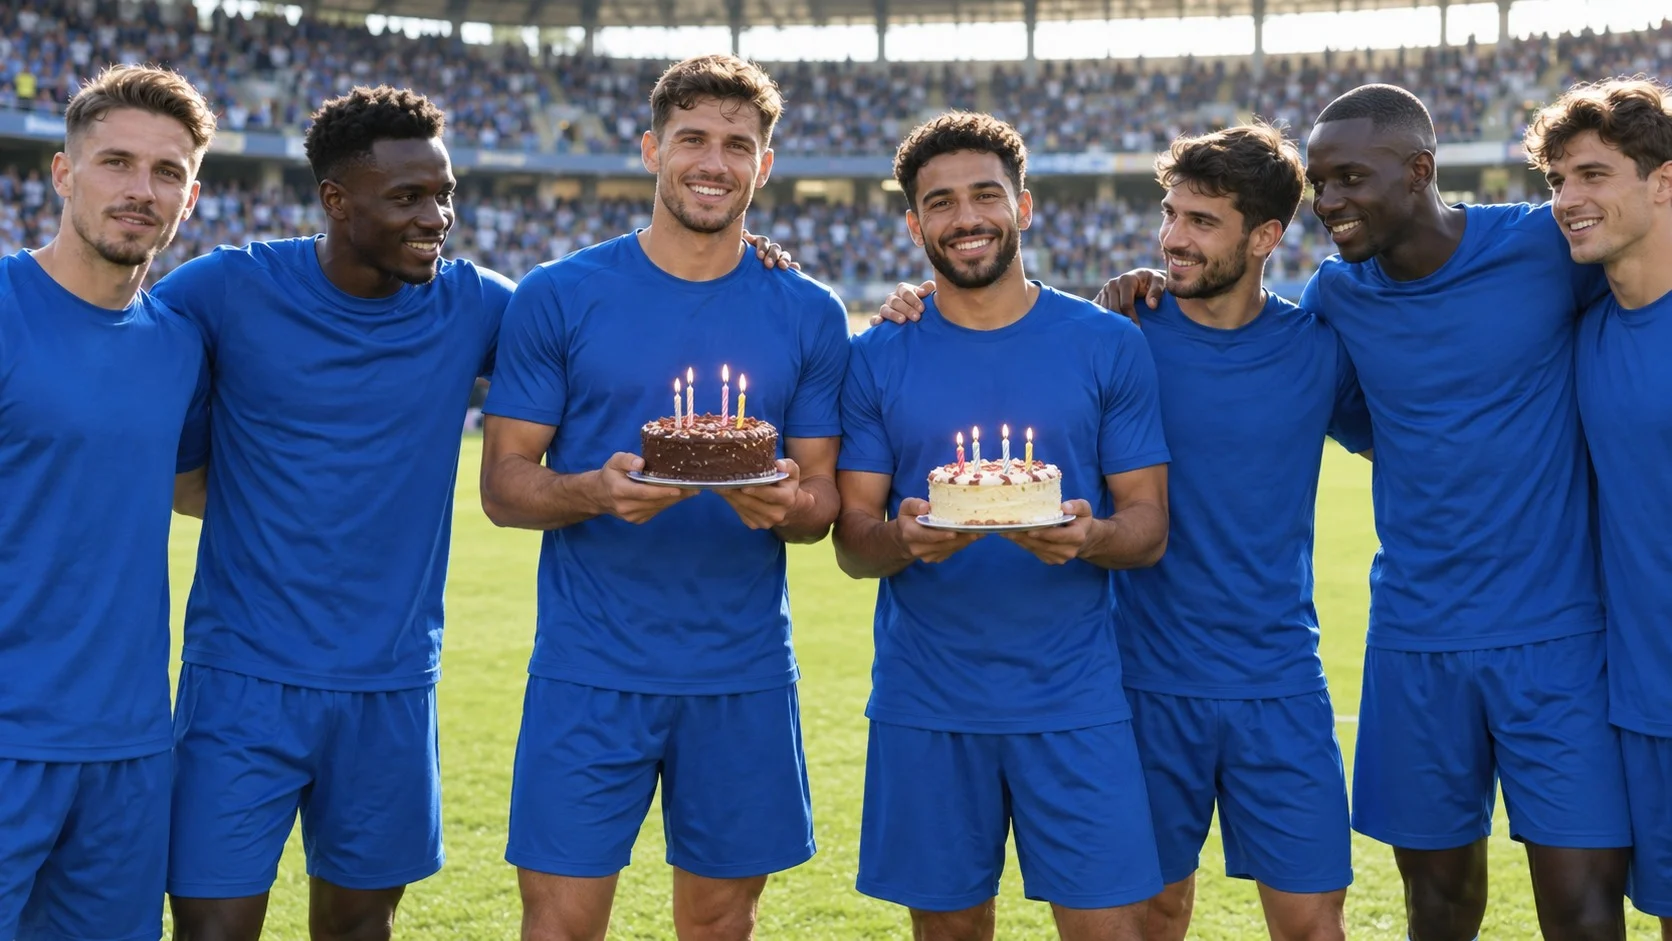
실제 사례도 있습니다. 2014년 브라질 월드컵에서는 32개 나라가 모두 23명씩 선수 명단을 냈습니다. 영국 BBC의 분석에 따르면 그중 절반인 16개 팀에 생일이 같은 선수가 있었고, 우리나라를 비롯한 5개 팀에는 그런 짝이 두 쌍씩 있었습니다. 23명이면 반반이라는 계산과 놀랍도록 잘 맞는 결과입니다.
이 문제는 1920년대 영국의 수학자 해럴드 대븐포트(Harold Davenport)가 처음 떠올린 것으로 알려져 있고, 1939년 리하르트 폰 미제스(Richard von Mises)가 처음 논문으로 발표했습니다.
정보 보안에 숨어 있는 생일 역설
생일 역설은 교실 밖에서 더 중요하게 쓰입니다. 대표적인 곳이 아무리 긴 데이터라도 정해진 길이의 짧은 값으로 바꾸는 해시 함수(Hash Function)입니다.
- 해시 충돌(Hash Collision): 서로 다른 두 데이터가 같은 해시 값을 갖는 경우로, 생일이 같은 두 사람과 같은 상황입니다.
- 생일 공격(Birthday Attack): 생일 역설의 원리를 이용해 충돌을 찾는 공격입니다. 결과가 n비트인 해시라면 2의 n제곱 번이 아니라 대략 2의 (n÷2)제곱 번 정도만 시도해도 충돌을 찾을 확률이 절반쯤 됩니다.
- 보안 설계(Security Design): 그래서 충돌에 견뎌야 하는 해시 함수는 결과 길이를 넉넉하게 잡아 이런 공격에 대비합니다.
데이터를 정리하는 해시 테이블에서도 저장할 항목이 많아지면 몇 번의 충돌은 피할 수 없다고 보고 처음부터 대비책을 넣어 설계합니다.
생일 역설은 우리 직관이 ‘나 하나’를 기준으로 생각하는 데 익숙하고, 수많은 짝이 만들어 내는 기회는 잘 보지 못한다는 사실을 보여 줍니다. 우연처럼 보이는 일도 따져 보면 생각보다 자주 일어날 수 있습니다.
놀라운 우연 앞에서 한 번 더 경우의 수를 세어 보는 것, 그것이 확률을 바르게 읽는 일의 첫걸음입니다.