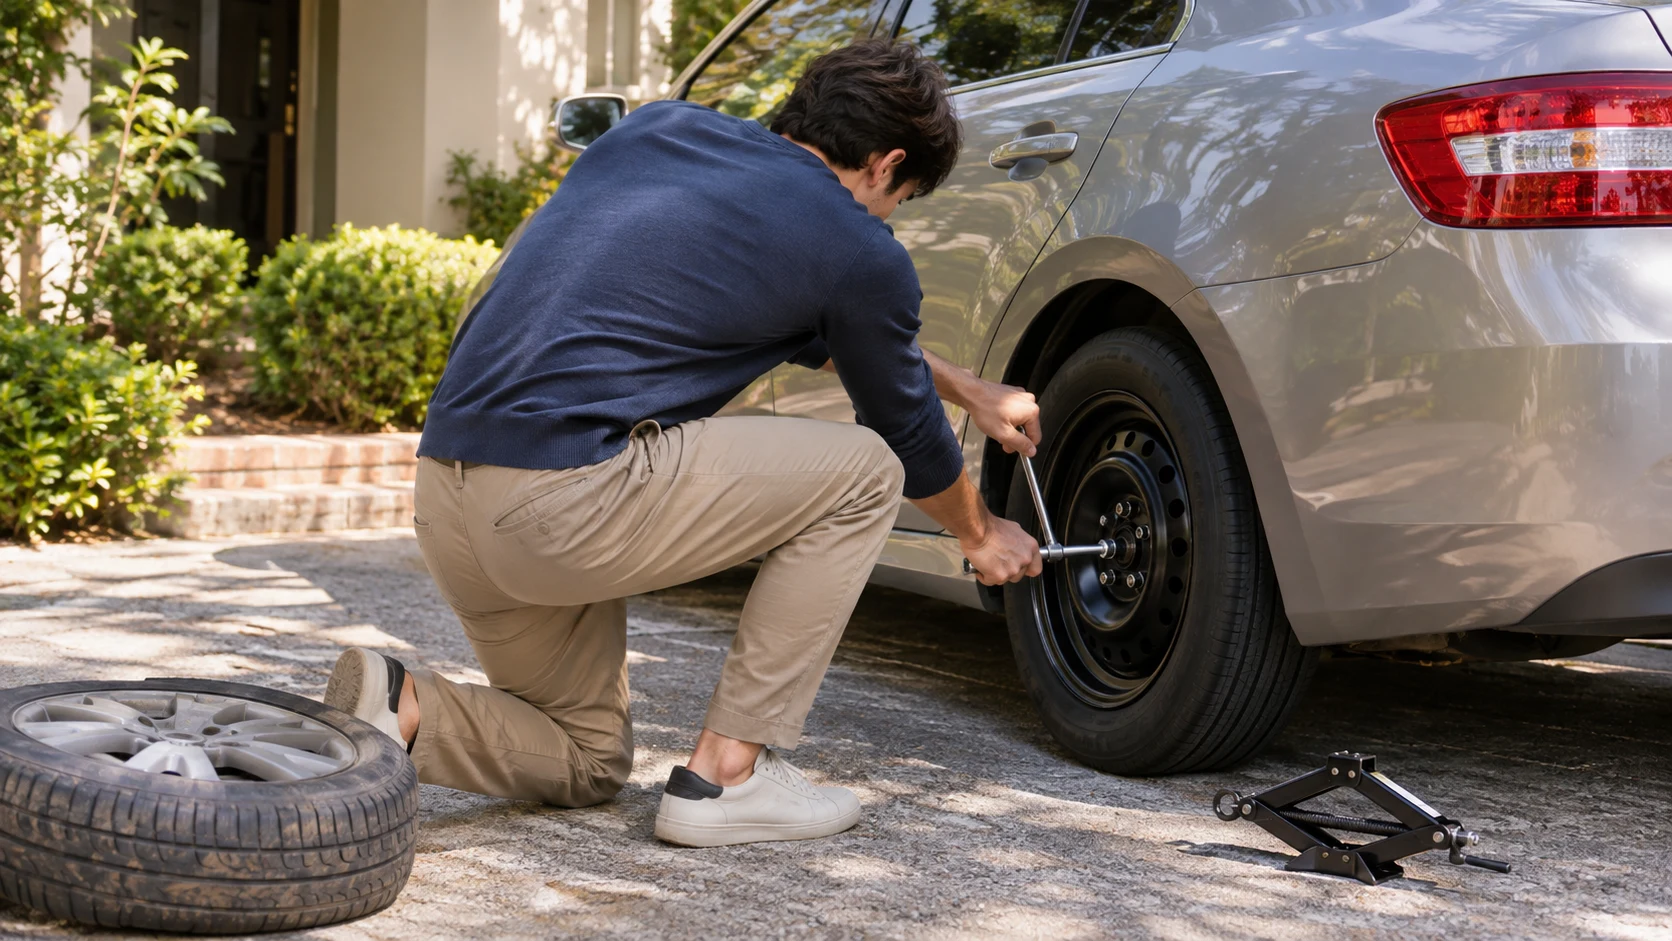
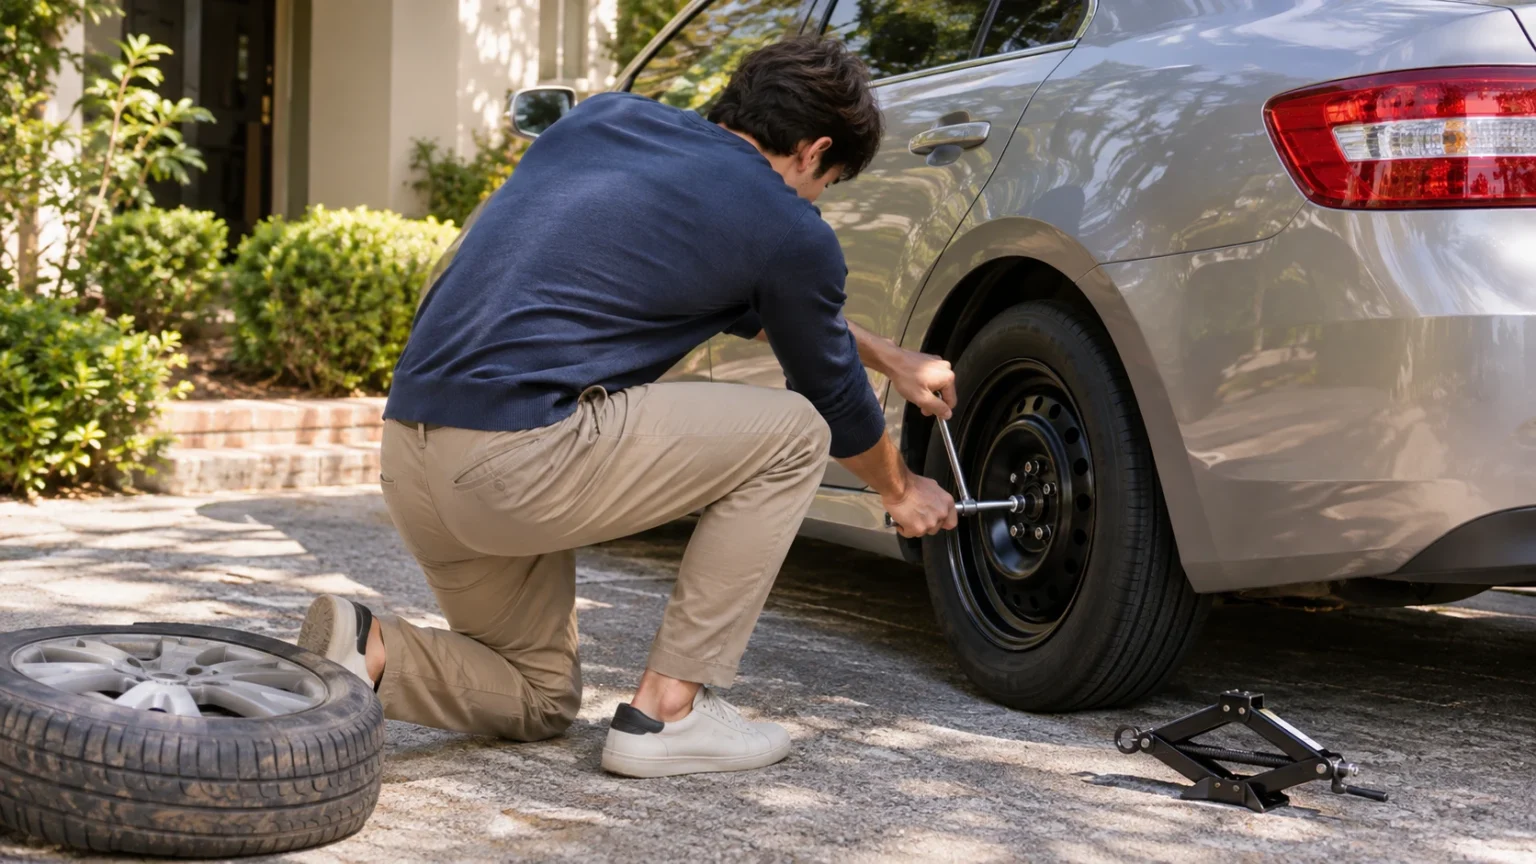
Có lốp dự phòng trong cốp xe không có nghĩa là khi bị thủng lốp giữa đường, bạn thật sự thay được bánh xe. Nếu chưa từng làm, có lẽ bạn còn không biết phải đặt kích ở đâu. Các dịch vụ internet chạy trên vô số máy chủ cũng vậy: chuẩn bị sẵn thiết bị dự phòng và thật sự trụ vững trong một sự cố thực tế là hai chuyện hoàn toàn khác nhau. Vì thế, một số doanh nghiệp cố tình gây lỗi cho những dịch vụ đang chạy bình thường, và cách làm này được gọi là ‘kỹ thuật hỗn loạn (Chaos Engineering)’.
Nói một cách đơn giản, kỹ thuật hỗn loạn là ‘phương pháp cố tình gây sự cố cho hệ thống bằng các thí nghiệm, nhằm tích lũy niềm tin rằng hệ thống có thể trụ vững ngay cả giữa những xáo trộn khó lường’. Phương pháp này trở nên phổ biến vào năm 2011, khi Netflix, lúc đó đang chuyển lên đám mây, giới thiệu một công cụ tắt ngẫu nhiên các máy chủ đang phục vụ khách hàng thật.
Trong bài viết này, chúng ta sẽ lần lượt tìm hiểu vì sao Netflix thả một ‘con khỉ’ vào phòng máy chủ, bốn bước mà một thí nghiệm hỗn loạn trải qua, phạm vi thí nghiệm đã mở rộng thành cả một đội quân khỉ, và những nguyên tắc để phá hệ thống một cách an toàn.
Ngành kỹ thuật chủ động tạo ra sự cố thay vì chờ nó xảy ra
1. Vì sao Netflix thả khỉ vào phòng máy chủ
Tháng 8 năm 2008, cơ sở dữ liệu trong trung tâm dữ liệu riêng của Netflix bị hỏng nặng, khiến công ty không thể gửi đĩa DVD trong ba ngày. Từ sự việc này, ngay trong năm đó Netflix bắt đầu chuyển dịch vụ lên đám mây của Amazon Web Services (AWS) và thiết kế hệ thống với giả định rằng một số trong rất nhiều máy chủ có thể hỏng bất cứ lúc nào.
(1) Chỉ có lốp dự phòng là chưa đủ
Tháng 7 năm 2011, blog kỹ thuật của Netflix viết rằng có lốp dự phòng không bảo đảm bạn xử lý được khi thủng lốp. Muốn thật sự sẵn sàng, bạn phải cố tình chọc thủng lốp ngay trước nhà rồi tập thay; việc luyện tập vốn tốn kém ngoài đời thực này lại có thể tự động hóa trên đám mây mà gần như không tốn chi phí.
(2) Chaos Monkey ra đời
Công cụ được tạo ra cho mục đích đó là Chaos Monkey. Nó chọn ngẫu nhiên các máy chủ đang phục vụ khách hàng thật rồi tắt đi, sau đó kiểm tra xem khách hàng có còn dùng dịch vụ bình thường mà không bị ảnh hưởng hay không. Cái tên xuất phát từ hình ảnh một con khỉ xông vào trung tâm dữ liệu và phá thiết bị lung tung; năm 2012, mã nguồn của nó được công bố theo giấy phép Apache 2.0.
(3) Cố tình gây lỗi trong giờ làm việc
Chaos Monkey hoạt động trong giờ làm việc các ngày trong tuần, khi các kỹ sư đang theo dõi. Mục đích là tìm ra điểm yếu vào lúc có thể xử lý ngay khi có vấn đề, rồi sửa để lần sau hệ thống tự phục hồi mà không cần con người can thiệp.
2. Bốn bước của một thí nghiệm hỗn loạn
Kỹ thuật hỗn loạn không phải là phá máy chủ một cách tùy tiện, mà là một quá trình đặt giả thuyết và kiểm chứng giống như thí nghiệm khoa học. Bộ ‘Nguyên tắc của kỹ thuật hỗn loạn (Principles of Chaos Engineering)’ do các kỹ sư Netflix soạn ra mô tả thí nghiệm qua bốn bước sau.
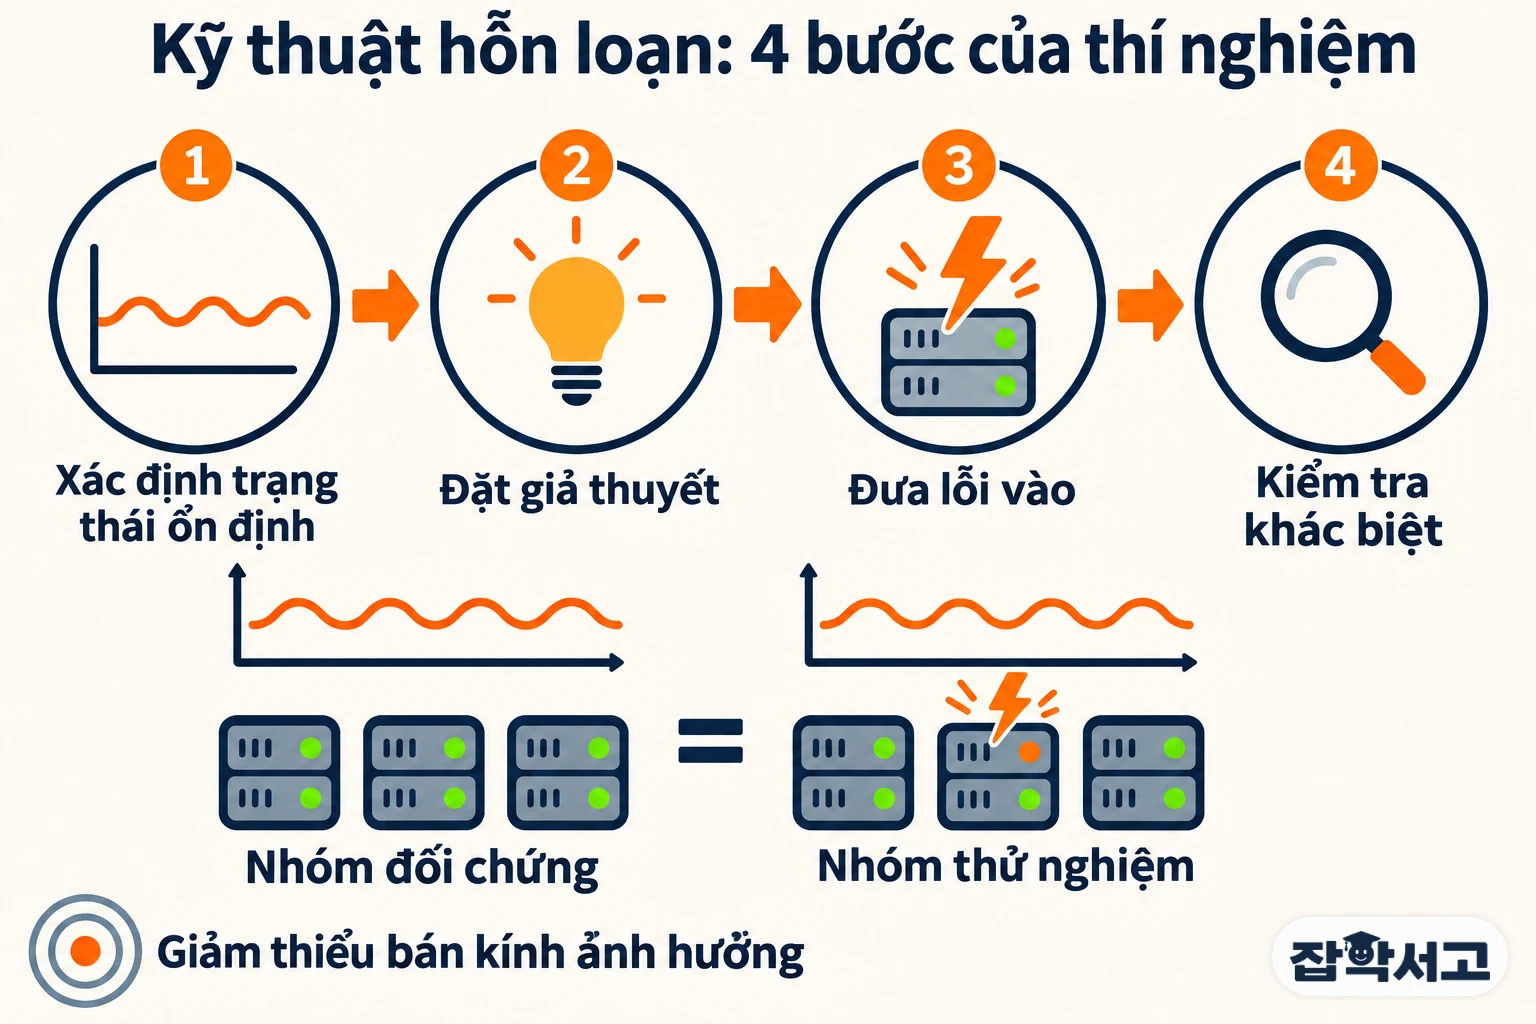
- Trạng thái ổn định (Steady State): Các chỉ số đo được như thông lượng, tỷ lệ lỗi hay độ trễ phản hồi, cho thấy hệ thống đang vận hành bình thường.
- Giả thuyết (Hypothesis): Dự đoán rằng trạng thái ổn định sẽ được duy trì ở cả nhóm thử nghiệm bị đưa lỗi vào lẫn nhóm đối chứng được giữ nguyên.
- Đưa lỗi vào (Fault Injection): Cố tình tạo ra những sự kiện có thể xảy ra ngoài thực tế, như máy chủ bị tắt hay kết nối mạng bị cắt.
- Nhóm đối chứng và nhóm thử nghiệm (Control Group and Experimental Group): Xem trạng thái ổn định của hai nhóm có xuất hiện khác biệt hay không để kiểm tra xem có bằng chứng bác bỏ giả thuyết không.
Điểm đặc biệt của thí nghiệm này là quan sát kết quả bộc lộ ra bên ngoài thay vì soi từng chi tiết bên trong hệ thống. Càng không tìm thấy khác biệt giữa hai nhóm, niềm tin rằng hệ thống chịu được xáo trộn càng lớn; còn nếu tìm thấy khác biệt, nghĩa là đã phát hiện ra một điểm yếu cần sửa trước khi sự cố thật bùng phát.
3. Thí nghiệm mở rộng thành đội quân khỉ
Khi Chaos Monkey chứng tỏ được hiệu quả, Netflix lần lượt tạo ra các công cụ phụ trách nhiều loại sự cố khác nhau và gọi chúng là ‘Simian Army’, tức đội quân khỉ. Phạm vi thí nghiệm cũng mở rộng từ một máy chủ sang cả trung tâm dữ liệu, rồi đến toàn bộ một khu vực.
(1) Chậm đi cũng là sự cố
Latency Monkey cố tình thêm độ trễ vào việc liên lạc giữa các máy chủ để mô phỏng tình huống dịch vụ bị chậm. Nếu cho độ trễ thật dài, có thể thử tình huống giống như dịch vụ ngừng hoạt động mà không cần thật sự tắt máy chủ nào.
(2) Dọn máy chủ vi phạm quy tắc và tài nguyên bỏ không
Conformity Monkey tìm và tắt những máy chủ vi phạm thực hành tốt nhất, chẳng hạn không thuộc nhóm tự động mở rộng, còn Janitor Monkey tìm và dọn những tài nguyên không còn dùng để giữ cho đám mây gọn gàng.
(3) Thí nghiệm tắt cả trung tâm dữ liệu và toàn khu vực
Chaos Gorilla mô phỏng tình huống cả một vùng khả dụng (Availability Zone) của AWS ngừng hoạt động, còn Chaos Kong tắt toàn bộ một khu vực (Region). Việc Netflix chuyển dịch vụ của một khu vực sang khu vực khác ban đầu mất khoảng 50 phút, nhưng sau đó rút xuống còn khoảng 6 phút.
4. Những nguyên tắc để phá hệ thống một cách an toàn
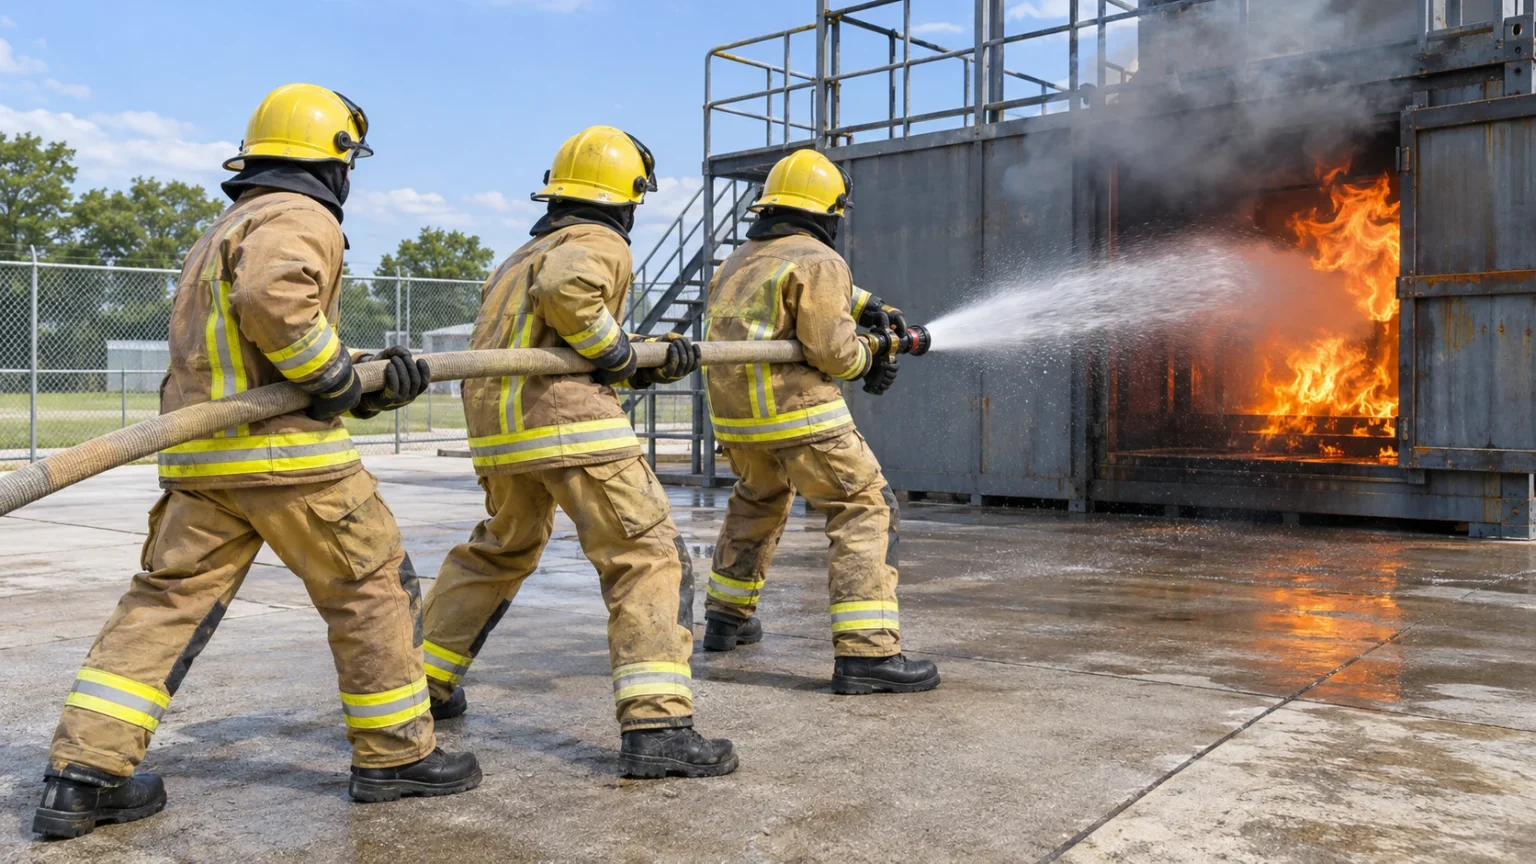
Ý tưởng cố tình gây sự cố khá giống một buổi diễn tập chữa cháy. Thực tế, năm 2003, Jesse Robbins ở Amazon đã lấy cảm hứng từ việc huấn luyện lính cứu hỏa để tạo ra ‘Game Day’, ngày cố tình gây ra những sự cố lớn theo lịch định sẵn. Tuy nhiên, cũng như ngọn lửa tập luyện không được lan ra ngoài khu vực quy định, thí nghiệm hỗn loạn cũng có những nguyên tắc phải tuân thủ.
(1) Giảm thiểu bán kính ảnh hưởng
Việc giảm tối đa thiệt hại mà thí nghiệm có thể gây ra cho khách hàng được gọi là ‘giảm thiểu bán kính ảnh hưởng (Blast Radius)’. Thí nghiệm bắt đầu ở phạm vi nhỏ, mở rộng dần khi không có vấn đề, và phải có thể dừng ngay khi thấy bất thường.
(2) Trong môi trường vận hành thật, một cách tự động
Vì hệ thống hoạt động khác nhau tùy môi trường và lưu lượng truy cập, các nguyên tắc khuyến nghị thí nghiệm ngay trong môi trường vận hành thật. Ngoài ra, thí nghiệm làm thủ công khó duy trì lâu dài, nên cần tự động hóa cả thí nghiệm lẫn việc phân tích kết quả để lặp lại đều đặn.
(3) Không chỉ sự cố mà cả những sự kiện bất ngờ
Đối tượng thí nghiệm không chỉ là hỏng hóc phần cứng hay lỗi phần mềm mà còn cả những sự kiện không phải sự cố, như lượng truy cập tăng vọt đột ngột. Các sự kiện được xếp thứ tự ưu tiên để thử nghiệm dựa trên mức độ ảnh hưởng hoặc khả năng thường xảy ra.
Kỹ thuật hỗn loạn xuất phát không hẳn từ nỗ lực loại bỏ hoàn toàn sự cố, mà từ thái độ chấp nhận rằng sự cố nhất định sẽ xảy ra và chủ động trải qua nó trước. Sự cố là điều không tránh khỏi, vậy thà trải qua nó trước vào thời điểm do chính mình chọn – ý nghĩ đơn giản ấy chính là bước đầu tiên để hiểu kỹ thuật hỗn loạn.