¿Tener una rueda de repuesto en el maletero garantiza que, si se pincha un neumático en plena carretera, de verdad sabrá cambiarlo? Si nunca lo ha hecho, quizá ni siquiera sepa dónde colocar el gato. Con los servicios de internet que funcionan sobre innumerables servidores ocurre lo mismo: tener equipos de reserva y resistir de verdad una avería real son dos cosas completamente distintas. Por eso, algunas empresas provocan fallos a propósito en servicios que funcionan perfectamente, un método que se conoce como «ingeniería del caos (Chaos Engineering)».
Dicho de forma sencilla, la ingeniería del caos significa ‘un método para ganar confianza en que un sistema puede resistir turbulencias difíciles de prever mediante experimentos que le provocan fallos de forma deliberada’. Se dio a conocer ampliamente en 2011, cuando Netflix, que estaba migrando a la nube, presentó una herramienta que apagaba al azar servidores que atendían a clientes reales.
En este artículo veremos, por orden, por qué Netflix soltó un «mono» en sus salas de servidores, los cuatro pasos que sigue un experimento de caos, cómo los experimentos crecieron hasta formar un ejército de monos y los principios para romper sistemas de forma segura.
Una ingeniería que provoca los fallos en lugar de esperarlos
1. Por qué Netflix soltó un mono en su sala de servidores
En agosto de 2008, una grave corrupción de la base de datos en el centro de datos propio de Netflix dejó a la empresa sin poder enviar DVD durante tres días. A raíz de ello, ese mismo año Netflix empezó a trasladar su servicio a la nube de Amazon Web Services (AWS) y a diseñar sus sistemas partiendo de que algunos de sus muchos servidores podían fallar en cualquier momento.
(1) Con la rueda de repuesto no basta
En julio de 2011, el blog técnico de Netflix escribió que tener una rueda de repuesto no garantiza que uno sepa arreglárselas con un pinchazo. Para estar preparado de verdad habría que pinchar a propósito un neumático frente a casa y practicar el cambio; esa práctica, costosa en la vida real, en la nube puede automatizarse casi sin coste.
(2) Llega Chaos Monkey
La herramienta creada para ello fue Chaos Monkey. Elige al azar servidores que atienden a clientes reales, los apaga y comprueba si los clientes siguen pudiendo usar el servicio sin verse afectados. Su nombre procede de la imagen de un mono que irrumpe en un centro de datos y destroza equipos sin control, y en 2012 su código fuente se publicó con la licencia Apache 2.0.
(3) Romper a propósito en horario laboral
Chaos Monkey funcionaba en horario laboral de lunes a viernes, mientras los ingenieros estaban atentos. La idea era encontrar los puntos débiles en un momento en que cualquier problema pudiera atenderse de inmediato y corregirlos para que, la próxima vez, el sistema se recuperara solo sin intervención humana.
2. Los cuatro pasos de un experimento de caos
La ingeniería del caos no consiste en romper servidores a ciegas, sino en un proceso que, como un experimento científico, formula una hipótesis y la pone a prueba. Los «Principios de la ingeniería del caos (Principles of Chaos Engineering)», redactados por ingenieros de Netflix, describen el experimento en los cuatro pasos siguientes.
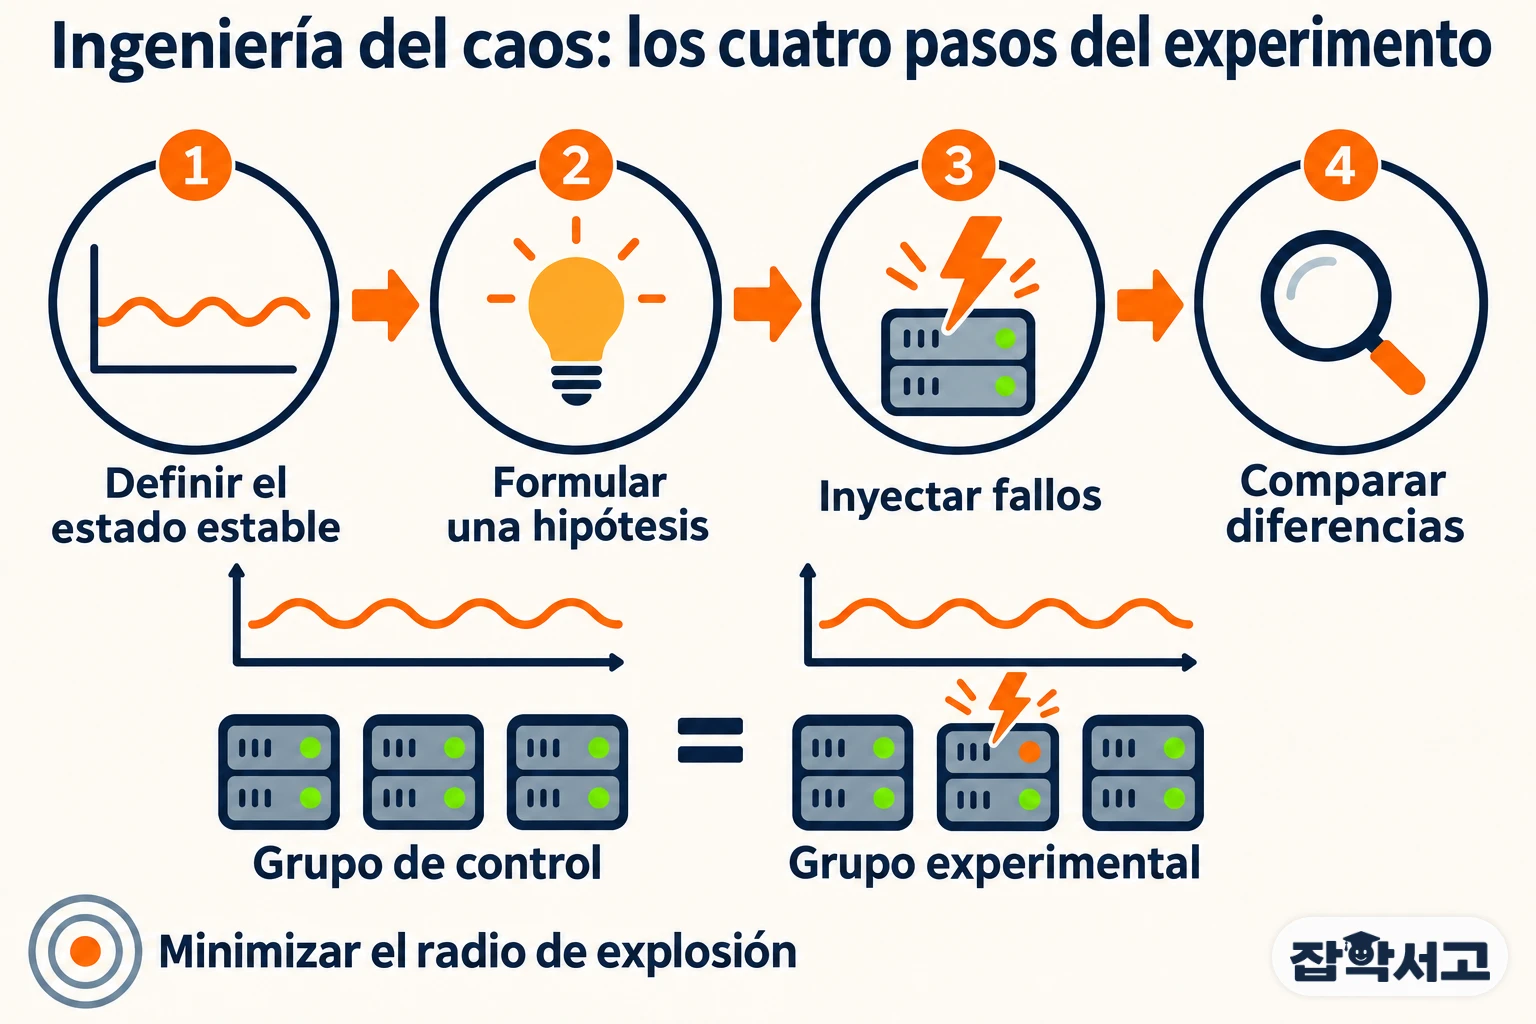
- Estado estable (Steady State): indicadores medibles, como el rendimiento, la tasa de errores o la latencia de respuesta, que muestran que el sistema funciona con normalidad.
- Hipótesis (Hypothesis): la predicción de que el estado estable se mantendrá tanto en el grupo experimental, en el que se inyectan fallos, como en el grupo de control, que se deja tal cual.
- Inyección de fallos (Fault Injection): provocar a propósito sucesos que podrían ocurrir en el mundo real, como la caída de un servidor o el corte de una conexión de red.
- Grupo de control y grupo experimental (Control Group and Experimental Group): se observa si aparece una diferencia en el estado estable de ambos grupos para comprobar si hay pruebas que refuten la hipótesis.
Lo característico de este experimento es que observa los resultados visibles desde fuera en lugar de revisar una por una las piezas internas del sistema. Cuanto más difícil es encontrar diferencias entre los dos grupos, mayor es la confianza en que el sistema soporta la turbulencia; y si se encuentra alguna, significa que se ha descubierto un punto débil que puede corregirse antes de que estalle una avería real.
3. Experimentos que crecieron hasta formar un ejército de monos
Cuando Chaos Monkey demostró su utilidad, Netflix fue creando herramientas dedicadas a distintos tipos de fallos y las llamó «Simian Army», es decir, el ejército de simios. El alcance de los experimentos también se amplió de un solo servidor a un centro de datos y, después, a una región entera.
(1) La lentitud también es un fallo
Latency Monkey añade a propósito retrasos en la comunicación entre servidores para simular que un servicio se vuelve lento. Si el retraso es muy largo, permite probar la misma situación que la caída de un servicio sin apagar realmente ningún servidor.
(2) Servidores que incumplen las normas y recursos sin uso
Conformity Monkey busca y apaga los servidores que no siguen las buenas prácticas, por ejemplo los que no pertenecen a un grupo de escalado automático, mientras que Janitor Monkey localiza y elimina los recursos que ya no se usan para mantener la nube ordenada.
(3) Apagar un centro de datos o una región entera
Chaos Gorilla simula la caída completa de una zona de disponibilidad (Availability Zone) de AWS, y Chaos Kong apaga una región (Region) entera. Trasladar el servicio de Netflix de una región a otra llevaba al principio unos 50 minutos, pero después se redujo a unos 6 minutos.
4. Principios para romper sistemas de forma segura
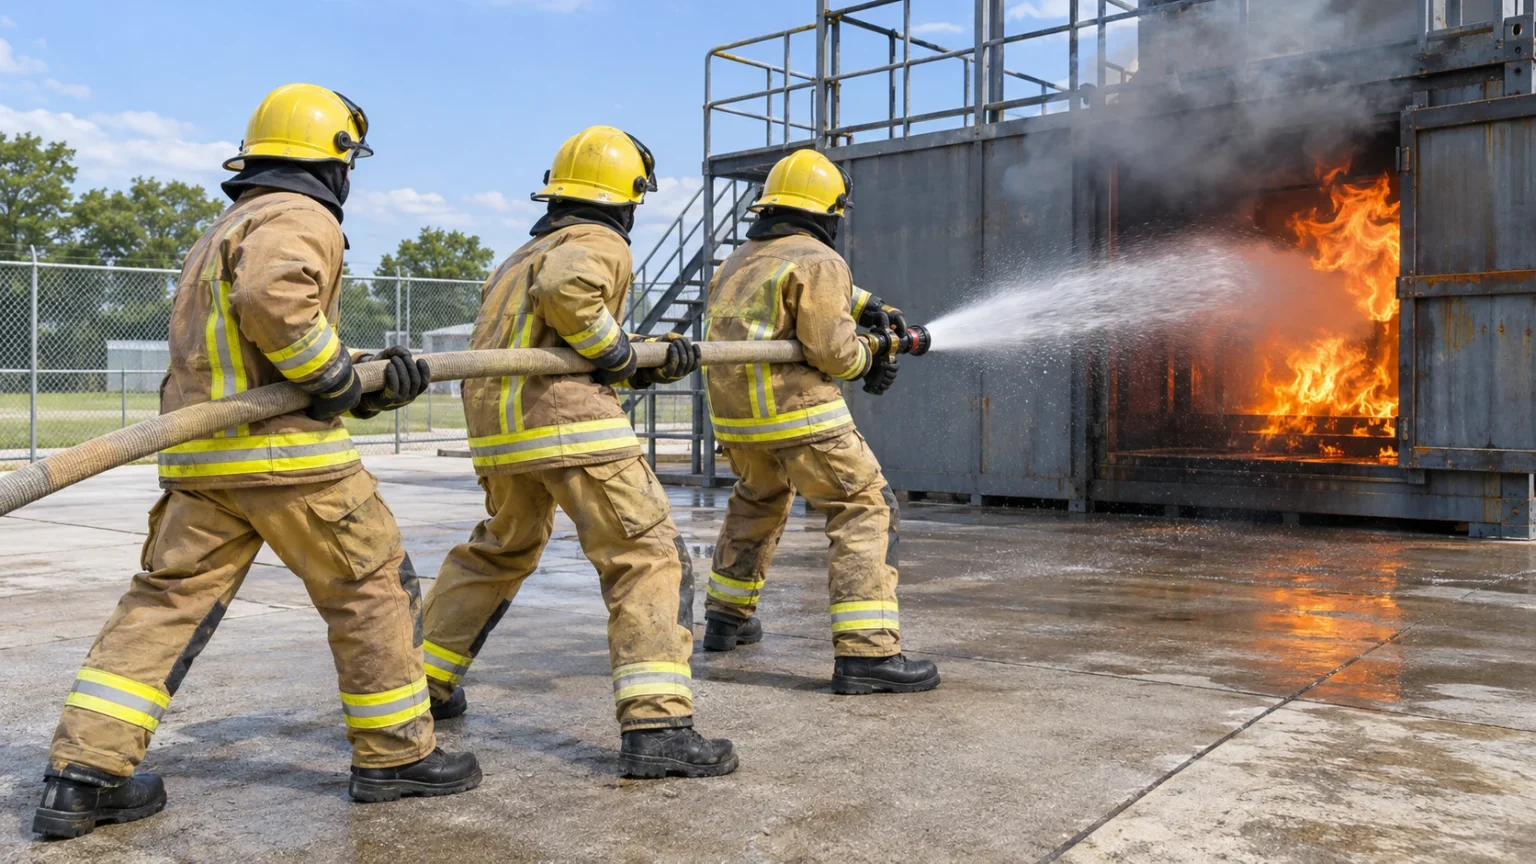
La idea de provocar fallos a propósito se parece a un simulacro de incendio. De hecho, en 2003 Jesse Robbins, de Amazon, se inspiró en la formación de los bomberos para crear el «Game Day», en el que se provocaban a propósito grandes fallos según un calendario fijo. Sin embargo, así como el fuego de un entrenamiento no debe extenderse fuera de la zona señalada, los experimentos de caos también tienen principios que hay que respetar.
(1) Minimizar el radio de explosión
Reducir al mínimo el daño que un experimento puede causar a los clientes se denomina ‘minimizar el radio de explosión (Blast Radius)’. Los experimentos empiezan en un ámbito pequeño, se amplían poco a poco si no surgen problemas y deben poder detenerse de inmediato en cuanto se observe algo anómalo.
(2) En producción y de forma automática
Como los sistemas se comportan de manera distinta según el entorno y el tráfico, los principios recomiendan experimentar en el entorno de producción real. Además, como los experimentos manuales son difíciles de mantener en el tiempo, piden automatizar tanto los experimentos como el análisis de sus resultados para repetirlos de forma continua.
(3) No solo fallos, también sucesos inesperados
Los experimentos abarcan no solo las averías de hardware y los errores de software, sino también sucesos que no son fallos, como un aumento repentino de las visitas. Se prueban en orden de prioridad, empezando por los que tendrían mayor impacto o los que pueden ocurrir con más frecuencia.
La ingeniería del caos parte menos de un esfuerzo por eliminar por completo los fallos que de una actitud que acepta que los fallos ocurrirán sin remedio y prefiere vivirlos por adelantado. Si los fallos son inevitables, mejor afrontarlos primero en el momento que elijamos nosotros: esa idea sencilla es el primer paso para entender la ingeniería del caos.