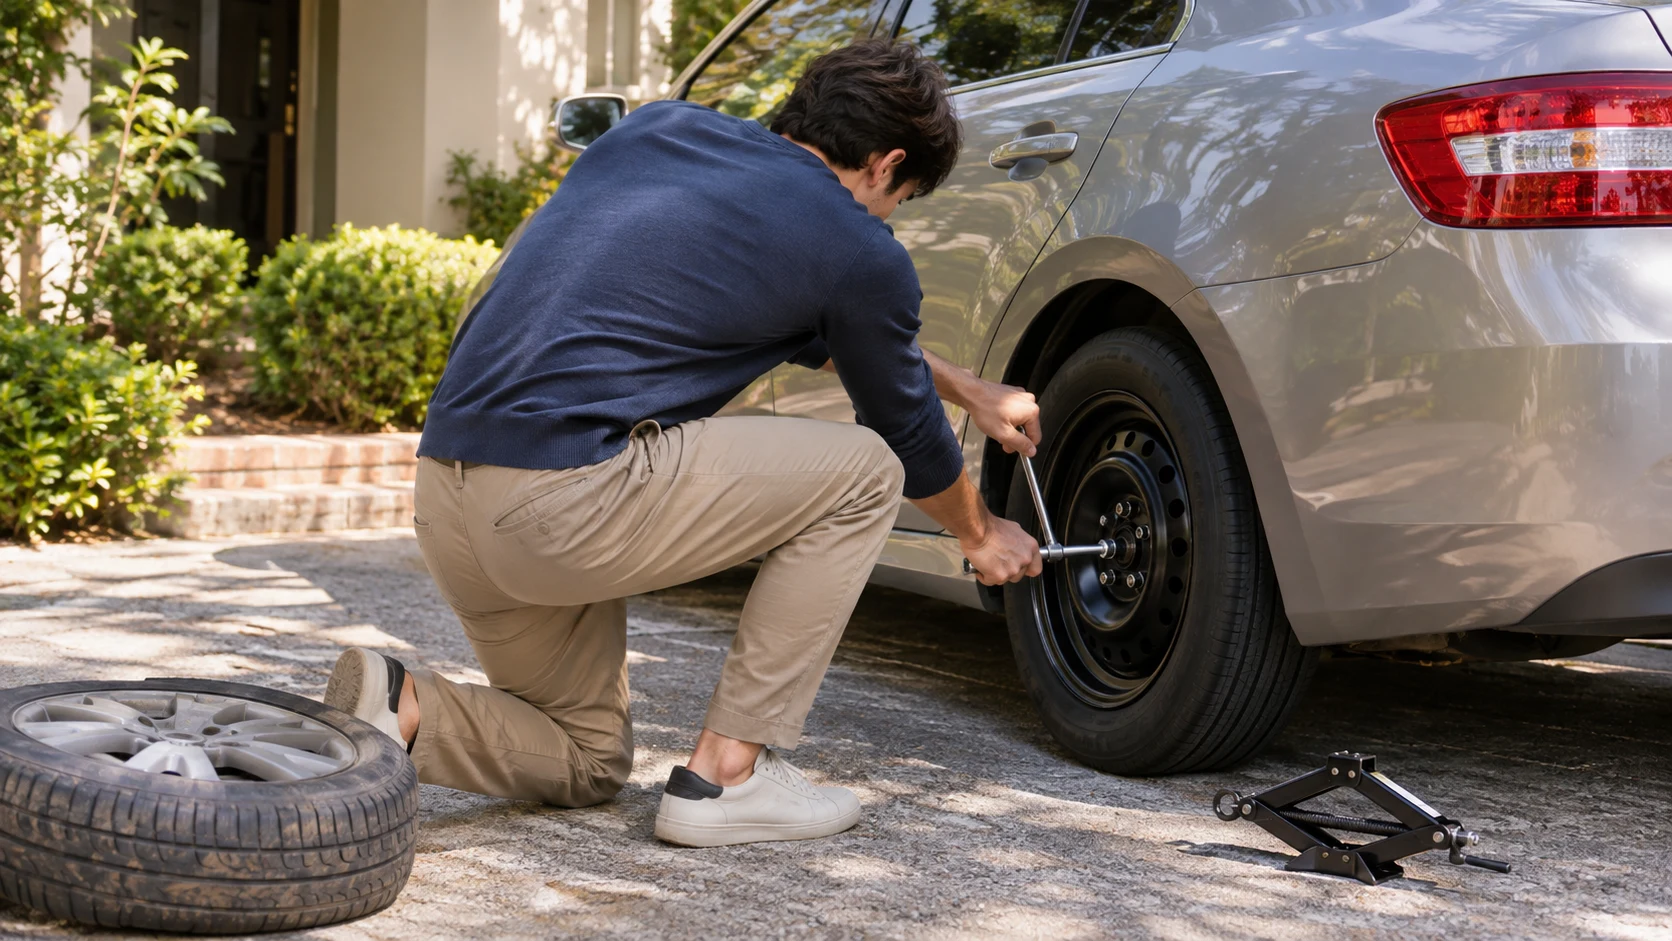
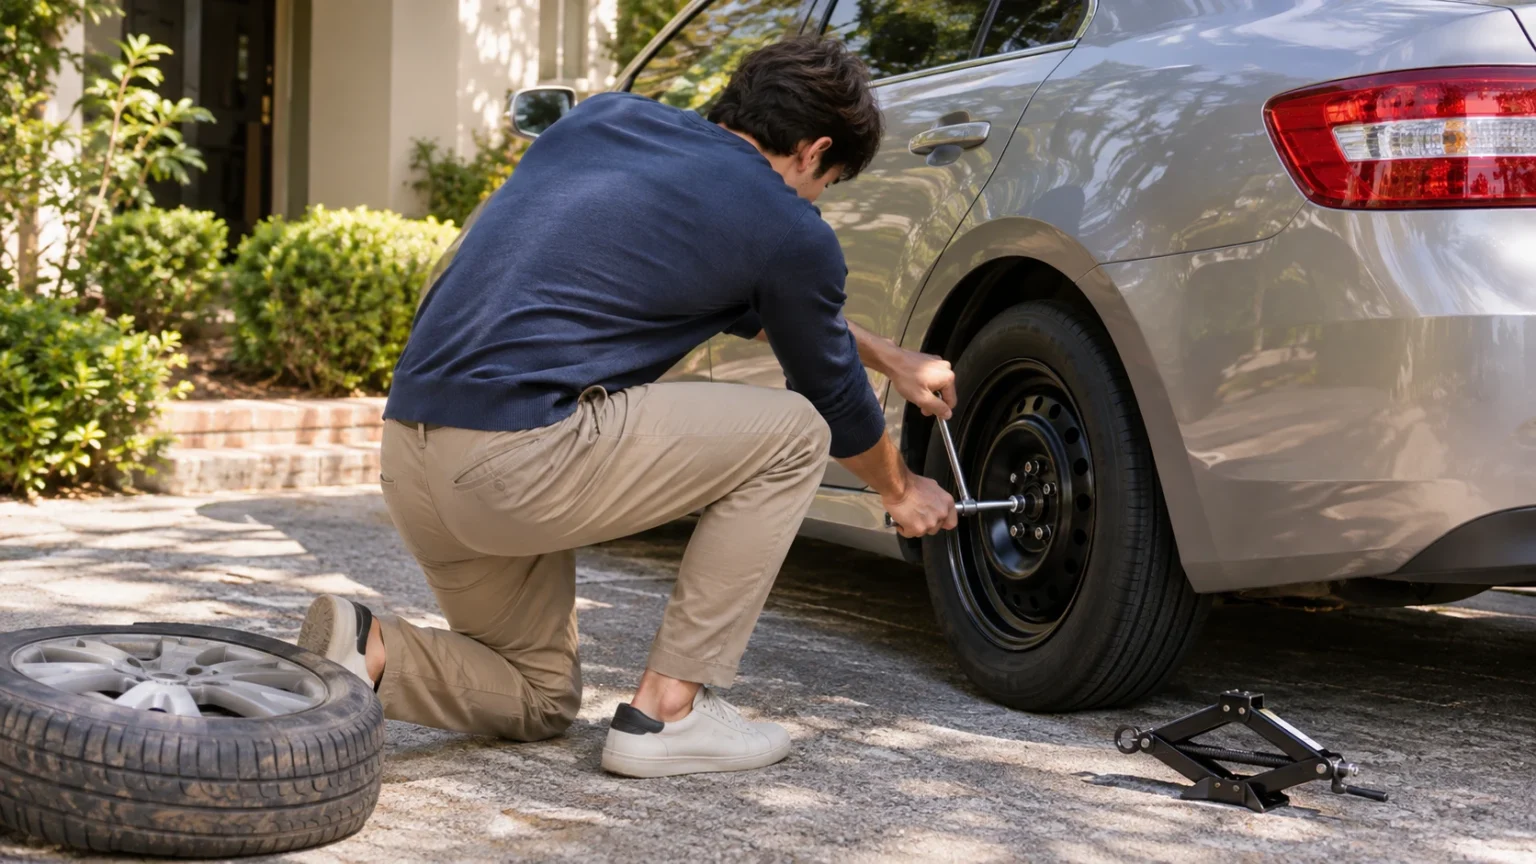
車のトランクにスペアタイヤが積んであれば、道でパンクしたときに本当にタイヤを交換できるでしょうか。一度もやったことがなければ、ジャッキをどこに掛ければよいのかさえ分からないはずです。無数のサーバーで動くインターネットサービスも同じで、予備の機器を備えておくことと、実際の故障の中で持ちこたえることはまったく別の問題です。そこで一部の企業は、正常に動いているサービスにわざと障害を起こしてみます。この方法を「カオスエンジニアリング(Chaos Engineering)」と呼びます。
カオスエンジニアリングとは、簡単に言えば「システムにわざと障害を起こす実験によって、予測しにくい混乱の中でもシステムが持ちこたえられるという確信を積み上げる方法」を意味します。この方法は2011年、クラウドへの移行を進めていたNetflix(ネットフリックス)が、実際にサービス中のサーバーを無作為に停止させるツールを紹介したことで広く知られるようになりました。
本資料では、Netflixがサーバールームに「サル」を放った理由、カオス実験がたどる4つのステップ、サルの軍団へと広がった実験の範囲、そしてシステムを安全に壊すための原則まで、順に見ていきます。
故障を待たずに先に起こしてみる工学
1. Netflixがサーバールームにサルを放った理由
2008年8月、Netflixは自社データセンターのデータベースが大きく破損する事故により、3日間DVDを発送できませんでした。これをきっかけにNetflixは同じ年からサービスをアマゾン ウェブ サービス(AWS)のクラウドへ移し始め、多数のサーバーの一部はいつでも故障しうるという前提でシステムを設計するようになりました。
(1) スペアタイヤだけでは足りない
2011年7月、Netflixの技術ブログは、スペアタイヤを持っているからといってパンクに対処できる保証はないと書きました。本当に備えるには家の前でわざとタイヤに穴を開けて交換する練習をする必要があり、現実には高くつくその練習も、クラウドならほとんどコストをかけずに自動で行えるというのです。
(2) カオスモンキーの登場
そうして作られたツールがカオスモンキー(Chaos Monkey)です。実際にサービス中のサーバーを無作為に選んで停止させ、それでも利用者が何の影響もなくサービスを使えるかを確かめます。名前はデータセンターに飛び込んだサルが機器を手当たり次第に壊す姿に由来し、2012年にはソースコードがApache 2.0ライセンスで公開されました。
(3) あえて業務時間に壊す
カオスモンキーは、エンジニアが見守る平日の業務時間に動きました。問題が起きてもすぐに対応できる時間帯に弱点を見つけ出し、次は人が手を出さなくても自動で復旧するように直すためでした。
2. カオス実験がたどる4つのステップ
カオスエンジニアリングはやみくもにサーバーを壊すことではなく、科学実験のように仮説を立てて検証するプロセスです。Netflixのエンジニアたちがまとめた「カオスエンジニアリングの原則(Principles of Chaos Engineering)」は、実験を次の4つのステップで説明しています。

- 定常状態(Steady State):スループット、エラー率、応答遅延のように、システムが普段正常に動いていることを示す測定可能な指標です。
- 仮説(Hypothesis):障害を注入した実験群とそのままにした対照群のどちらでも、定常状態がそのまま保たれるという予測です。
- 障害注入(Fault Injection):サーバーが停止したりネットワーク接続が切れたりするなど、現実に起こりうる出来事をわざと作り出すことです。
- 対照群と実験群(Control Group and Experimental Group):2つのグループの定常状態に差が生じるかを調べ、仮説を覆す証拠があるかを確認します。
この実験は、システム内部を一つひとつ調べる代わりに、外から見える結果を観察する点が特徴です。2つのグループの差が見つからないほど、システムが混乱に耐えられるという確信は強まり、差が見つかれば、本物の障害が起きる前に直すべき弱点を発見したことになります。
3. サルの軍団へと広がった実験
カオスモンキーが成果を上げると、Netflixはさまざまな種類の障害を受け持つツールを次々に作り、それらを「シミアンアーミー(Simian Army)」、つまりサルの軍団と呼びました。実験の範囲もサーバー1台からデータセンター、さらには地域全体へと広がりました。
(1) 遅くなるのも障害
レイテンシーモンキー(Latency Monkey)は、サーバー間の通信にわざと遅延を加え、サービスが遅くなる状況を再現します。遅延をとても長くすれば、実際にサーバーを止めなくても、サービスが止まったのと同じ状況を試すことができます。
(2) ルール違反のサーバーと使われていない資源の整理
コンフォーミティモンキー(Conformity Monkey)は、オートスケーリンググループに属していないなどベストプラクティスに反するサーバーを見つけて停止させ、ジャニターモンキー(Janitor Monkey)は使われていない資源を見つけて片づけ、クラウドをきれいに保ちます。
(3) データセンターや地域全体を止める実験
カオスゴリラ(Chaos Gorilla)はAWSのアベイラビリティーゾーン(Availability Zone)1つが丸ごと止まった状況を再現し、カオスコング(Chaos Kong)はリージョン(Region)全体を止めます。Netflixがある地域のサービスを別の地域へ切り替えるには、当初約50分かかりましたが、のちに約6分まで短くなりました。
4. システムを安全に壊すための原則
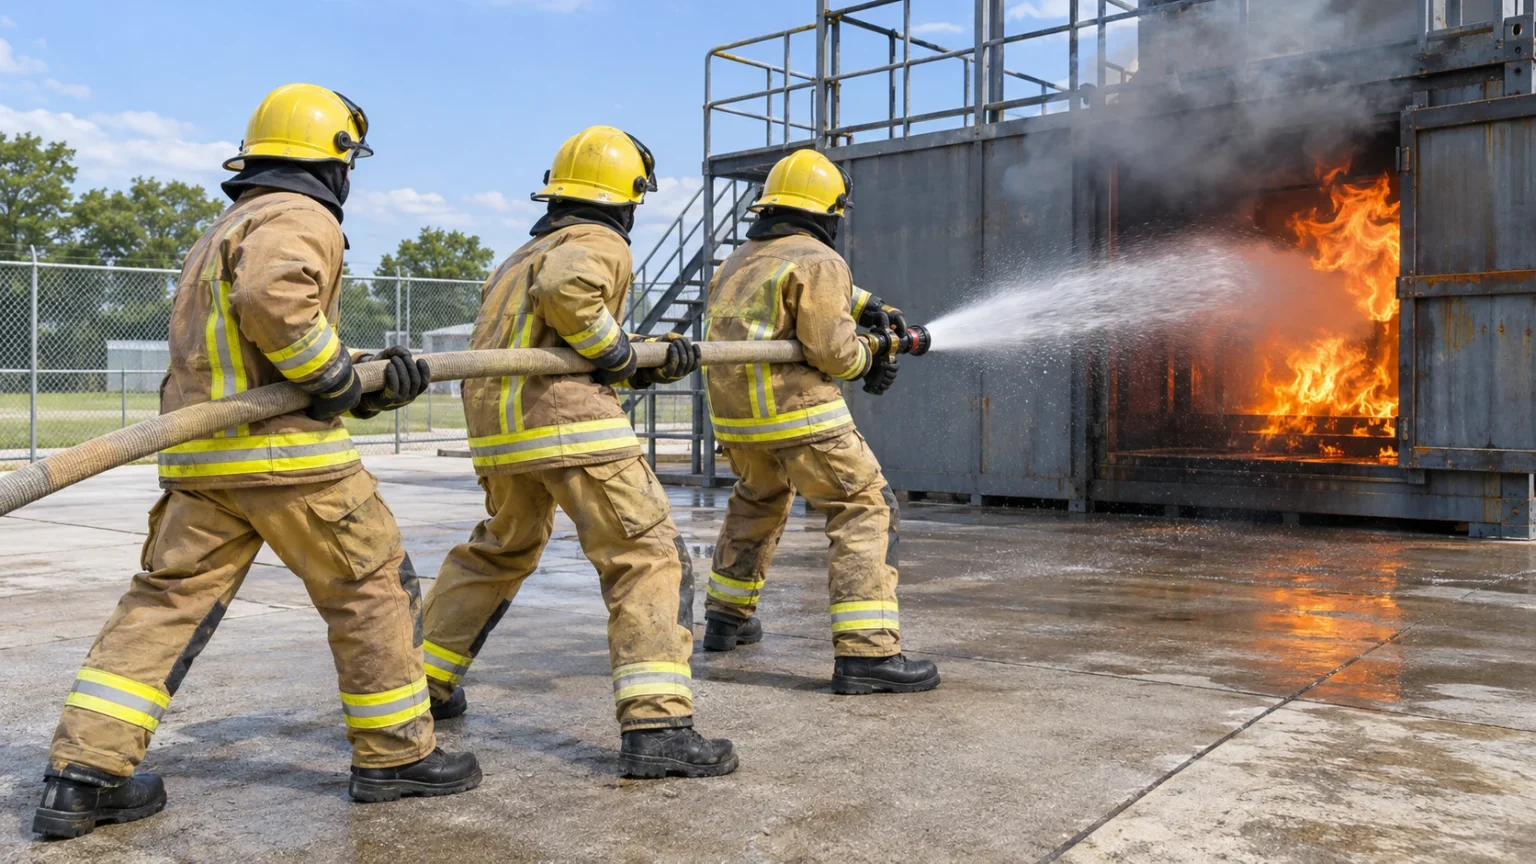
わざと故障を起こすという発想は消防訓練に似ています。実際、2003年にアマゾンのジェシー・ロビンス(Jesse Robbins)は消防士の訓練から着想を得て、決まった日程でわざと大きな障害を起こす「ゲームデー(Game Day)」を作りました。ただし、訓練用の火が決められた区域の外へ燃え広がってはならないように、カオス実験にも守るべき原則があります。
(1) 爆発半径を最小にする
実験が利用者に与えうる被害をできるだけ小さく抑えることを「爆発半径(Blast Radius)を最小化する」と言います。小さな範囲から始めて問題がなければ少しずつ広げ、異常が見えたらすぐに実験を止められなければなりません。
(2) 本番環境で、自動で
システムは環境やトラフィックによって振る舞いが変わるため、原則は実際の本番環境で実験することを勧めています。また、人の手で行う実験は長く続けにくいので、実験と結果の分析を自動化して継続的に繰り返すよう求めています。
(3) 故障だけでなく思いがけない出来事まで
ハードウェアの故障やソフトウェアのエラーだけでなく、アクセスが急に押し寄せるような故障ではない出来事も実験の対象です。影響が大きいものや起こりやすいものから優先順位を決めて試します。
カオスエンジニアリングは、障害をなくそうとする努力というより、障害は必ず起こるという事実を受け入れ、前もって経験しておこうとする姿勢から出発します。故障は避けられないのだから、いっそ自分たちが選んだ時間に先に経験しておこうという単純な考え、それがカオスエンジニアリングを理解する第一歩です。