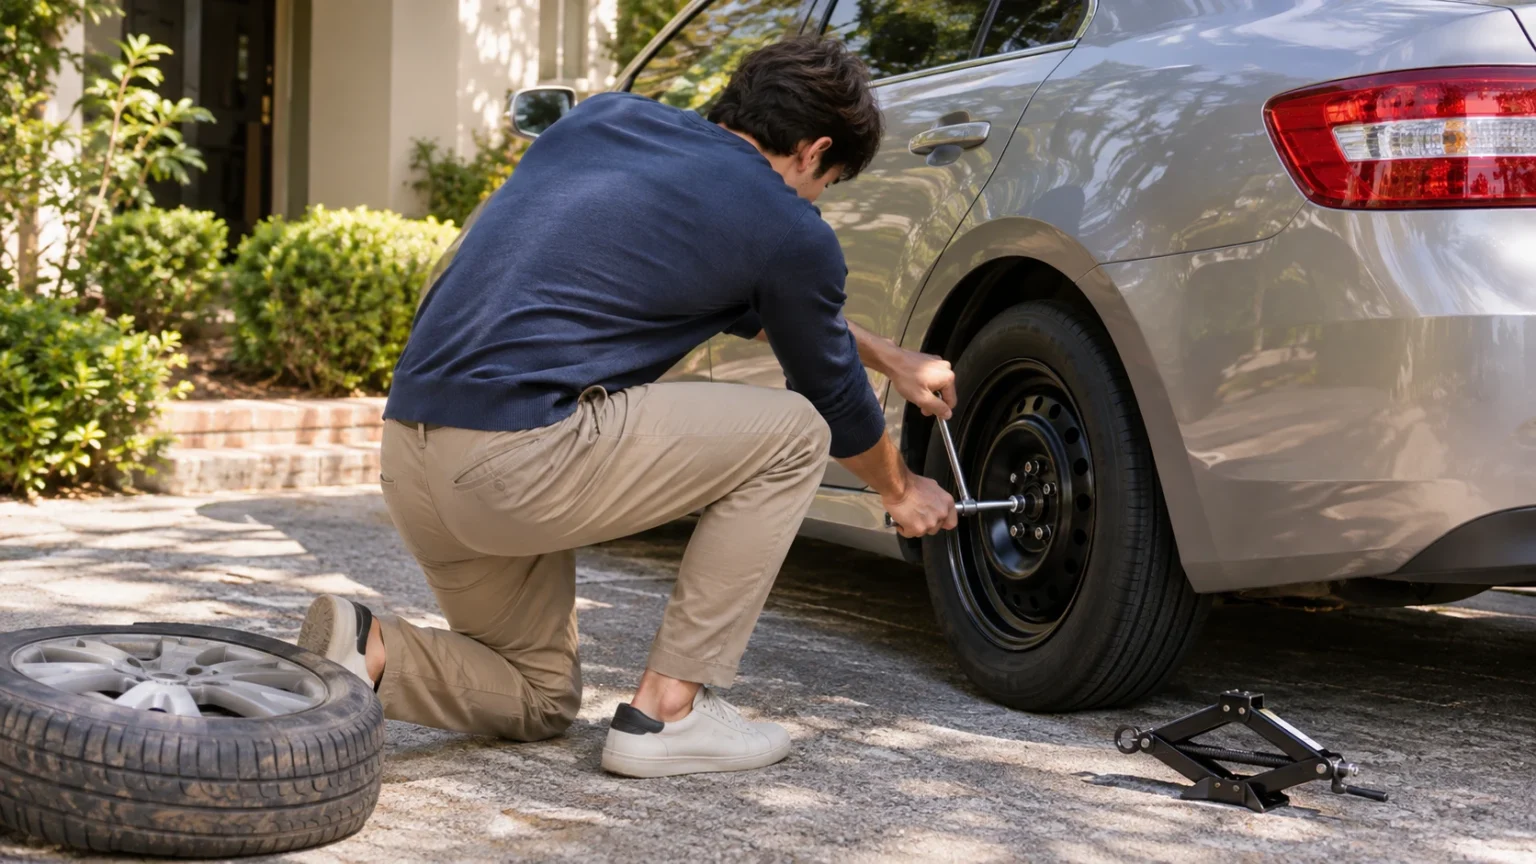
后备箱里放着备胎,就代表路上爆胎时真的能自己换轮胎吗?如果从来没换过,恐怕连千斤顶该顶在哪里都不知道。依靠无数台服务器运转的互联网服务也是如此:备好备用设备,和在真实故障中撑下来,完全是两回事。因此,有些企业会故意让运行良好的服务出故障,这种方法被称为“混沌工程(Chaos Engineering)”。
简单来说,混沌工程是指“通过故意在系统中制造故障的实验,积累对系统能够在难以预测的混乱中撑住的信心的方法”。2011年,正在向云端迁移的Netflix介绍了一种随机关闭正在为真实用户服务的服务器的工具,这种方法由此广为人知。
本文将依次介绍Netflix为什么在机房里放出“猴子”、混沌实验要经过的四个步骤、扩大成猴子军团的实验范围,以及安全地“破坏”系统需要遵守的原则。
不等故障发生,先动手制造故障的工程学
1. Netflix为什么在机房里放出猴子
2008年8月,Netflix自有数据中心的数据库严重损坏,导致公司三天无法寄出DVD。以此为契机,Netflix从同一年开始把服务迁移到亚马逊网络服务(AWS)的云上,并以“众多服务器中总有一部分随时可能出故障”为前提来设计系统。
(1) 光有备胎还不够
2011年7月,Netflix技术博客写道,拥有备胎并不能保证你能应付爆胎。真正要做好准备,就得在自家门前故意把轮胎扎破,再练习换胎;这种练习在现实中代价很高,在云上却几乎可以零成本地自动进行。
(2) 混沌猴子登场
为此打造的工具就是混沌猴子(Chaos Monkey)。它随机挑选正在为真实用户服务的服务器并将其关闭,然后确认用户是否仍能不受影响地使用服务。这个名字来自一只闯进数据中心、胡乱破坏设备的猴子形象;2012年,它的源代码以Apache 2.0许可证公开。
(3) 故意在上班时间制造故障
混沌猴子在工程师值守的工作日上班时间运行。这样做是为了在出问题时能立刻应对的时段找出弱点,并加以修改,让系统下次无需人工干预也能自动恢复。
2. 混沌实验的四个步骤
混沌工程并不是盲目地破坏服务器,而是像科学实验一样提出假设并加以验证的过程。Netflix工程师整理的《混沌工程原则》(Principles of Chaos Engineering)用以下四个步骤来说明实验。
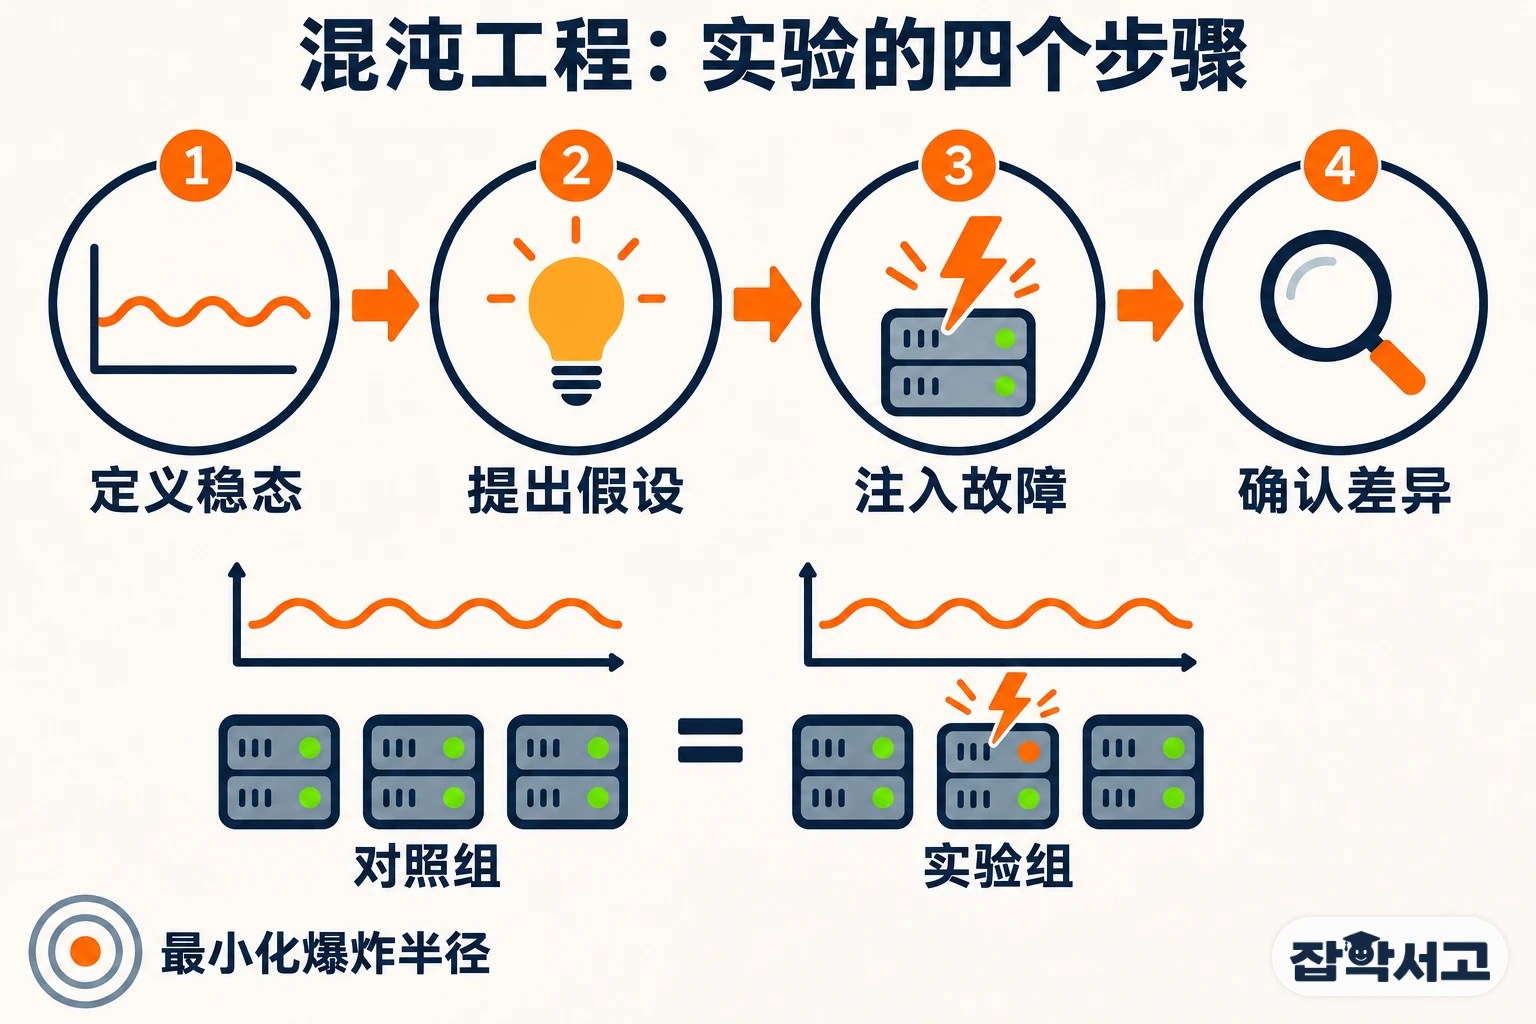
- 稳态(Steady State):吞吐量、错误率、响应延迟等能表明系统平时运转正常的可测量指标。
- 假设(Hypothesis):预测在注入故障的实验组和保持原样的对照组中,稳态都会继续维持。
- 故障注入(Fault Injection):故意制造服务器宕机、网络连接中断等现实中可能发生的事件。
- 对照组与实验组(Control Group and Experimental Group):观察两组的稳态是否出现差异,确认是否有推翻假设的证据。
这种实验的特点是不逐一检查系统内部,而是观察外部表现出来的结果。两组之间越找不到差异,对系统能经受混乱的信心就越大;如果发现了差异,就等于在真正的故障爆发之前找到了需要修复的弱点。
3. 扩大成猴子军团的实验
混沌猴子取得成效后,Netflix陆续开发了负责各种故障的工具,并称之为“猿猴军团(Simian Army)”。实验范围也从一台服务器扩大到数据中心,进而扩大到整个地区。
(1) 变慢也是故障
延迟猴子(Latency Monkey)故意在服务器之间的通信中加入延迟,模拟服务变慢的情况。把延迟设得很长,就能在不真正关闭服务器的情况下,测试与服务停止相同的状况。
(2) 清理违规服务器和闲置资源
一致性猴子(Conformity Monkey)找出不属于自动伸缩组等违反最佳实践的服务器并将其关闭,看门人猴子(Janitor Monkey)则找出不再使用的资源加以清理,让云环境保持整洁。
(3) 关闭数据中心乃至整个地区的实验
混沌大猩猩(Chaos Gorilla)模拟AWS一个可用区(Availability Zone)整体停摆的情况,混沌金刚(Chaos Kong)则关闭整个区域(Region)。Netflix把一个地区的服务转移到另一个地区,起初大约需要50分钟,后来缩短到大约6分钟。
4. 安全“破坏”系统的原则
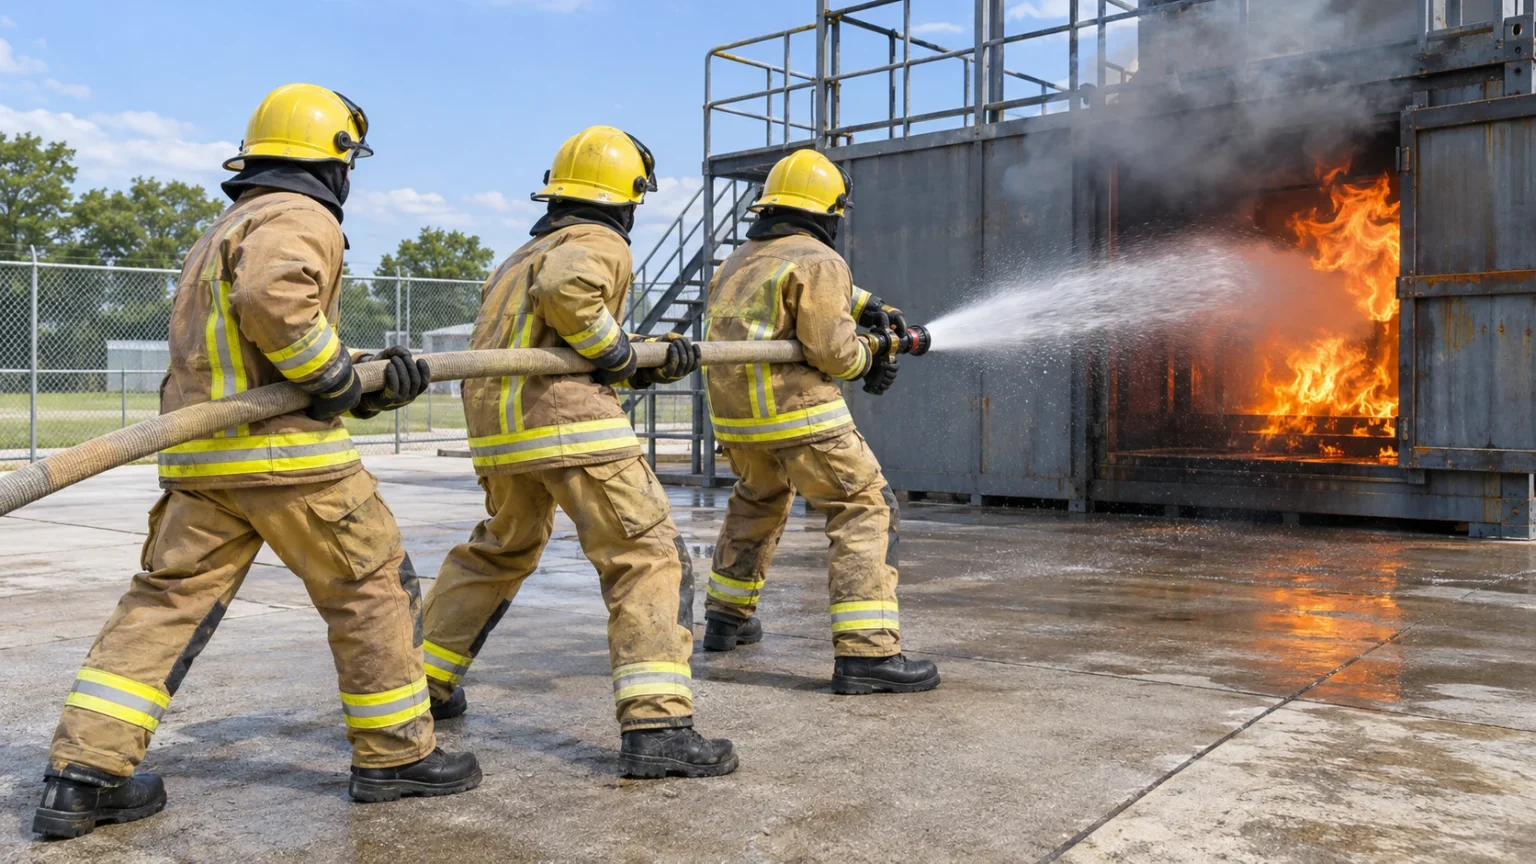
故意制造故障的想法与消防演练很相似。事实上,2003年亚马逊的杰西·罗宾斯(Jesse Robbins)从消防员训练中获得灵感,设立了按既定日程故意引发重大故障的“游戏日(Game Day)”。不过,正如训练用的火不能蔓延到指定区域之外,混沌实验也有必须遵守的原则。
(1) 最小化爆炸半径
把实验可能给用户带来的损害降到最低,被称为“最小化爆炸半径(Blast Radius)”。实验要从小范围开始,确认没有问题后再逐步扩大,一旦发现异常就必须能立即停止。
(2) 在真实的生产环境中自动进行
系统会因环境和流量不同而表现不同,因此这些原则建议在真实的生产环境中进行实验。此外,人工进行的实验难以长期坚持,所以还主张把实验和结果分析自动化,持续反复进行。
(3) 不只是故障,还有意外事件
实验对象不仅包括硬件故障和软件错误,还包括访问量突然激增这类并非故障的事件。要根据影响大小或发生频率来确定优先顺序,依次测试。
混沌工程与其说是要彻底消除故障的努力,不如说是源于接受“故障必然会发生”这一事实、并提前去经历它的态度。既然故障无法避免,不如在我们选定的时间先经历一遍——这个简单的想法,正是理解混沌工程的第一步。