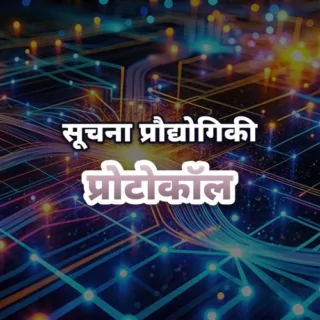
क्या गाड़ी की डिक्की में स्टेपनी रखी होने भर से सड़क पर टायर पंचर होने पर आप सचमुच पहिया बदल पाएँगे? अगर आपने यह कभी किया ही नहीं, तो शायद यह भी न पता हो कि जैक कहाँ लगाना है। अनगिनत सर्वरों पर चलने वाली इंटरनेट सेवाओं के साथ भी ऐसा ही है: बैकअप उपकरण तैयार रखना और असली खराबी के बीच टिके रहना, दोनों बिल्कुल अलग बातें हैं। इसीलिए कुछ कंपनियाँ ठीक-ठाक चल रही सेवाओं में जानबूझकर खराबी पैदा करके देखती हैं, और इस तरीके को ‘कैओस इंजीनियरिंग (Chaos Engineering)’ कहा जाता है।
आसान शब्दों में, कैओस इंजीनियरिंग का अर्थ है ‘सिस्टम में जानबूझकर खराबी पैदा करने वाले प्रयोगों के ज़रिए यह भरोसा बनाना कि अनिश्चित उथल-पुथल के बीच भी सिस्टम टिका रह सकता है’। यह तरीका 2011 में तब व्यापक रूप से जाना गया, जब क्लाउड की ओर बढ़ रही नेटफ़्लिक्स (Netflix) ने असली ग्राहकों को सेवा दे रहे सर्वरों को बेतरतीब ढंग से बंद करने वाला एक टूल पेश किया।
इस लेख में हम क्रम से देखेंगे कि नेटफ़्लिक्स ने अपने सर्वर रूम में ‘बंदर’ क्यों छोड़ा, कैओस प्रयोग किन चार चरणों से गुज़रता है, प्रयोगों का दायरा कैसे बंदरों की पूरी सेना तक फैल गया, और सिस्टम को सुरक्षित ढंग से तोड़ने के सिद्धांत क्या हैं।
खराबी का इंतज़ार करने के बजाय पहले खुद पैदा करने वाली इंजीनियरिंग
1. नेटफ़्लिक्स ने सर्वर रूम में बंदर क्यों छोड़ा
अगस्त 2008 में नेटफ़्लिक्स के अपने डेटा सेंटर का डेटाबेस बुरी तरह खराब हो गया, जिससे कंपनी तीन दिन तक DVD नहीं भेज सकी। इसी घटना के बाद नेटफ़्लिक्स ने उसी साल से अपनी सेवा को अमेज़न वेब सर्विसेज़ (AWS) के क्लाउड पर ले जाना शुरू किया और यह मानकर सिस्टम डिज़ाइन करने लगी कि बहुत सारे सर्वरों में से कुछ कभी भी खराब हो सकते हैं।
(1) सिर्फ़ स्टेपनी काफ़ी नहीं
जुलाई 2011 में नेटफ़्लिक्स के टेक ब्लॉग ने लिखा कि स्टेपनी होने से यह गारंटी नहीं मिलती कि आप पंचर से निपट लेंगे। सचमुच तैयार रहने के लिए घर के सामने जानबूझकर टायर में छेद करके उसे बदलने का अभ्यास करना होगा; असल ज़िंदगी में महँगा पड़ने वाला यह अभ्यास क्लाउड में लगभग बिना खर्च के अपने-आप किया जा सकता है।
(2) कैओस मंकी का आगमन
इसी के लिए बनाया गया टूल था कैओस मंकी (Chaos Monkey)। यह असली ग्राहकों को सेवा दे रहे सर्वरों में से कुछ को बेतरतीब ढंग से चुनकर बंद कर देता है और फिर जाँचता है कि ग्राहक बिना किसी असर के सेवा इस्तेमाल कर पा रहे हैं या नहीं। इसका नाम डेटा सेंटर में घुसकर उपकरणों को मनमाने ढंग से तोड़ते बंदर की छवि से आया है, और 2012 में इसका सोर्स कोड Apache 2.0 लाइसेंस के तहत सार्वजनिक किया गया।
(3) जानबूझकर काम के घंटों में खराबी
कैओस मंकी हफ़्ते के कामकाजी दिनों में उन घंटों में चलता था जब इंजीनियर निगरानी कर रहे होते थे। मकसद यह था कि समस्या आने पर तुरंत संभाले जा सकने वाले समय में कमज़ोरियाँ ढूँढी जाएँ, और उन्हें ऐसे सुधारा जाए कि अगली बार इंसान के दखल के बिना सिस्टम अपने-आप ठीक हो जाए।
2. कैओस प्रयोग के चार चरण
कैओस इंजीनियरिंग अंधाधुंध सर्वर तोड़ना नहीं है, बल्कि वैज्ञानिक प्रयोग की तरह परिकल्पना बनाकर उसे परखने की प्रक्रिया है। नेटफ़्लिक्स के इंजीनियरों द्वारा तैयार ‘कैओस इंजीनियरिंग के सिद्धांत (Principles of Chaos Engineering)’ प्रयोग को नीचे दिए चार चरणों में समझाते हैं।
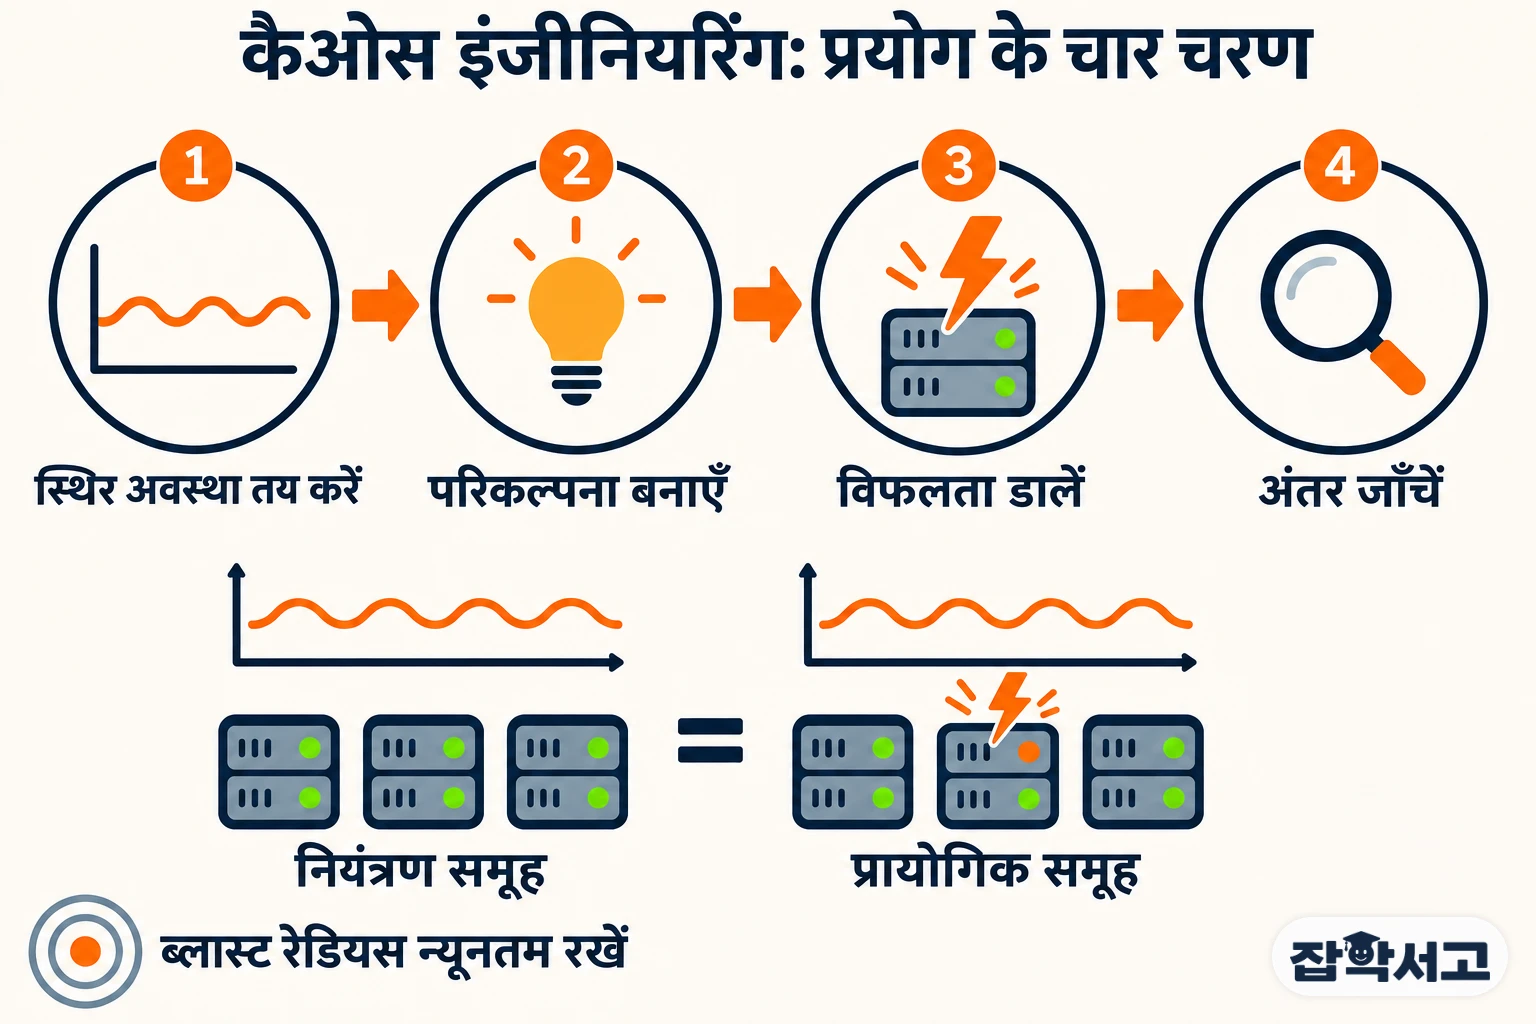
- स्थिर अवस्था (Steady State): थ्रूपुट, त्रुटि दर या प्रतिक्रिया में देरी जैसे मापे जा सकने वाले संकेतक, जो बताते हैं कि सिस्टम सामान्य रूप से ठीक चल रहा है।
- परिकल्पना (Hypothesis): यह अनुमान कि खराबी डाले गए प्रायोगिक समूह और जस-के-तस छोड़े गए नियंत्रण समूह, दोनों में स्थिर अवस्था बनी रहेगी।
- फ़ॉल्ट इंजेक्शन (Fault Injection): सर्वर बंद हो जाना या नेटवर्क कनेक्शन कट जाना जैसी असल में हो सकने वाली घटनाओं को जानबूझकर पैदा करना।
- नियंत्रण समूह और प्रायोगिक समूह (Control Group and Experimental Group): दोनों समूहों की स्थिर अवस्था में अंतर आता है या नहीं, यह देखकर जाँचना कि परिकल्पना को गलत साबित करने वाला कोई सबूत है या नहीं।
इस प्रयोग की खासियत यह है कि इसमें सिस्टम के भीतर हर हिस्से को टटोलने के बजाय बाहर दिखने वाले नतीजों पर नज़र रखी जाती है। दोनों समूहों में अंतर जितना कम मिलता है, यह भरोसा उतना बढ़ता है कि सिस्टम उथल-पुथल झेल सकता है; और अगर अंतर मिल जाए, तो समझिए असली खराबी आने से पहले ही सुधारने लायक एक कमज़ोरी पकड़ में आ गई।
3. बंदरों की सेना तक फैले प्रयोग
कैओस मंकी के सफल होने के बाद नेटफ़्लिक्स ने अलग-अलग तरह की खराबियों के लिए एक के बाद एक टूल बनाए और उन्हें ‘सिमियन आर्मी (Simian Army)’, यानी बंदरों की सेना कहा। प्रयोगों का दायरा भी एक सर्वर से बढ़कर डेटा सेंटर और फिर पूरे क्षेत्र तक फैल गया।
(1) धीमा होना भी खराबी है
लेटेंसी मंकी (Latency Monkey) सर्वरों के बीच के संचार में जानबूझकर देरी डालकर सेवा के धीमे होने की स्थिति की नकल करता है। देरी बहुत लंबी कर दी जाए, तो किसी सर्वर को सचमुच बंद किए बिना ही सेवा ठप होने जैसी स्थिति परखी जा सकती है।
(2) नियम तोड़ने वाले सर्वर और बेकार संसाधनों की सफ़ाई
कन्फ़ॉर्मिटी मंकी (Conformity Monkey) ऑटो-स्केलिंग समूह में शामिल न होने जैसे सर्वोत्तम तरीकों का उल्लंघन करने वाले सर्वरों को ढूँढकर बंद करता है, और जैनिटर मंकी (Janitor Monkey) इस्तेमाल न हो रहे संसाधनों को ढूँढकर हटाता है ताकि क्लाउड साफ़-सुथरा रहे।
(3) पूरा डेटा सेंटर और पूरा क्षेत्र बंद करने वाले प्रयोग
कैओस गोरिल्ला (Chaos Gorilla) AWS के एक पूरे उपलब्धता क्षेत्र (Availability Zone) के ठप होने की स्थिति की नकल करता है, जबकि कैओस कॉन्ग (Chaos Kong) पूरे रीजन (Region) को बंद कर देता है। नेटफ़्लिक्स को एक क्षेत्र की सेवा दूसरे क्षेत्र में ले जाने में शुरू में लगभग 50 मिनट लगते थे, जो बाद में घटकर लगभग 6 मिनट रह गए।
4. सिस्टम को सुरक्षित ढंग से तोड़ने के सिद्धांत
जानबूझकर खराबी पैदा करने का विचार अग्नि-सुरक्षा अभ्यास से मिलता-जुलता है। दरअसल, 2003 में अमेज़न के जेसी रॉबिन्स (Jesse Robbins) ने दमकलकर्मियों के प्रशिक्षण से प्रेरणा लेकर ‘गेम डे (Game Day)’ शुरू किया, जिसमें तय कार्यक्रम के अनुसार जानबूझकर बड़ी खराबियाँ पैदा की जाती थीं। लेकिन जैसे अभ्यास की आग तय दायरे से बाहर नहीं फैलनी चाहिए, वैसे ही कैओस प्रयोगों के भी कुछ ज़रूरी सिद्धांत हैं।
(1) ब्लास्ट रेडियस को न्यूनतम रखें
प्रयोग से ग्राहकों को होने वाले संभावित नुकसान को कम से कम रखने को ‘ब्लास्ट रेडियस (Blast Radius) को न्यूनतम रखना’ कहा जाता है। प्रयोग छोटे दायरे से शुरू होते हैं, कोई समस्या न हो तो धीरे-धीरे बढ़ाए जाते हैं, और कुछ भी गड़बड़ दिखते ही उन्हें तुरंत रोका जा सकना चाहिए।
(2) असली प्रोडक्शन माहौल में, अपने-आप
सिस्टम अपने माहौल और ट्रैफ़िक के हिसाब से अलग-अलग व्यवहार करता है, इसलिए ये सिद्धांत असली प्रोडक्शन माहौल में प्रयोग करने की सलाह देते हैं। साथ ही, हाथ से किए जाने वाले प्रयोग लंबे समय तक जारी रखना मुश्किल होता है, इसलिए प्रयोगों और उनके नतीजों के विश्लेषण को स्वचालित करके लगातार दोहराने को कहा जाता है।
(3) सिर्फ़ खराबी नहीं, अनपेक्षित घटनाएँ भी
प्रयोग में सिर्फ़ हार्डवेयर की खराबी और सॉफ़्टवेयर की त्रुटियाँ ही नहीं, बल्कि अचानक ट्रैफ़िक बढ़ जाने जैसी वे घटनाएँ भी शामिल हैं जो खराबी नहीं हैं। जिनका असर बड़ा हो या जो अक्सर हो सकती हों, उन्हें प्राथमिकता देकर पहले परखा जाता है।
कैओस इंजीनियरिंग खराबियों को पूरी तरह मिटाने की कोशिश से ज़्यादा इस सोच से शुरू होती है कि खराबी तो होकर रहेगी, इसलिए उसे पहले ही अनुभव कर लिया जाए। खराबी से बचा नहीं जा सकता, तो क्यों न उसे अपने चुने हुए समय पर पहले ही झेल लिया जाए, यही सीधा-सा विचार कैओस इंजीनियरिंग को समझने का पहला कदम है।