Si abres un libro y cuentas las palabras una por una, aparece una distribución curiosa. Unas pocas palabras, como «y», «haber» y «cosa», aparecen sin cesar en cada página, mientras que la mayoría solo aparece una o dos veces en todo el libro y luego desaparece. Esta concentración sigue una proporción sorprendentemente regular. Esta regla se conoce como «ley de Zipf (Zipf's Law)».
Dicho de forma sencilla, la ley de Zipf es una ley empírica según la cual, si ordenamos las palabras de mayor a menor frecuencia, el número de veces que se usa cada palabra es inversamente proporcional al puesto que ocupa. Junto con las leyes de Bradford y de Lotka, se considera una de las 3 grandes leyes de la bibliometría y sirve de base a los motores de búsqueda y las técnicas de indización actuales.
Veremos cómo se dio a conocer la ley de Zipf, en qué consiste, cómo se explican sus causas y cuáles son sus aplicaciones y sus límites en las bibliotecas y en la recuperación de información.
El orden de las palabras según la ley de Zipf
¿Qué es la ley de Zipf?

Esta ley debe su nombre al lingüista estadounidense George Kingsley Zipf. En la década de 1930, mientras enseñaba alemán en la Universidad de Harvard, contó cuántas veces aparecían las palabras en textos de varios idiomas y formuló la sencilla relación entre el rango y la frecuencia.
El estenógrafo francés Jean-Baptiste Estoup ya había documentado el mismo fenómeno en 1916, y el propio Zipf reconoció que Estoup se le había adelantado. La regla lleva hasta hoy el nombre de Zipf porque fue él quien la dio a conocer al extender su estudio a distintos idiomas y campos.
En 1949, Zipf extendió esta idea al comportamiento humano en general en su libro «El comportamiento humano y el principio del mínimo esfuerzo (Human Behavior and the Principle of Least Effort)».
La regla se observa también fuera del lenguaje. En 1913, el físico alemán Felix Auerbach fue el primero en observar que, si se ordenan las ciudades por población, esta es inversamente proporcional al puesto que ocupa cada ciudad. Más adelante se encontró un patrón similar en otros datos, como el tamaño de las empresas y la frecuencia de las notas musicales.
Proporcionalidad inversa entre el rango y la frecuencia

La ley de Zipf se puede expresar mediante una proporción muy sencilla. Si tomamos como referencia el número de apariciones de la palabra más usada, la frecuencia de cada una de las demás se aproxima al resultado de dividir ese número por el puesto que ocupa.
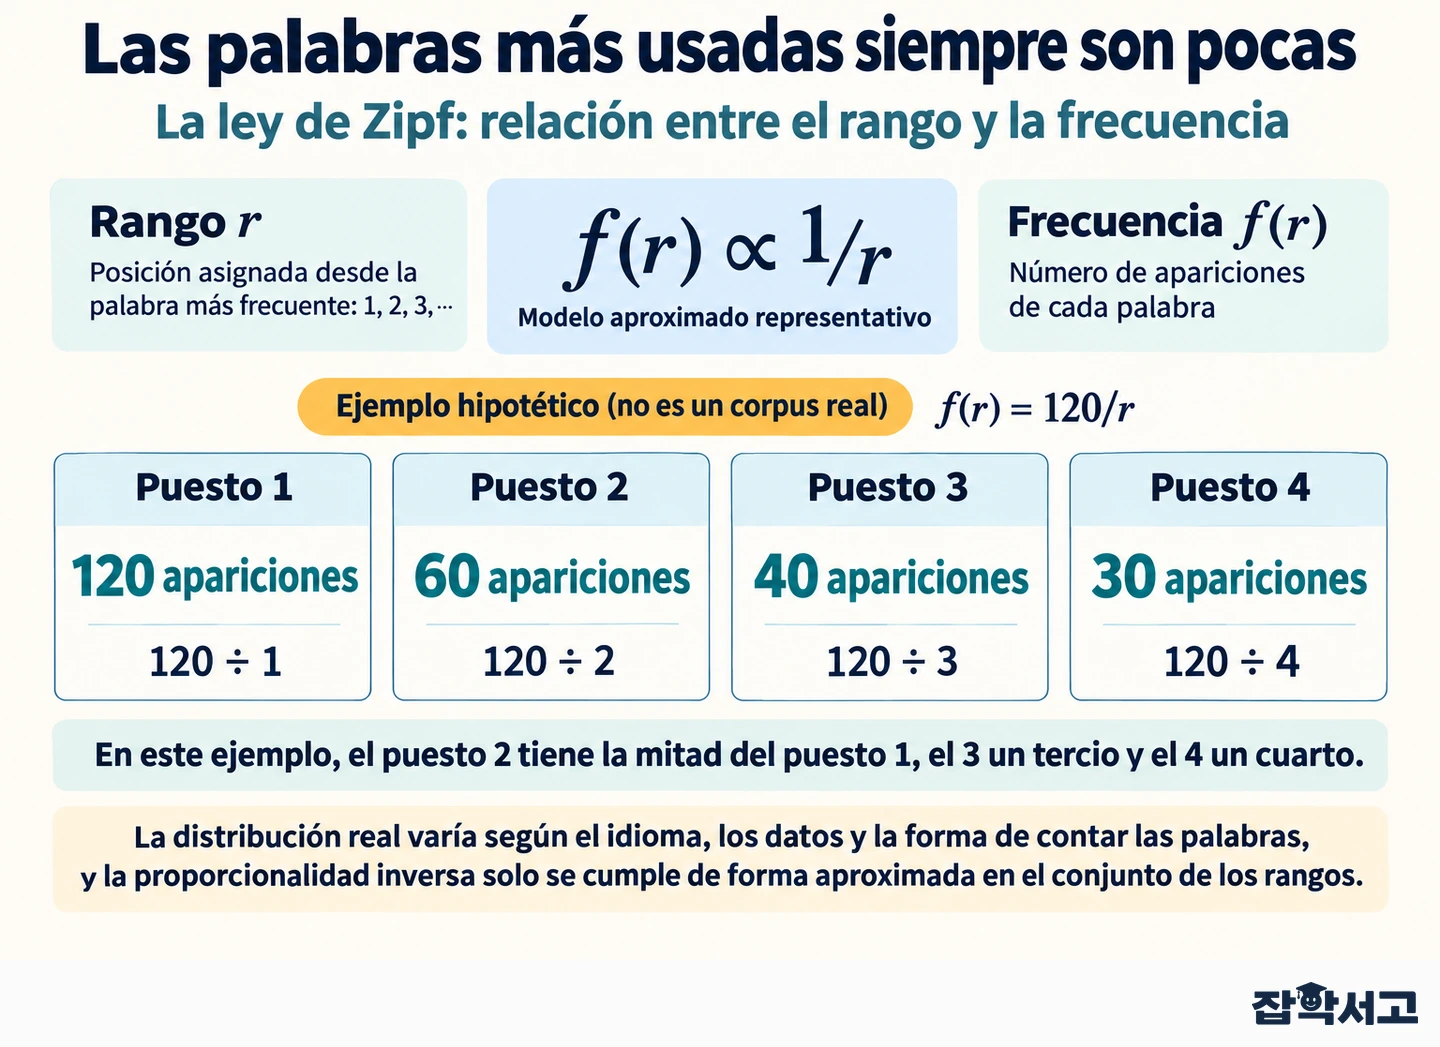
(1) Palabra en el puesto 1
La palabra más frecuente sirve de referencia. En el corpus Brown (Brown Corpus), una colección de textos en inglés estadounidense de unos 100 grupos de diez mil palabras, «the» aparece 6 decenas de millar más 9,971 veces y representa cerca del 7 % del total.
(2) Palabra en el puesto 2
Se usa aproximadamente la mitad de las veces que la del puesto 1. En el corpus Brown, «of» ocupa el puesto 2 con 3 decenas de millar más 6,411 apariciones, algo más del 3.5 % del total.
(3) Palabras a partir del puesto 3
La frecuencia de la palabra en el puesto 3 baja aproximadamente a 3 partes iguales del valor del puesto 1, de las que se toma 1, y para la del puesto 10 se toma 1 de esas partes al dividir el mismo valor en 10. Como el uso se concentra en los primeros puestos, en este corpus apenas 135 palabras representan la mitad de todas las apariciones.
Si se representa esta relación en un gráfico con escala logarítmica en ambos ejes, aparece como una línea casi recta que desciende hacia la derecha.
Zipf explicó este fenómeno mediante el principio del mínimo esfuerzo. Quien habla intenta transmitir muchos significados con pocas palabras, mientras que quien escucha prefiere una variedad de palabras de significado claro. Según Zipf, esta distribución surge del equilibrio entre ambas fuerzas.
Aplicaciones en bibliotecas y en la recuperación de información

La ley de Zipf se usa para identificar qué palabras de un texto reflejan bien su contenido. Las palabras demasiado frecuentes aparecen en cualquier texto y las demasiado raras muchas veces aparecen por casualidad.
- Lista de palabras vacías (Stop Word List). Excluye de antemano del índice las palabras más frecuentes, como las partículas gramaticales o los artículos, para reducir el espacio de almacenamiento y el tiempo de búsqueda.
- Extracción de palabras clave (Keyword Extraction). En 1958, Hans Peter Luhn, de IBM, experimentó con la generación de resúmenes de artículos académicos por computadora. Para ello, descartó las palabras demasiado frecuentes y las demasiado raras, y seleccionó como palabras clave las de frecuencia intermedia.
- Atribución de autoría (Authorship Attribution). Cada persona mantiene un patrón de frecuencias de uso de las palabras relativamente estable, que sirve como indicio para determinar quién escribió un texto.
- Planificación de colecciones e índices (Collection and Index Planning). Saber que el uso se concentra en unos pocos materiales y términos permite establecer criterios para incorporar y organizar primero lo que se busca con mayor frecuencia.
La ley de Lotka, que describe cómo la producción de artículos se concentra en unos pocos autores, se explica matemáticamente mediante una distribución de la misma familia que la de la ley de Zipf. La ley de Bradford, según la cual los artículos se concentran en unas pocas revistas académicas, muestra una concentración similar. De ahí que se agrupen las tres leyes de la bibliometría.
Precauciones al interpretar la ley de Zipf

La ley de Zipf se cumple con sorprendente frecuencia, aunque es una aproximación empírica y solo describe de manera aproximada una regularidad natural. Por eso, al aplicarla conviene tener presentes algunas limitaciones.
Limitaciones señaladas con frecuencia
- Desviación en los extremos (Deviation at the Extremes). En las palabras que ocupan los puestos más altos y más bajos, las frecuencias observadas difieren considerablemente de la proporción ideal.
- Diferencias entre lenguas (Language Differences). Las lenguas en las que una sílaba constituye una unidad de significado, como el chino o el vietnamita, pueden apartarse considerablemente de la ley.
- Debate sobre las causas (Debate over Causes). Incluso los textos sin sentido generados al teclear letras al azar presentan una distribución similar. Por ello, se ha señalado que el principio del mínimo esfuerzo por sí solo resulta insuficiente para explicarla.
En un estudio que analizó 3 decenas de millar de textos en inglés, la proporción de textos que se ajustaban bien a la ley osciló entre aproximadamente el 15 % y el 40 %, según cómo se definiera la ley. Al tomar como referencia la distribución acumulada, la proporción fue de alrededor del 40 %, todavía por debajo de la mitad. La ley sirve como mapa orientativo y su validez depende del texto.
La ley de Zipf muestra mediante una proporción sencilla hasta qué punto el lenguaje que usamos se apoya en unas pocas palabras. Esta regla, obtenida al contar palabras a mano hace unos 90 años, sigue presente en distintas técnicas de tratamiento de la información, como el filtrado de palabras vacías y la extracción de palabras clave.
Distinguir las palabras verdaderamente significativas entre las más comunes y las más raras es el primer paso en la recuperación de información.