本を一冊開いて単語を一つずつ数えてみると、不思議な偏りが現れます。「そして」「ある」「こと」のような少数の単語はどのページにも絶え間なく登場しますが、大半の単語は本全体で一、二度出てきて姿を消します。ところが、この偏りはでたらめではなく、驚くほど一定の比率に従います。この規則を指す言葉が「ジップの法則(Zipf's Law)」です。
ジップの法則とは、簡単にいえば「単語をよく使われる順に並べると、それぞれの単語の使用回数は順位に反比例する」という経験則を意味します。ブラッドフォードの法則、ロトカの法則とともに計量書誌学の3大法則に数えられ、今日の検索エンジンや索引技術の基盤にもなっています。
本資料では、ジップの法則がどのように知られるようになったのか、法則の内容とその原因についての説明、さらに図書館や情報検索での用途と限界まで、順に見ていきます。
ジップの法則で読み解く単語の秩序
ジップの法則とは何か?
この法則の名前は、アメリカの言語学者ジョージ・キングズリー・ジップ(George Kingsley Zipf)に由来します。ハーバード大学でドイツ語を教えていた彼は、1930年代にさまざまな言語の文章で単語の出現回数を数え、順位と頻度の間にある単純な関係をまとめました。
ただし、この関係を初めて発見したのはジップではありません。フランスの速記者ジャン=バティスト・エストゥー(Jean-Baptiste Estoup)が1916年にすでに同じ現象を記録しており、ジップ自身もそれを認めていました。それでも、この規則をさまざまな言語や分野へと広げて紹介したのがジップだったため、今日まで彼の名前で呼ばれています。
ジップは1949年に『人間行動と最小努力の原理(Human Behavior and the Principle of Least Effort)』という本で、この考えを人間の行動全般へと広げました。
この規則は単語だけにとどまりません。1913年、ドイツの物理学者フェリックス・アウエルバッハ(Felix Auerbach)は、都市を人口順に並べると人口が順位に反比例することを先に観察しており、その後、企業の規模や音楽の音符の出現頻度など、さまざまなデータでも似た形が確認されました。
順位と頻度の反比例

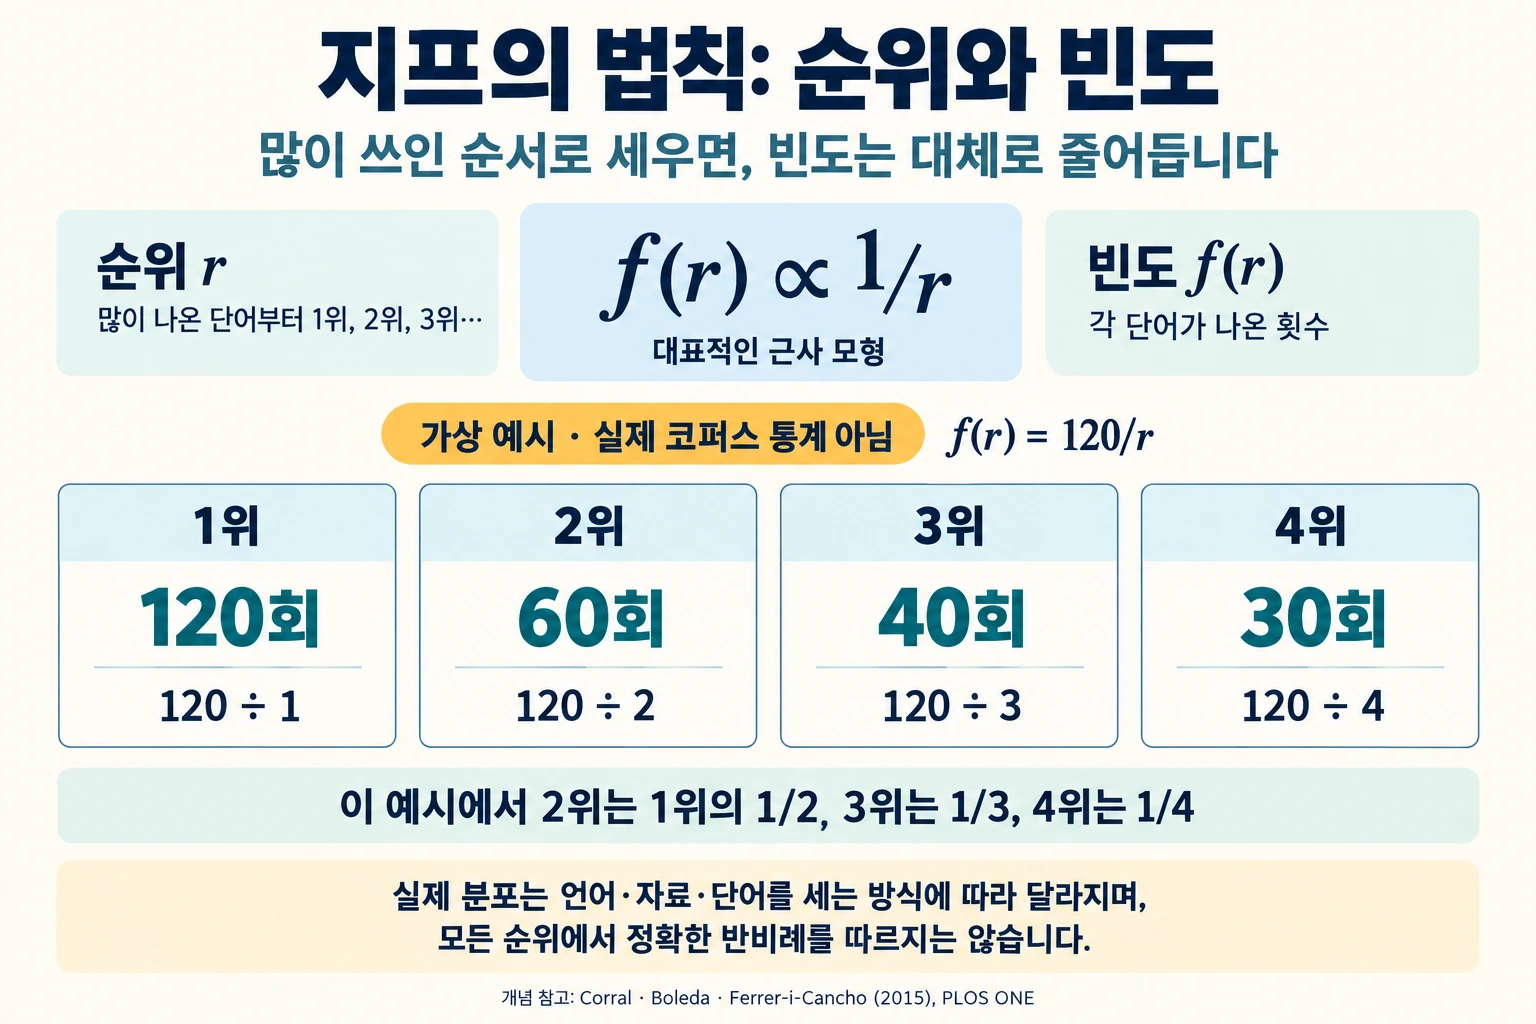
ジップの法則は、とても簡単な比率で表せます。最もよく使われる単語の回数を基準にすると、ほかの単語の回数は、その回数を順位の数で割った値に近くなります。
(1)1位の単語
最もよく出てくる単語が基準になります。約100万語からなるアメリカ英語の資料集、ブラウン・コーパス(Brown Corpus)では、「the」が6万9,971回出現し、全体の7%近くを占めています。
(2)2位の単語
1位の半分ほど使われます。ブラウン・コーパスで2位の「of」は3万6,411回で、全体の3.5%を少し超えます。
(3)3位以下の単語
3位は1位の3分の1、10位は10分の1ほどに減ります。このように上位に偏った結果、この資料ではわずか135語が単語の総使用回数の半分を占めています。
横軸と縦軸をどちらも対数目盛に変えてグラフを描くと、この関係は右下がりのほぼ真っすぐな直線として現れます。
ジップはこの現象を最小努力の原理で説明しました。話し手は少ない単語で多くの意味を伝えようとし、聞き手は意味の明確な多様な単語を求めますが、この二つの力が釣り合うことで、こうした分布が生じるというものです。
図書館と情報検索での用途
ジップの法則は、文章中のどの単語が内容をよく表しているかを見分けるために使われます。あまりにありふれた単語はどの文章にも登場し、あまりに珍しい単語は偶然入り込んだ場合が多いためです。
- ストップワードリスト(Stop Word List):助詞や冠詞のように頻度が最も高い単語をあらかじめ索引から除き、保存容量と検索時間を減らします。
- キーワード抽出(Keyword Extraction):1958年、IBMのハンス・ペーター・ルーン(Hans Peter Luhn)は、あまりに頻繁な単語とあまりにまれな単語を除き、中程度の頻度の単語をキーワードとして選んで、コンピューターで論文の要約を作る実験を行いました。
- 著者判定(Authorship Attribution):人それぞれに単語の使用頻度のパターンが比較的一定しているため、書き手が誰かを見分ける根拠として使われます。
- 蔵書・索引計画(Collection and Index Planning):少数の資料や用語に利用が集中することが分かれば、よく求められるものからそろえ、整理するための基準を立てられます。
著者ごとの論文数に偏りが生じるロトカの法則は、数学的にはジップの法則と同じ系統の分布で説明され、少数の学術雑誌に論文が集中するブラッドフォードの法則も似た偏りを示します。計量書誌学の三つの法則がひとまとめにされる理由は、ここにあります。
ジップの法則を読み解く際の注意点
ジップの法則は驚くほどよく当てはまりますが、厳密な自然法則というより、経験から得られた近似です。そのため、使う人はいくつかの限界も併せて知っておく必要があります。
よく指摘される限界
- 両端でのずれ(Deviation at the Extremes):順位が最も高い単語と最も低い単語では、実際の頻度が理想的な比率とかなり異なります。
- 言語による違い(Language Differences):中国語やベトナム語のように、一つの音節が一つの意味単位となる言語は、法則から大きく外れることもあります。
- 原因をめぐる議論(Debate over Causes):文字を無作為に打って作ったでたらめな文章でも似た分布が現れるため、最小努力の原理だけでは説明が不十分だという指摘があります。
実際に英語の文章3万編を分析した研究では、法則をどう定義するかによって、よく当てはまる文章の割合が約15%から40%まで変わりました。累積分布を基準にすると約40%でしたが、それでも半分には届きませんでした。この法則は方向を示す地図にすぎず、あらゆる文章に当てはまる正解ではないということです。
ジップの法則は、私たちが使う言葉が少数の単語に大きく依存しているという事実を、単純な比率で示しています。約90年前に手作業で単語を数えて得られたこの規則は、今もストップワード処理やキーワード抽出のように、情報を扱う技術のさまざまな場面で生き続けています。
ありふれた単語と珍しい単語の間から、本当に意味のある言葉を見分けること。それが情報検索の第一歩です。