Khi mở một cuốn sách và đếm từng từ, ta sẽ thấy một sự tập trung kỳ lạ. Một số từ như “và”, “có”, “điều” xuất hiện liên tục trên mọi trang, trong khi phần lớn các từ chỉ xuất hiện một hai lần trong cả cuốn sách rồi biến mất. Thế nhưng, sự tập trung này không tùy tiện mà tuân theo một tỷ lệ ổn định đến đáng ngạc nhiên. Quy luật đó được gọi là “định luật Zipf (Zipf's Law)”.
Nói một cách đơn giản, định luật Zipf là một quy luật thực nghiệm cho rằng “khi xếp các từ theo thứ tự được sử dụng nhiều nhất, số lần sử dụng mỗi từ tỷ lệ nghịch với thứ hạng của nó”. Cùng với định luật Bradford và định luật Lotka, nó được xem là một trong 3 định luật lớn của trắc lượng thư mục học, đồng thời cũng là nền tảng của công cụ tìm kiếm và công nghệ lập chỉ mục ngày nay.
Trong tài liệu này, chúng ta sẽ lần lượt tìm hiểu định luật Zipf được biết đến như thế nào, nội dung của định luật và những cách giải thích nguyên nhân, cùng các ứng dụng và giới hạn trong thư viện và truy hồi thông tin.
Tìm hiểu trật tự của từ ngữ qua định luật Zipf
Định luật Zipf là gì?
Định luật này được đặt theo tên nhà ngôn ngữ học người Mỹ George Kingsley Zipf. Khi giảng dạy tiếng Đức tại Đại học Harvard vào thập niên 1930, ông đã đếm số lần xuất hiện của từ trong văn bản thuộc nhiều ngôn ngữ và hệ thống hóa mối quan hệ đơn giản giữa thứ hạng và tần suất.
Tuy nhiên, Zipf không phải người đầu tiên phát hiện ra mối quan hệ này. Nhà tốc ký người Pháp Jean-Baptiste Estoup đã ghi nhận hiện tượng tương tự từ năm 1916, và chính Zipf cũng thừa nhận điều đó. Dù vậy, vì Zipf là người mở rộng và phổ biến quy luật này sang nhiều ngôn ngữ và lĩnh vực nên đến nay nó vẫn mang tên ông.
Năm 1949, trong cuốn sách “Hành vi con người và nguyên tắc nỗ lực tối thiểu (Human Behavior and the Principle of Least Effort)”, Zipf đã mở rộng ý tưởng này sang hành vi con người nói chung.
Quy luật này không chỉ giới hạn ở từ ngữ. Năm 1913, nhà vật lý người Đức Felix Auerbach đã quan sát thấy rằng khi xếp các thành phố theo dân số, dân số tỷ lệ nghịch với thứ hạng. Về sau, hình dạng tương tự cũng được xác nhận trong nhiều loại dữ liệu như quy mô doanh nghiệp và tần suất các nốt nhạc.
Quan hệ tỷ lệ nghịch giữa thứ hạng và tần suất

Định luật Zipf có thể được biểu diễn bằng một tỷ lệ rất đơn giản. Nếu lấy số lần xuất hiện của từ được dùng nhiều nhất làm chuẩn, số lần xuất hiện của những từ còn lại sẽ gần bằng giá trị đó chia cho số thứ hạng.
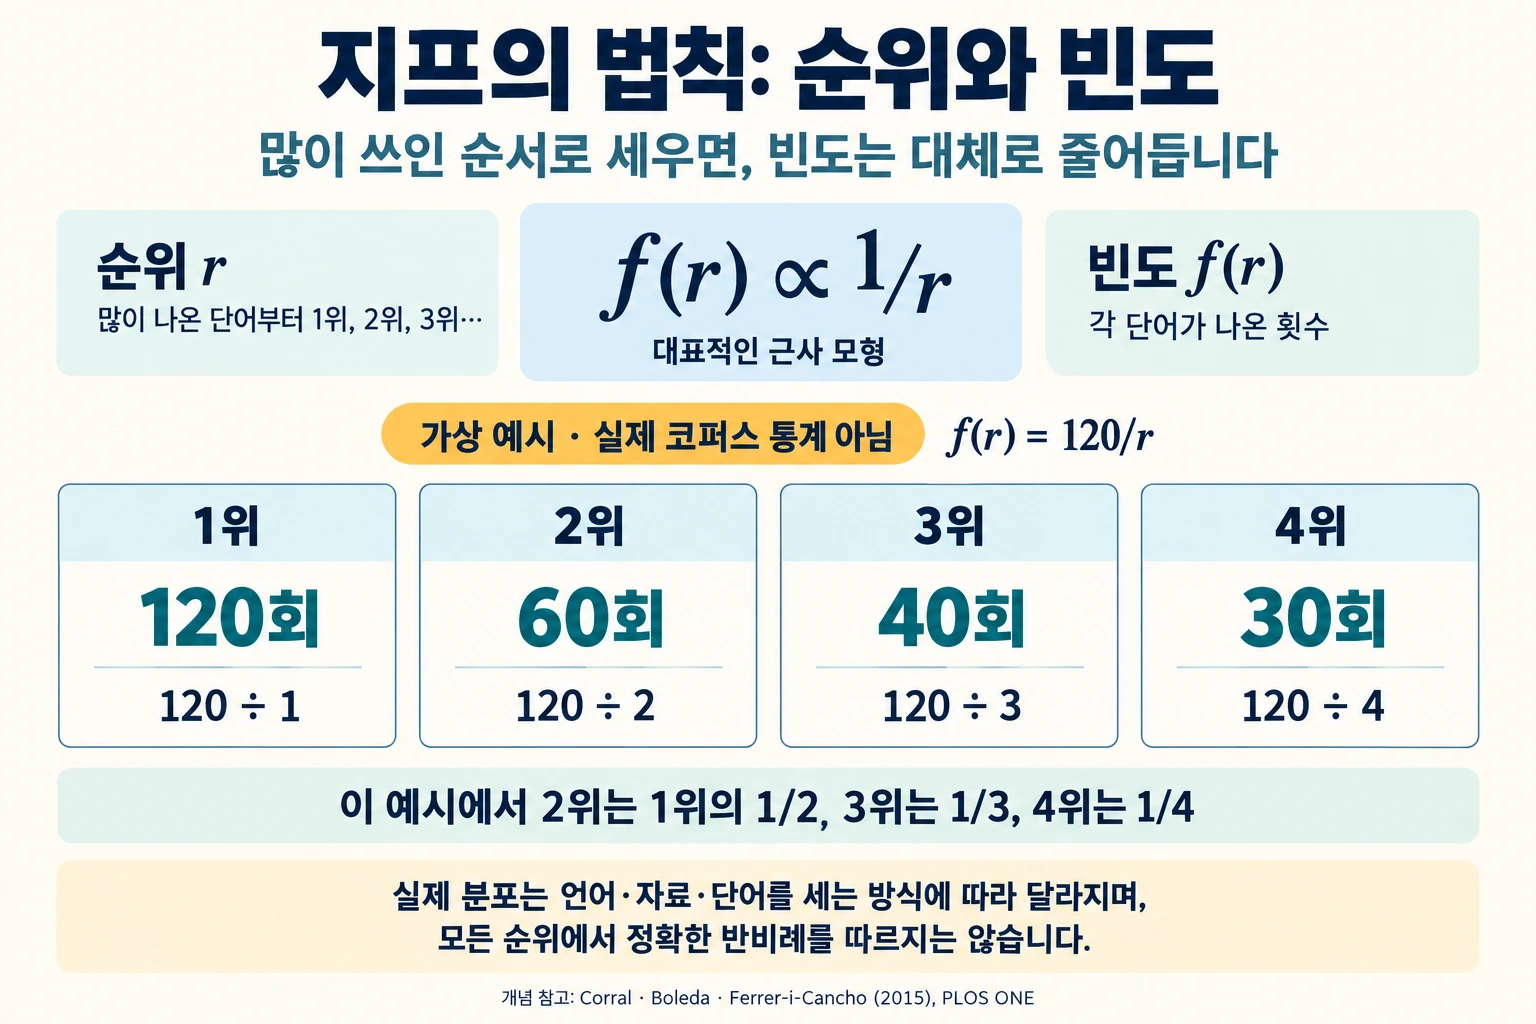
(1) Từ xếp hạng 1
Từ phổ biến nhất được dùng làm chuẩn. Trong Brown Corpus, một tập hợp ngữ liệu tiếng Anh Mỹ gồm khoảng 100 vạn từ, “the” xuất hiện 6 vạn 9,971 lần, chiếm gần 7% tổng số.
(2) Từ xếp hạng 2
Được sử dụng khoảng một nửa so với từ xếp hạng 1. Trong Brown Corpus, “of”, từ xếp hạng 2, xuất hiện 3 vạn 6,411 lần, chiếm hơn 3.5% tổng số một chút.
(3) Các từ từ hạng 3 trở xuống
Tần suất của từ xếp hạng 3 giảm còn khoảng một phần 3, với tử số là 1, so với từ xếp hạng 1; từ xếp hạng 10 giảm còn khoảng một phần 10, với tử số là 1. Do sự tập trung vào nhóm đầu như vậy, chỉ 135 từ đã chiếm một nửa tổng số lượt sử dụng từ trong tập dữ liệu này.
Khi vẽ đồ thị với cả trục ngang và trục dọc đều dùng thang logarit, mối quan hệ này hiện thành một đường gần như thẳng, dốc xuống về bên phải.
Zipf giải thích hiện tượng này bằng nguyên tắc nỗ lực tối thiểu. Người nói muốn truyền đạt nhiều ý nghĩa bằng một số ít từ, còn người nghe muốn có nhiều từ đa dạng với ý nghĩa rõ ràng; khi hai lực này cân bằng, phân bố như vậy hình thành.
Ứng dụng trong thư viện và truy hồi thông tin
Định luật Zipf được dùng để xác định những từ thể hiện rõ nội dung của văn bản. Đó là vì những từ quá phổ biến xuất hiện trong mọi văn bản, còn những từ quá hiếm thường chỉ tình cờ xuất hiện.
- Danh sách từ dừng (Stop Word List): Loại trước khỏi chỉ mục những từ có tần suất cao nhất như trợ từ hay mạo từ để giảm dung lượng lưu trữ và thời gian tìm kiếm.
- Trích xuất từ khóa (Keyword Extraction): Năm 1958, Hans Peter Luhn của IBM đã thử nghiệm tạo bản tóm tắt bài báo khoa học bằng máy tính, bằng cách loại bỏ những từ quá phổ biến và quá hiếm rồi chọn các từ có tần suất trung bình làm từ khóa.
- Xác định tác giả (Authorship Attribution): Đặc điểm tần suất sử dụng từ của mỗi người tương đối ổn định, nên được dùng làm căn cứ để xác định người viết.
- Lập kế hoạch vốn tài liệu và chỉ mục (Collection and Index Planning): Khi biết nhu cầu sử dụng tập trung vào một số ít tài liệu và thuật ngữ, ta có thể đặt ra tiêu chí ưu tiên bổ sung và tổ chức những tài liệu được tìm đến thường xuyên.
Định luật Lotka, mô tả sự tập trung về số lượng bài báo giữa các tác giả, được giải thích về mặt toán học bằng một phân bố cùng họ với định luật Zipf; định luật Bradford, mô tả việc các bài báo tập trung vào một số ít tạp chí học thuật, cũng cho thấy sự tập trung tương tự. Đây là lý do ba định luật của trắc lượng thư mục học được xếp chung với nhau.
Những điểm cần lưu ý khi tìm hiểu định luật Zipf
Định luật Zipf phù hợp với thực tế thường xuyên đến đáng ngạc nhiên, nhưng là một quy luật xấp xỉ rút ra từ kinh nghiệm hơn là một định luật tự nhiên chính xác. Vì vậy, người sử dụng cần biết cả một số giới hạn của nó.
Những giới hạn thường được chỉ ra
- Sai lệch ở hai đầu (Deviation at the Extremes): Với những từ có thứ hạng cao nhất và thấp nhất, tần suất thực tế khác khá nhiều so với tỷ lệ lý tưởng.
- Khác biệt giữa các ngôn ngữ (Language Differences): Những ngôn ngữ mà một âm tiết tạo thành một đơn vị ý nghĩa, như tiếng Trung hay tiếng Việt, đôi khi lệch đáng kể khỏi định luật.
- Tranh luận về nguyên nhân (Debate over Causes): Ngay cả văn bản vô nghĩa được tạo ra bằng cách gõ ký tự ngẫu nhiên cũng cho ra phân bố tương tự, nên có ý kiến cho rằng chỉ nguyên tắc nỗ lực tối thiểu là chưa đủ để giải thích.
Thực tế, trong một nghiên cứu phân tích 3 vạn văn bản tiếng Anh, tỷ lệ văn bản phù hợp với định luật dao động từ khoảng 15% đến 40%, tùy cách định nghĩa định luật. Nếu lấy phân bố tích lũy làm tiêu chí, tỷ lệ này vào khoảng 40%, nhưng vẫn chưa đạt một nửa. Có thể nói, định luật chỉ là tấm bản đồ chỉ hướng, chứ không phải đáp án cho mọi văn bản.
Định luật Zipf dùng một tỷ lệ đơn giản để cho thấy ngôn ngữ chúng ta sử dụng phụ thuộc rất nhiều vào một số ít từ. Quy luật được rút ra bằng cách đếm từ thủ công khoảng 90 năm trước này vẫn hiện diện trong nhiều công nghệ xử lý thông tin ngày nay, như xử lý từ dừng và trích xuất từ khóa.
Phân biệt những từ thực sự có ý nghĩa giữa các từ phổ biến và các từ hiếm gặp chính là bước đầu tiên của truy hồi thông tin.