किसी किताब को खोलकर उसके शब्दों को एक-एक करके गिनें, तो एक अजीब संकेंद्रण दिखाई देता है। ‘और’, ‘है’, ‘चीज़’ जैसे कुछ शब्द हर पन्ने पर लगातार आते हैं, जबकि अधिकांश शब्द पूरी किताब में एक-दो बार आकर गायब हो जाते हैं। लेकिन यह संकेंद्रण मनमाना नहीं होता; यह आश्चर्यजनक रूप से एक निश्चित अनुपात का पालन करता है। इसी नियमितता को ‘ज़िप्फ़ का नियम (Zipf's Law)’ कहते हैं।
सरल शब्दों में, ज़िप्फ़ का नियम एक अनुभवजन्य नियम है, जिसके अनुसार ‘शब्दों को सबसे अधिक इस्तेमाल होने के क्रम में रखें, तो हर शब्द के इस्तेमाल की संख्या उसके क्रम-स्थान के व्युत्क्रमानुपाती होती है।’ ब्रैडफ़ोर्ड के नियम और लोट्का के नियम के साथ इसे ग्रंथमितिकी के 3 प्रमुख नियमों में गिना जाता है। आज के सर्च इंजन और अनुक्रमण तकनीकें भी इस पर आधारित हैं।
इस सामग्री में हम क्रम से देखेंगे कि ज़िप्फ़ का नियम कैसे प्रसिद्ध हुआ, यह नियम क्या कहता है, इसके कारणों की क्या व्याख्याएँ हैं और पुस्तकालयों तथा सूचना पुनर्प्राप्ति में इसके उपयोग और सीमाएँ क्या हैं।
ज़िप्फ़ के नियम से शब्दों की व्यवस्था को समझना
ज़िप्फ़ का नियम क्या है?

इस नियम का नाम अमेरिकी भाषाविद् जॉर्ज किंग्सली ज़िप्फ़ (George Kingsley Zipf) के नाम पर पड़ा है। हार्वर्ड विश्वविद्यालय में जर्मन पढ़ाने वाले ज़िप्फ़ ने 1930 के दशक में विभिन्न भाषाओं के लेखों में शब्दों के आने की संख्या गिनकर क्रम-स्थान और आवृत्ति के बीच के सरल संबंध को व्यवस्थित रूप दिया।
हालाँकि, इस संबंध की खोज सबसे पहले ज़िप्फ़ ने नहीं की थी। फ़्रांसीसी आशुलिपिक ज़ाँ-बातिस्त एस्तू (Jean-Baptiste Estoup) ने 1916 में ही इसी घटना को दर्ज कर लिया था और ज़िप्फ़ ने स्वयं भी इसे स्वीकार किया था। फिर भी, इस नियमितता को विभिन्न भाषाओं और क्षेत्रों तक फैलाकर परिचित कराने वाले ज़िप्फ़ ही थे, इसलिए आज भी इसे उन्हीं के नाम से जाना जाता है।
ज़िप्फ़ ने 1949 में अपनी पुस्तक ‘मानव व्यवहार और न्यूनतम प्रयास का सिद्धांत (Human Behavior and the Principle of Least Effort)’ में इस विचार का विस्तार मानव व्यवहार के समूचे क्षेत्र तक किया।
यह नियमितता केवल शब्दों तक सीमित नहीं है। 1913 में जर्मन भौतिक विज्ञानी फ़ेलिक्स आउअरबाख (Felix Auerbach) ने पहले यह देखा कि शहरों को जनसंख्या के क्रम में रखने पर उनकी जनसंख्या उनके क्रम-स्थान के व्युत्क्रमानुपाती होती है। बाद में कंपनियों के आकार और संगीत में स्वरों की आवृत्ति जैसे विभिन्न आँकड़ों में भी ऐसा ही स्वरूप पाया गया।
क्रम-स्थान और आवृत्ति का व्युत्क्रमानुपात

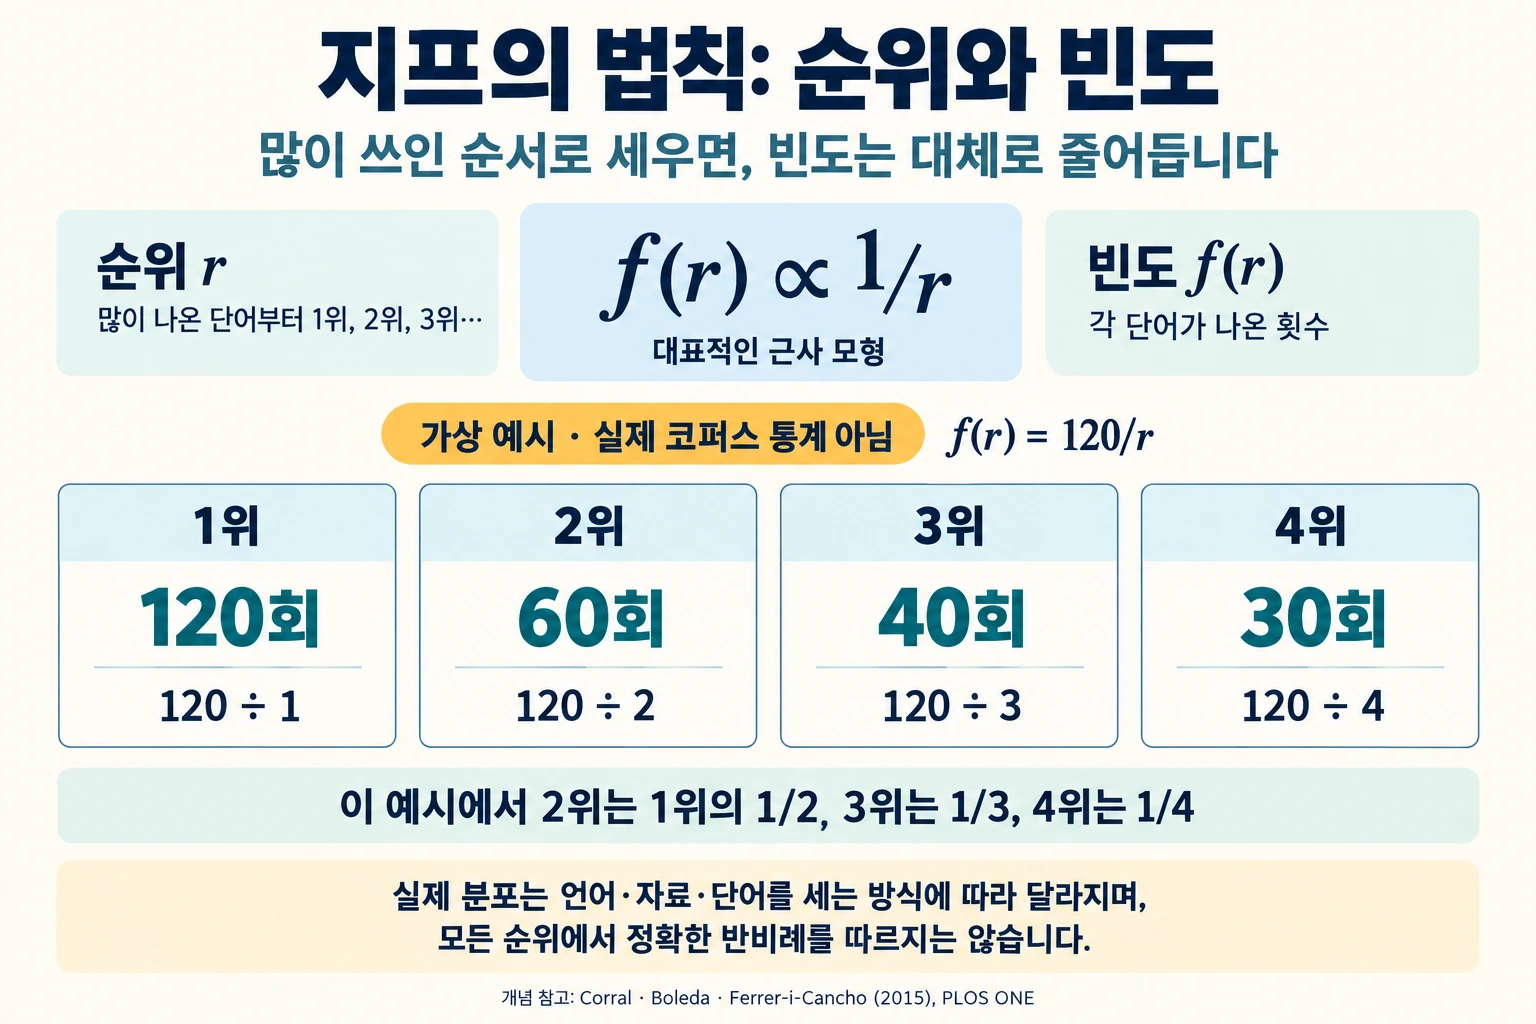
ज़िप्फ़ के नियम को एक बहुत सरल अनुपात में व्यक्त किया जा सकता है। सबसे अधिक इस्तेमाल होने वाले शब्द की आवृत्ति को आधार मानें, तो बाकी शब्दों की आवृत्तियाँ उस आधार को उनके क्रम-स्थान की संख्या से भाग देने पर मिलने वाले मान के लगभग बराबर होती हैं।
(1) क्रम-स्थान 1 का शब्द
सबसे सामान्य शब्द को आधार बनाया जाता है। लगभग 100 × दस हज़ार शब्दों वाले अमेरिकी अंग्रेज़ी के पाठ-संग्रह ब्राउन कॉर्पस (Brown Corpus) में ‘the’ कुल 6 × दस हज़ार और 9,971 बार आता है, जो कुल शब्द-प्रयोग का लगभग 7% है।
(2) क्रम-स्थान 2 का शब्द
इसका इस्तेमाल क्रम-स्थान 1 वाले शब्द के लगभग आधे के बराबर होता है। ब्राउन कॉर्पस में क्रम-स्थान 2 पर आने वाला ‘of’ कुल 3 × दस हज़ार और 6,411 बार आता है, जो कुल शब्द-प्रयोग के 3.5% से थोड़ा अधिक है।
(3) क्रम-स्थान 3 और उसके बाद के शब्द
क्रम-स्थान 3 वाले शब्द की आवृत्ति, क्रम-स्थान 1 वाले शब्द की आवृत्ति के लगभग 3 भागों में से 1 भाग रह जाती है, और क्रम-स्थान 10 वाले शब्द की आवृत्ति लगभग 10 भागों में से 1 भाग रह जाती है। आरंभिक क्रम-स्थानों पर इस संकेंद्रण के कारण इस सामग्री में केवल 135 शब्द कुल शब्द-प्रयोग के आधे हिस्से का प्रतिनिधित्व करते हैं।
क्षैतिज और ऊर्ध्वाधर दोनों अक्षों को लघुगणकीय पैमाने पर रखकर ग्राफ़ बनाएँ, तो यह संबंध दाईं ओर नीचे जाती हुई लगभग सीधी रेखा के रूप में दिखाई देता है।
ज़िप्फ़ ने इस घटना की व्याख्या न्यूनतम प्रयास के सिद्धांत से की। बोलने वाला कम शब्दों में अधिक अर्थ व्यक्त करना चाहता है, जबकि सुनने वाला स्पष्ट अर्थ वाले विविध शब्द चाहता है। इन दोनों बलों के संतुलन से ऐसा वितरण उत्पन्न होता है।
पुस्तकालयों और सूचना पुनर्प्राप्ति में उपयोग

ज़िप्फ़ का नियम यह पहचानने के लिए इस्तेमाल किया जाता है कि किसी पाठ के कौन-से शब्द उसकी विषयवस्तु को अच्छी तरह व्यक्त करते हैं। ऐसा इसलिए है कि बहुत सामान्य शब्द हर तरह के पाठ में आते हैं, जबकि बहुत दुर्लभ शब्द अक्सर संयोग से शामिल हो जाते हैं।
- विराम-शब्द सूची (Stop Word List): परसर्गों या उपपदों जैसे सबसे अधिक आवृत्ति वाले शब्दों को अनुक्रमणिका से पहले ही हटा दिया जाता है, जिससे भंडारण स्थान और खोज का समय कम होता है।
- मुख्य शब्द निष्कर्षण (Keyword Extraction): 1958 में IBM के हांस पीटर लून (Hans Peter Luhn) ने बहुत सामान्य और बहुत दुर्लभ शब्दों को हटाकर मध्यम आवृत्ति वाले शब्दों को मुख्य शब्दों के रूप में चुना और कंप्यूटर से शोधपत्रों के सार बनाने का प्रयोग किया।
- लेखक की पहचान (Authorship Attribution): हर व्यक्ति के शब्द-प्रयोग की आवृत्तियों का स्वरूप अपेक्षाकृत स्थिर होता है, इसलिए इसका उपयोग यह पहचानने के आधार के रूप में किया जाता है कि किसी पाठ का लेखक कौन है।
- संग्रह और अनुक्रमणिका की योजना (Collection and Index Planning): यदि यह समझ लिया जाए कि उपयोग कुछ ही सामग्रियों और शब्दों पर केंद्रित होता है, तो अधिक खोजी जाने वाली चीज़ों को पहले जुटाने और व्यवस्थित करने के मानदंड तय किए जा सकते हैं।
लेखकों के बीच शोधपत्रों की संख्या में संकेंद्रण को दर्शाने वाले लोट्का के नियम की व्याख्या गणितीय रूप से ज़िप्फ़ के नियम के समान परिवार के वितरण से की जाती है। कुछ ही शोध पत्रिकाओं में शोधपत्रों के केंद्रित होने का ब्रैडफ़ोर्ड का नियम भी ऐसा ही संकेंद्रण दिखाता है। यही कारण है कि ग्रंथमितिकी के इन तीन नियमों को एक साथ रखा जाता है।
ज़िप्फ़ के नियम को समझते समय ध्यान देने योग्य बातें

ज़िप्फ़ का नियम आश्चर्यजनक रूप से अक्सर सही बैठता है, लेकिन यह किसी सटीक प्राकृतिक नियम की अपेक्षा अनुभव से प्राप्त एक सन्निकटन है। इसलिए इसका उपयोग करने वालों को इसकी कुछ सीमाएँ भी जाननी चाहिए।
अक्सर बताई जाने वाली सीमाएँ
- दोनों सिरों पर विचलन (Deviation at the Extremes): सबसे ऊँचे और सबसे निचले क्रम-स्थानों वाले शब्दों की वास्तविक आवृत्तियाँ आदर्श अनुपात से काफ़ी अलग होती हैं।
- भाषाओं के बीच अंतर (Language Differences): चीनी या वियतनामी जैसी भाषाएँ, जिनमें एक अक्षरांश एक अर्थ-इकाई होता है, कभी-कभी इस नियम से काफ़ी विचलित होती हैं।
- कारणों पर बहस (Debate over Causes): अक्षरों को बेतरतीब ढंग से टाइप करके बनाए गए निरर्थक पाठ में भी ऐसा ही वितरण मिलता है, इसलिए यह आपत्ति उठाई जाती है कि केवल न्यूनतम प्रयास का सिद्धांत पर्याप्त व्याख्या नहीं देता।
वास्तव में, अंग्रेज़ी के 3 × दस हज़ार पाठों का विश्लेषण करने वाले एक अध्ययन में, नियम को कैसे परिभाषित किया गया है, इसके अनुसार उससे अच्छी तरह मेल खाने वाले पाठों का अनुपात लगभग 15% से 40% तक बदल गया। संचयी वितरण को आधार बनाने पर यह लगभग 40% था, लेकिन तब भी आधे से कम था। यानी यह नियम दिशा बताने वाला एक मानचित्र है; हर पाठ का सही उत्तर नहीं।
ज़िप्फ़ का नियम एक सरल अनुपात के माध्यम से दिखाता है कि हमारी भाषा कुछ ही शब्दों पर बहुत अधिक निर्भर करती है। लगभग 90 वर्ष पहले हाथ से शब्द गिनकर प्राप्त यह नियमितता आज भी विराम-शब्द प्रसंस्करण और मुख्य शब्द निष्कर्षण जैसी सूचना संबंधी अनेक तकनीकों में जीवित है।
सामान्य और दुर्लभ शब्दों के बीच से वास्तव में अर्थपूर्ण शब्दों को पहचानना ही सूचना पुनर्प्राप्ति का पहला कदम है।