翻开一本书,把里面的词一个一个数一数,就会发现一种奇怪的偏向。“和”“有”“东西”等少数几个词每页都会不停地出现,而大多数词在整本书中只出现一两次就消失了。然而,这种偏向并不是杂乱无章的,而是遵循着惊人一致的比例。指代这一规律的说法,就是“齐普夫定律”(Zipf's Law)。
简单来说,齐普夫定律是一条经验法则:“把词按使用频率从高到低排序,每个词的使用次数与它的排名成反比”。它与布拉德福定律、洛特卡定律一起被列为文献计量学的三大定律,如今也是搜索引擎和索引技术的基础。
本文将依次探讨齐普夫定律是如何为人所知的、定律的内容及对其成因的解释,以及它在图书馆和信息检索中的应用与局限。
从齐普夫定律看词语的秩序
什么是齐普夫定律?
这一定律得名于美国语言学家乔治·金斯利·齐普夫(George Kingsley Zipf)。20世纪30年代,在哈佛大学教授德语的他统计了多种语言文本中词语出现的次数,总结出了排名与频率之间的简单关系。
不过,齐普夫并不是最早发现这一关系的人。法国速记员让-巴蒂斯特·埃斯图(Jean-Baptiste Estoup)早在1916年就记录了同样的现象,齐普夫本人也承认这一点。尽管如此,由于是齐普夫把这一规律推广到多种语言和领域并使之广为人知,所以至今仍以他的名字命名。
齐普夫在1949年出版的《人类行为与最省力原则》(Human Behavior and the Principle of Least Effort)一书中,把这一思想扩展到了人类行为的各个方面。
这一规律并不局限于词语。1913年,德国物理学家费利克斯·奥尔巴赫(Felix Auerbach)就已经观察到,把城市按人口排序时,人口与排名成反比;后来在企业规模、音乐中音符出现的频率等许多数据中,也都发现了类似的形态。
排名与频率的反比关系

齐普夫定律可以用一个非常简单的比例来表示。以使用最多的词的次数为基准,其余各词的次数大致等于这个基准除以其排名。
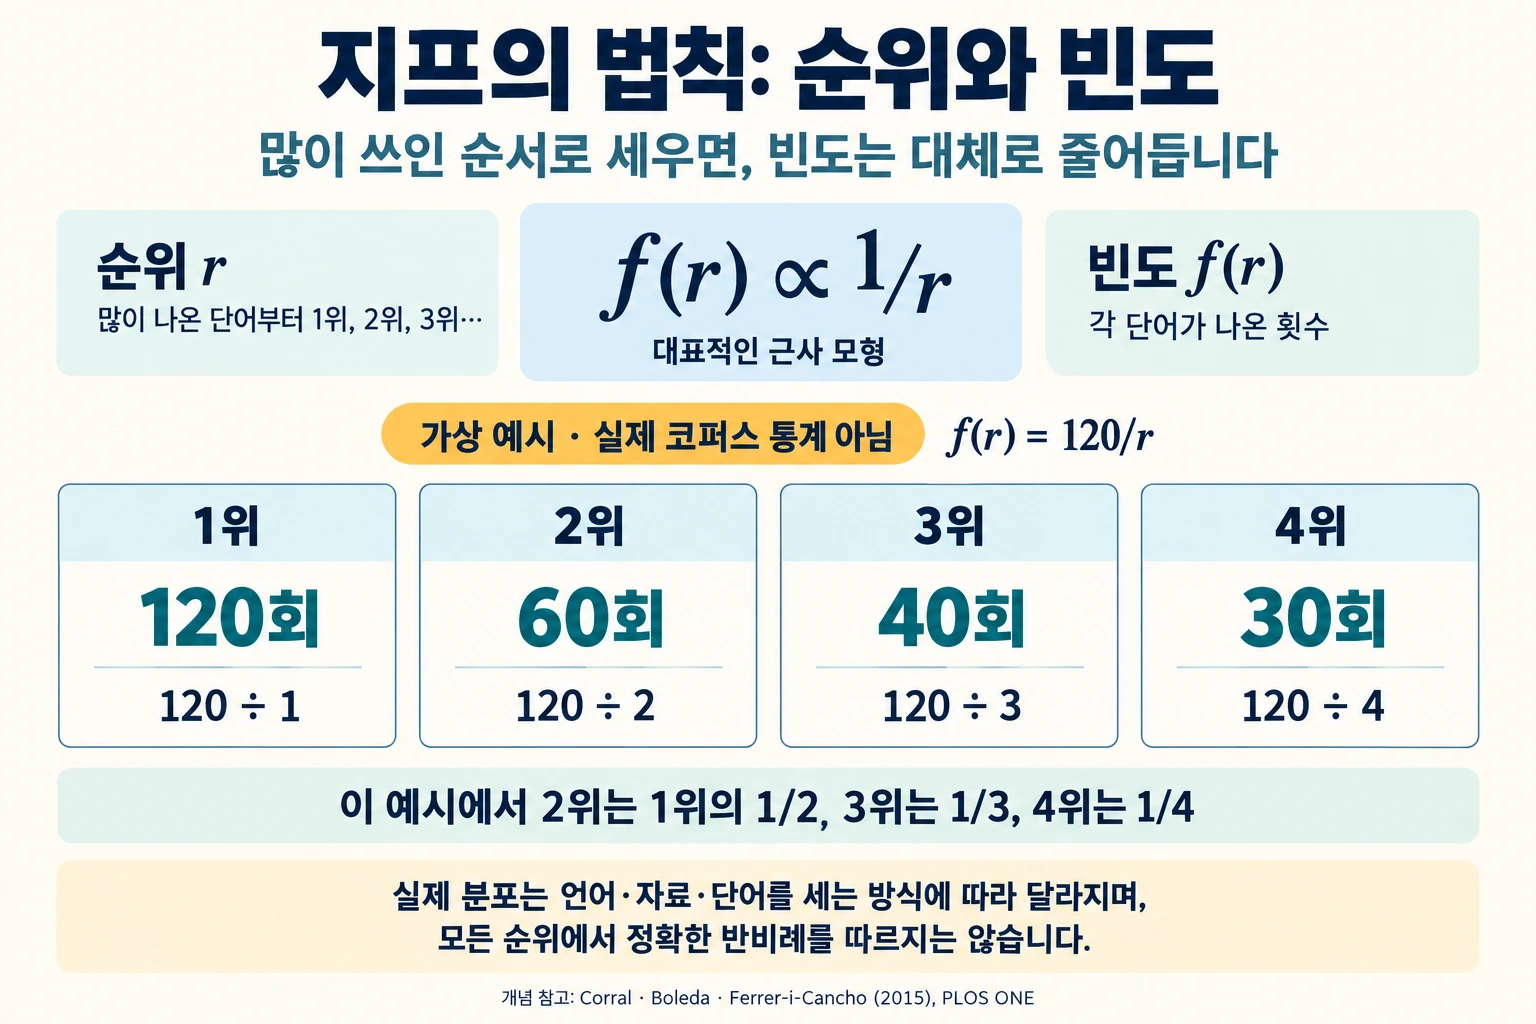
(1)排名第1的词
最常见的词作为基准。在约100万词的美国英语文本集“布朗语料库”(Brown Corpus)中,“the”出现了69,971次,占总数的将近7%。
(2)排名第2的词
使用次数约为第1名的一半。布朗语料库中排名第2的“of”出现了36,411次,略高于总数的3.5%。
(3)排名第3及以后的词
第3名约为第1名的三分之一,第10名约为十分之一。由于使用如此集中在前面,在这个语料库中,仅135个词就占了全部词语使用量的一半。
如果把横轴和纵轴都换成对数刻度来作图,这一关系就会呈现为一条向右下方延伸、近乎笔直的直线。
齐普夫用最省力原则来解释这一现象:说话者想用少量的词传达许多意思,听话者则希望有含义明确的多样词语,这两种力量相互平衡,便形成了这样的分布。
在图书馆和信息检索中的应用
齐普夫定律可以用来甄别文本中哪些词最能体现内容。太常见的词在任何文本中都会出现,太罕见的词则往往是偶然混进来的。
- 停用词表(Stop Word List):把助词、冠词等频率最高的词预先从索引中剔除,以节省存储空间和检索时间。
- 关键词提取(Keyword Extraction):1958年,IBM的汉斯·彼得·卢恩(Hans Peter Luhn)去掉过于常见和过于罕见的词,选取中等频率的词作为关键词,进行了用计算机生成论文摘要的实验。
- 作者判定(Authorship Attribution):每个人使用词语的频率形态相对稳定,因此可以作为判断作者是谁的依据。
- 馆藏与索引规划(Collection and Index Planning):了解到使用集中在少数资料和术语上,就可以确立优先采购和整理最常被查找内容的标准。
论文数量集中在少数作者身上的洛特卡定律,在数学上被解释为与齐普夫定律同属一族的分布;论文集中在少数期刊上的布拉德福定律,也表现出类似的集中现象。这正是文献计量学三大定律被归为一类的原因。
解读齐普夫定律时的注意事项
齐普夫定律的吻合程度高得惊人,但它与其说是精确的自然法则,不如说是从经验中得出的近似值。因此,使用者需要同时了解它的几点局限。
常被指出的局限
- 两端的偏差(Deviation at the Extremes):在排名最高和最低的词中,实际频率与理想比例相差较大。
- 语言差异(Language Differences):像汉语、越南语这样一个音节就构成一个意义单位的语言,有时会明显偏离该定律。
- 关于成因的争论(Debate over Causes):即使是随机敲打字母生成的无意义文本,也会出现类似的分布,因此有人指出,仅靠最省力原则不足以解释这一现象。
实际上,一项分析了3万篇英语文本的研究发现,根据对该定律的不同定义,与之吻合良好的文本比例在约15%到40%之间。以累积分布为标准时约为40%,但仍不到一半。定律只是指明方向的地图,并不是所有文本的标准答案。
齐普夫定律用一个简单的比例告诉我们,我们使用的语言在很大程度上依赖于少数词语。这条约90年前靠手工数词得出的规律,至今仍活跃在停用词处理、关键词提取等各种信息处理技术之中。
在常见词与罕见词之间甄别出真正有意义的词——这正是信息检索的第一步。