機械学習は現代の技術発展の中核を担い、データ革命の中心でさまざまな産業の変化を導いています。膨大なデータの分析と予測に欠かせないツールとして定着した機械学習は、その活用範囲を徐々に広げています。
本資料では、機械学習の基本概念から主要なアルゴリズム、データの準備過程、モデルの評価と最適化の方法まで、幅広く取り上げます。
機械学習の基本概念と動作原理を理解する
機械学習の基本概念
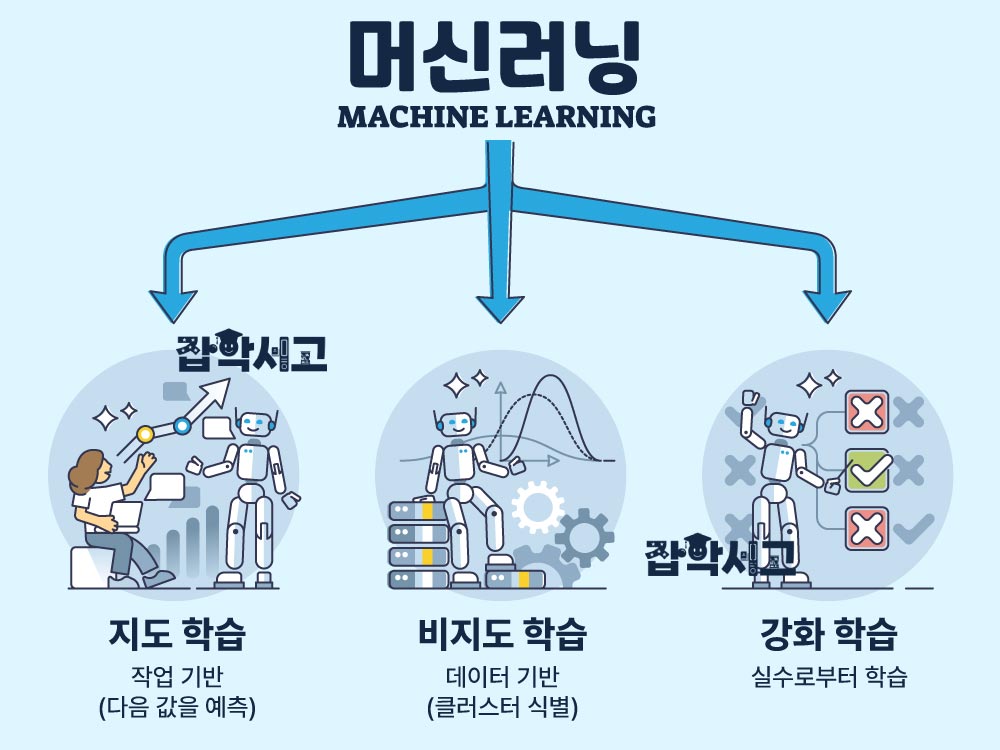
機械学習は、明示的なプログラミングを行わずに、コンピューターがデータを通じて学習し、それに基づいて予測や判断を行えるようにする技術です。人工知能の一分野であり、さまざまなデータを分析して、自ら規則を学習する過程をたどります。機械学習は大きく、教師あり学習、教師なし学習、強化学習の三つに分類されます。それぞれの学習方式はデータの形式や目的に応じて使い分けられ、これによりさまざまな問題を解決できます。
教師あり学習:データと正解を通じた学習
教師あり学習は、与えられたデータとその正解(ラベル)を使ってモデルを学習させる方法です。この方式では、入力データに対する出力値を予測するモデルを作成し、代表的なアルゴリズムとして回帰分析と分類があります。回帰分析は連続的な数値の予測に使われ、分類はデータを離散的なカテゴリーに分けるために使われます。例えば、住宅価格を予測するモデルや、メールのスパムフィルタリングに活用されるアルゴリズムは、教師あり学習の事例です。教師あり学習は、使用するデータが多いほど正確度が高まり、多くの産業で重要な役割を果たしています。
教師なし学習:ラベルのないデータからパターンを見つける
教師なし学習は、正解のないデータを分析し、その中に隠れたパターンや構造を見つけ出す方法です。ラベルがないため、主にデータ自体の特性やクラスターを発見するために使われます。代表的なアルゴリズムにはクラスタリングとアソシエーションルール学習があり、クラスタリングはデータを似たグループに分け、アソシエーションルール学習はデータ間の相関関係を見つけます。この方式は顧客のセグメンテーションや推薦システムなどで多く使われ、データが多いほど、より複雑で精緻なパターンを見つけ出せます。
強化学習:報酬を通じた最適な行動の学習
強化学習は、エージェントが環境と相互作用しながら、報酬を最大化するために最適な行動を学習する方式です。エージェントはさまざまな行動を試し、その結果に応じて報酬を受け取り、それを基に、よりよい判断を下せるように学習します。強化学習は主にゲームAI、ロボット制御、自動運転などで使われ、非常に動的な環境で自ら学習する能力を必要とします。この学習方式では、エージェントが試行錯誤を通じて学習を進めるため、学習過程が長くなることがありますが、その結果として得られる成果は非常に優れています。
データの準備と前処理の重要性
機械学習でモデルの構築を成功させるには、データの準備と前処理が欠かせません。データの前処理には、欠損値の処理、外れ値の除去、データの正規化などが含まれ、これらの処理がなければモデルの性能が大幅に低下する可能性があります。また、モデルに合った適切な特徴量(Feature)を選択し、加工する過程も重要です。データが多ければ必ずよい性能を期待できるわけではなく、適切に整理されたデータが必要です。機械学習モデルの性能はデータの量と質に大きく依存するため、データを慎重に準備する必要があります。
モデルの評価と最適化
モデルの学習後には、その性能を評価し、最適化する過程が必要です。そのためには、訓練データとテストデータを分けて、モデルの予測性能を評価しなければなりません。一般的には交差検証(Cross Validation)を通じてモデルの性能を客観的に測定し、過学習(Overfitting)や学習不足(Underfitting)を防ぐために、ハイパーパラメータの調整も併せて行います。最適な性能を得るには、さまざまな評価指標(例:正解率、適合率、再現率)を使い、モデルの性能を綿密に分析する必要があります。
機械学習の未来と応用
機械学習はさまざまな産業分野に適用され、その応用の可能性は無限に広がっています。金融、医療、製造、サービスなどでは、データの分析と予測を通じて効率を最大化しています。特に、自動運転車、医療診断、個別化広告、金融投資などの分野では、機械学習が発展するにつれて、さらに多くの革新が起こるでしょう。機械学習の未来は引き続き明るく、これを通じて私たちは、よりスマートで効率的な世界を迎えることになるでしょう。
主要な機械学習アルゴリズムとその応用分野
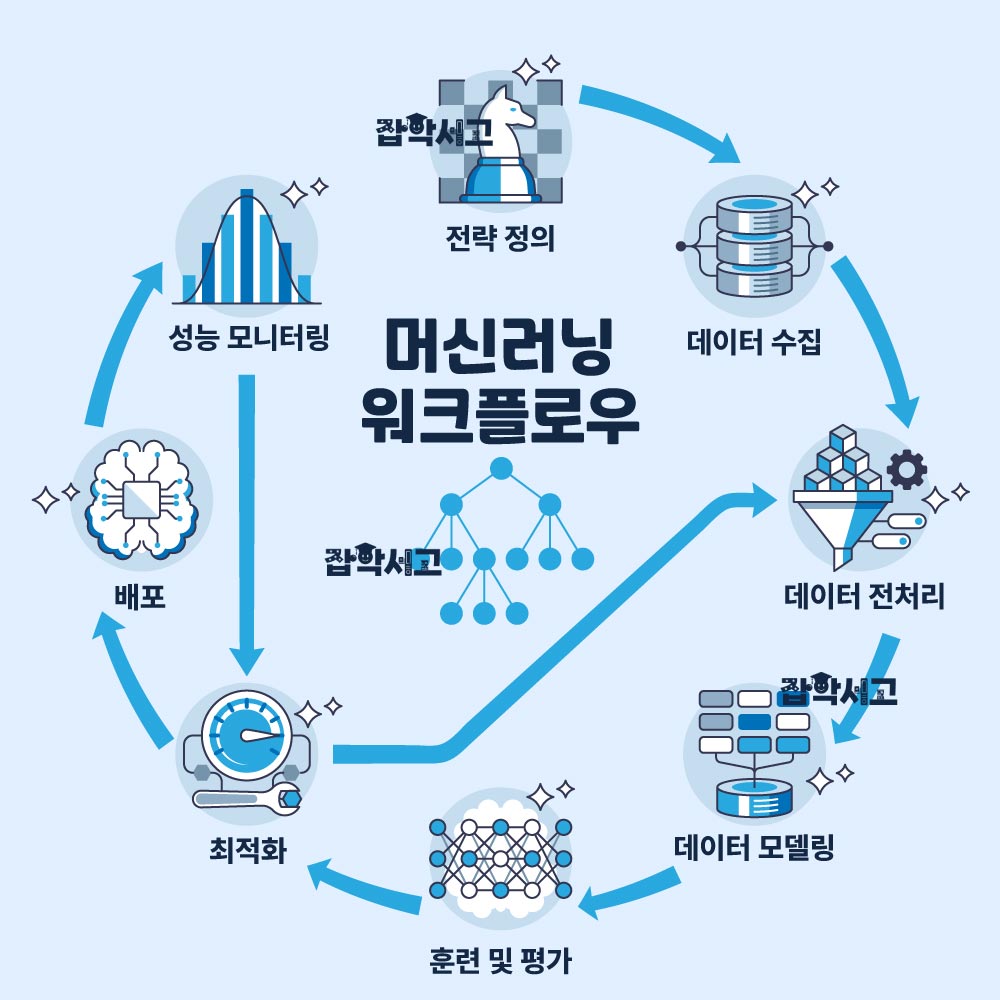
主要な機械学習アルゴリズムの概要
機械学習にはさまざまなアルゴリズムがあり、それぞれが問題の特性に応じた適切な方法を提供します。これらのアルゴリズムは幅広い応用分野で活用され、データの分析と予測に大きく貢献しています。代表的な機械学習アルゴリズムには、線形回帰、ロジスティック回帰、決定木、ランダムフォレスト、サポートベクターマシン(SVM)、k近傍法(k-NN)、ナイーブベイズ、ニューラルネットワークなどがあります。各アルゴリズムには固有の問題解決の方法と目的があるため、その特性を正確に理解して適用することが重要です。
線形回帰:連続データの予測
線形回帰は、連続的なデータの予測に使われる、最も基本的なアルゴリズムの一つです。一つ以上の独立変数と従属変数の間の線形関係をモデル化し、データに基づく予測に重点を置きます。例えば、住宅価格や販売量の予測によく使われます。線形回帰は、データの傾向を把握して将来の値を予測するのに役立ちますが、データが線形でない場合には正確度が低下することがあります。
ロジスティック回帰:二値分類問題の解決
ロジスティック回帰は二値分類問題に適したアルゴリズムで、結果が二つに分かれる問題の解決に使われます。例えば、スパムメールの分類や病気の有無の予測によく活用されます。ロジスティック回帰はデータに基づいて確率を計算し、その結果を通じて分類を行います。特に、分類問題で高い信頼性を提供し、データがある程度複雑な状況でも優れた性能を発揮します。
決定木:直感的で解釈しやすいモデル
決定木は、意思決定を木構造で可視化する方法であり、直感的で解釈しやすいモデルです。各ノードで条件を確認し、それに応じて判断を下す方式で、分類と回帰の両方の問題に使われます。例えば、顧客が離反するかどうかの予測や、特定の製品の推薦に役立ちます。ただし、決定木は過学習(overfitting)が起こりやすく、モデルが複雑になりすぎる可能性があるという欠点があります。
ランダムフォレスト:アンサンブル学習の代表格
ランダムフォレストは、複数の決定木を組み合わせて予測性能を向上させるアンサンブル学習の方法です。単一の決定木よりも安定した正確な予測を提供し、過学習の問題を軽減するのに非常に効果的です。ランダムフォレストは、金融分野の不正検知や信用スコアの予測などで、特によく使われます。また、データの複雑さにかかわらず、高い信頼性を維持できるという利点があります。
サポートベクターマシン(SVM):高次元での分類
サポートベクターマシン(SVM)は、データを高次元空間に変換し、最適な分類境界を見つけるアルゴリズムです。主に顔認識やテキスト分類などの問題で、高い性能を示します。SVMはデータが少ない場合でも優れた性能を発揮し、特に境界が明確な分類問題で強力な能力を示します。ただし、データが多い場合や複雑な場合には、学習時間が長くなることがあります。
ニューラルネットワークとディープラーニング:複雑なパターンの認識
ニューラルネットワークは、人間の脳の構造を模倣したアルゴリズムで、複雑なパターンの認識に優れています。特に、ディープラーニングはニューラルネットワークの一分野で、多層ニューラルネットワークを使い、大規模なデータ分析で優れた性能を発揮します。画像認識、音声認識、自然言語処理などのさまざまな分野で優れた成果を上げており、その活用範囲は徐々に広がっています。ディープラーニングには膨大なデータと高い計算性能が必要ですが、それに見合う革新的な結果を導き出せます。
k近傍法(k-NN):シンプルながら強力なアルゴリズム
k近傍法(k-NN)は、新しいデータを既存のデータと比較し、最も近いk個の近傍を見つけて分類するアルゴリズムです。このアルゴリズムは計算が簡単ですが、大容量のデータでは速度とメモリ使用量が問題になることがあります。主にパターン認識や推薦システムなどで使われ、直感的な方式でデータの類似性に基づいて判断を下します。
ナイーブベイズ:確率に基づく分類
ナイーブベイズは、確率理論に基づく分類アルゴリズムで、条件付き確率を計算してデータを分類します。主にテキスト分類や感情分析などで使われ、シンプルでありながら高い性能を示します。ナイーブベイズは、すべての特徴が独立していると仮定しますが、実際のデータでこの仮定が成り立たなくても、よい結果を導き出せるという利点があります。
アルゴリズム選択の重要性
さまざまな機械学習アルゴリズムは、それぞれの問題状況に合わせて選択し、適用する必要があります。問題の特性やデータの形式に応じて適切なアルゴリズムを選ぶことが重要であり、それにより最適な成果を得られます。機械学習の適用を成功させるには、各アルゴリズムの特性と限界を理解し、問題の解決に最も適した方法を選ぶことが不可欠です。
データの準備と前処理:機械学習を成功させる基礎
データの準備と前処理の重要性
機械学習プロジェクトの成否は、データの準備と前処理がどれほど徹底して行われるかによって決まります。データは機械学習モデルの性能に直接影響するため、すべての過程で慎重な処理が必要です。データの収集、クリーニング、変換、特徴量の抽出と選択などの段階は、モデルの性能を最適化するための基礎作業であり、適切に実施されなければ、機械学習モデルは信頼できる結果を提供できない可能性があります。
データ収集:量と質の確保
データ収集は、モデルを学習させるためのデータを集める最初の段階です。この過程では、ウェブスクレイピング、データベースへのクエリ、API呼び出しなど、さまざまな方法でデータを収集します。データの量はもちろん、その質も非常に重要です。十分な量のデータがあってこそ、モデルはさまざまなパターンを学習でき、データの質が低ければ、モデルの予測の正確度も低下します。そのため、この段階で、できる限り信頼性が高く良質なデータを確保することが重要です。
データクリーニング:ノイズと欠陥の除去
データクリーニングは、収集したデータから誤りや不要な要素を取り除く過程です。欠損値の処理、重複の除去、外れ値の検出と修正などで構成されます。機械学習モデルはデータの品質に大きく依存するため、クリーニングされていないデータが含まれると、誤ったパターンを学習したり、予測の正確度が大幅に低下したりする可能性があります。この段階では特に欠損値の処理が重要で、欠損値を削除したり、適切な方法で補完したりする作業が必要です。誤ったデータが残っているとモデルの性能に大きな影響を与えるため、データクリーニングは入念に行わなければなりません。
データ変換:モデルに合わせたデータ処理
データ変換は、収集したデータをモデルが理解できる形式に変換する過程です。これには、スケーリング、標準化、正規化などの作業が含まれます。例えば、すべての変数の単位をそろえるために標準化を行ったり、カテゴリー変数を数値に変換するワンホットエンコーディング(One-Hot Encoding)が必要になったりすることがあります。こうした変換作業により、モデルはデータを効率的に処理し、学習できるようになります。この過程が正確に行われなければ、モデルがデータの特性を適切に反映できず、性能が低下する可能性があります。
特徴量抽出:重要な情報の強調
特徴量抽出は、元のデータから重要な情報を抽出し、新しい特徴量を作成する過程です。この作業は、モデルの性能を最大化する上で中核となります。例えば、時系列データから周期性や傾向を分析して意味のある特徴量を見つけ出したり、テキストデータから重要なキーワードを抽出したりすることが、特徴量抽出の代表例です。特徴量抽出を通じて、データの本質的な特性をよりよく把握し、モデルが重要なパターンを学習できるよう支援します。
特徴量選択:モデルの性能を最適化するための作業
特徴量選択は、多くの変数の中から、モデルの学習に重要な特徴量だけを選ぶ過程です。不要な変数を取り除くことで、モデルの複雑さを抑え、学習速度と予測の正確度を向上させられます。この過程では、相関分析や主成分分析(PCA)など、さまざまな統計的手法を通じて重要な特徴量を選び、モデルの過学習を防ぎます。不要なデータを除去するとモデルの解釈可能性も高まるため、特徴量選択は機械学習において非常に重要な段階です。
徹底したデータの準備と前処理の必要性
データの準備と前処理は多くの時間を要する作業ですが、機械学習プロジェクトを成功させるために欠かせない過程です。この段階でデータの質と構造を適切に整えてこそ、正確で信頼性の高い予測モデルを構築できます。データサイエンティストは、単にデータを分析するだけでなく、データの特性を理解し、適切に処理する能力を備える必要があります。徹底したデータの前処理がなければ、どれほど複雑なモデルでも、信頼できない結果を導き出さざるを得ません。
機械学習モデルの評価と最適化手法の分析
機械学習モデルの評価の重要性
機械学習モデルを構築した後、その性能を客観的に評価する過程は不可欠です。モデル評価(Evaluation)は、モデルが与えられた問題をどれほど効果的に解決するかを測定する段階で、さまざまな評価指標が使われます。各指標は異なる観点からモデルの性能を分析するため、状況に応じて適切な指標を選ぶ必要があります。
分類モデルの評価指標
分類モデルの評価には、主に正解率(Accuracy)、適合率(Precision)、再現率(Recall)、F1スコア(F1 Score)などの指標が使われます。正解率は、データ全体のうちモデルが正しく予測した割合を示しますが、データの不均衡が著しい場合には、単独で使うには限界があります。適合率は、モデルが陽性と予測したもののうち、実際に陽性である割合を意味し、再現率は、実際の陽性のうち、モデルが陽性と予測した割合です。F1スコアは、適合率と再現率の調和を図った指標で、両指標のバランスを重視するときに役立ちます。例えば、医療診断システムでは再現率が重要ですが、これは実際に陽性である患者をできる限り見逃さないためです。
回帰モデルの評価指標
回帰モデルの性能評価には、平均絶対誤差(MAE)、平均二乗誤差(MSE)、決定係数(R²)などが使われます。MAEは、予測値と実測値の差の絶対値を平均し、モデルの予測誤差を評価する指標です。MSEは、予測値と実測値の差を二乗して平均した値で、大きな誤差をより強く反映します。R²は、モデルがデータをどれほどよく説明しているかを示す指標で、1に近いほど優れたモデルであることを意味します。例えば、住宅価格の予測モデルでは、MSEが予測の正確さを評価する上で重要な役割を果たします。
過学習と学習不足の防止
モデルが学習データに偏りすぎると過学習(Overfitting)が起こり、逆にデータを十分に学習できないと学習不足(Underfitting)が起こります。過学習したモデルは、学習データに対して非常に高い性能を示しますが、新しいデータでは性能が低下します。学習不足は、学習データのパターンを適切に把握できていない状態で、モデルの性能が全般的に低くなります。過学習を防ぐには、データ量を増やしたり、正則化(Regularization)の手法を適用したりできます。一方、学習不足を防ぐには、より複雑なモデルの使用が必要になることがあります。
交差検証によるモデル評価
交差検証(Cross-Validation)は、モデルの汎化性能を評価するのに非常に役立つ方法です。データを複数のフォールドに分けた後、各フォールドについてモデルを学習し、評価する過程です。この方式は、データの分割に伴う評価結果のばらつきを減らし、より正確な性能評価を可能にします。特に、データが少ない場合や、モデルの性能をより正確に評価したい場合に、交差検証が広く使われます。
ハイパーパラメータの最適化
モデルの性能を最大化するには、ハイパーパラメータ最適化(Hyperparameter Optimization)の過程が必要です。ハイパーパラメータは、モデルの学習に直接影響を与える設定値であり、その調整の仕方によって、モデルの性能が大きく変わる可能性があります。グリッドサーチ(Grid Search)は、考えられるすべてのハイパーパラメータの組み合わせを探索する方法で、ランダムサーチ(Random Search)は、一部の組み合わせをランダムに選んで探索する方法です。近年は、より効率的なベイズ最適化(Bayesian Optimization)が導入され、少ない計算量でも最適なハイパーパラメータを見つける上で有利になっています。
モデルの複雑さと性能のバランス
最適化の過程で重要なのは、モデルの複雑さと性能のバランスを保つことです。モデルが複雑すぎると過学習が起こる可能性が高まり、逆に単純すぎると学習不足が起こることがあります。これを解決するには、正則化(Regularization)の手法を活用してモデルの複雑さを制御したり、ドロップアウト(Dropout)によってニューラルネットワークモデルの過学習を防いだりできます。最終的には、複雑さと性能を適切に調整し、汎化性能を備えたモデルを構築することが最適化の目標です。
評価と最適化の重要性
機械学習モデルの評価と最適化は、単なる選択肢ではなく、機械学習プロジェクトを成功させるために不可欠な過程です。評価指標を通じてモデルの性能を綿密に分析し、ハイパーパラメータの最適化を通じてモデルの性能を最大化する必要があります。これにより、過学習と学習不足の問題を解決し、データに合った最適なモデルを構築できます。
機械学習は現代のデータ分析において重要な位置を占め、さまざまな分野で革新的な変化を主導しています。これを効果的に活用するには、機械学習の基本概念を十分に理解し、適切なアルゴリズムの選択と、徹底したデータの準備および前処理を行う必要があります。
また、モデルの性能を評価し、最適化する過程は、機械学習の成功において非常に重要な部分です。こうした過程を通じて、より正確な予測と効果的な意思決定が可能になり、データ革命の時代に適した革新的な解決策を提示できます。