今日、私たちが触れるAI技術の多くは、「ディープラーニング(Deep Learning)」を基盤として動作しています。スマートフォンの顔認識、生成AIサービス、自動運転車、リアルタイム翻訳機など、現代の情報技術(IT)における最も革新的な変化の背後には、常にディープラーニングが存在しています。
しかし、いざ「ディープラーニングとは正確には何ですか?」と聞かれると、すぐには説明できない人も多いものです。本資料では、ディープラーニングの基本概念から機械学習との違い、動作原理、そして実際の応用例まで、要点をわかりやすく解説します。
ディープラーニングの概念:人間の脳を模倣した技術

ディープラーニングは、人工知能(AI)という大きなカテゴリーに属する機械学習(Machine Learning)の一分野です。
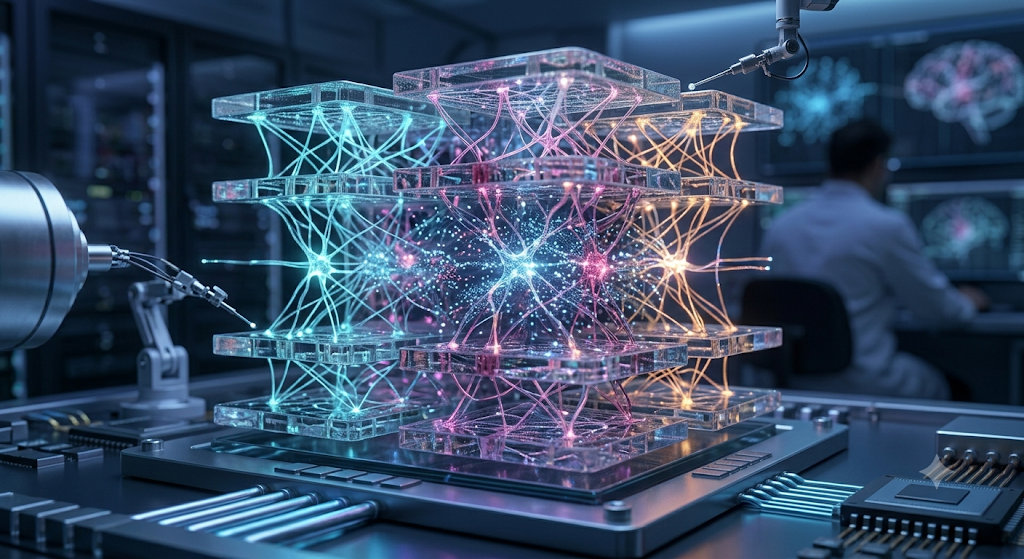
人間の脳では、数百億個もの神経細胞(ニューロン)が複雑につながり、外部からの刺激を受け取り、判断を行います。ディープラーニングは、こうした人間の脳の神経回路網の構造を数学的モデルで模倣した「人工ニューラルネットワーク(Artificial Neural Network)」を基盤として動作します。
ここで「ディープ(Deep、深い)」という言葉が付いているのは、入力されたデータを処理する人工ニューラルネットワークの層(Layer)が、幾つもの段階を経て非常に深く積み重なっている(Multi-layered)ためです。
機械学習とディープラーニングの決定的な違い
多くの人が機械学習とディープラーニングを混同して使っていますが、両者には本質的な違いがあります。ディープラーニングは、複数の層からなるニューラルネットワークで特徴表現を学習する、機械学習の一分野です。従来の手法では人間が設計した特徴を使う場合が多いものの、特徴の学習はディープラーニングだけで可能なわけではありません。
- 従来の機械学習の一例:人間が画像の特徴を設計し、モデルはその特徴と学習データを基に分類ルールを学習します。
- ディープラーニング:コンピューターに数万枚の猫と犬の写真を与えるだけで済みます。ディープラーニングのアルゴリズムは自ら写真を分析し、猫に特有のパターンや特徴を見つけ出して学習します。
[身近なたとえで理解する:従来のプログラミング vs ディープラーニング]
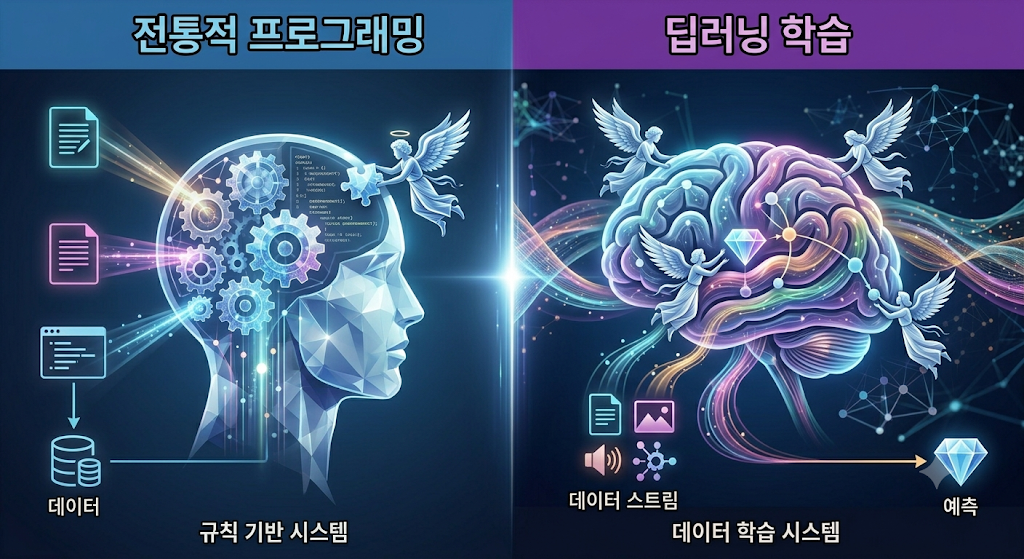
- 従来のプログラミング:料理本に書かれたレシピどおりに料理をする人のように、人間が明示したルールを実行する方式
- ディープラーニング:数百種類の料理を味わった後、自ら食材の組み合わせや火加減のルールをつかみ、新しい料理を生み出す専門家
ディープラーニングはどのように学習するのか?(動作原理と例)
ディープラーニングの内部構造は、大きく3種類の層に分かれます。
ア.入力層(Input Layer):元のデータ(画像、音声、テキストなど)を受け取る段階
イ.隠れ層(Hidden Layer):データの特徴を段階的に抽出し、演算する段階(複数の層が存在)
ウ.出力層(Output Layer):最終的な判断や予測結果を出す段階
[猫の写真を認識するディープラーニングの段階的な学習過程]
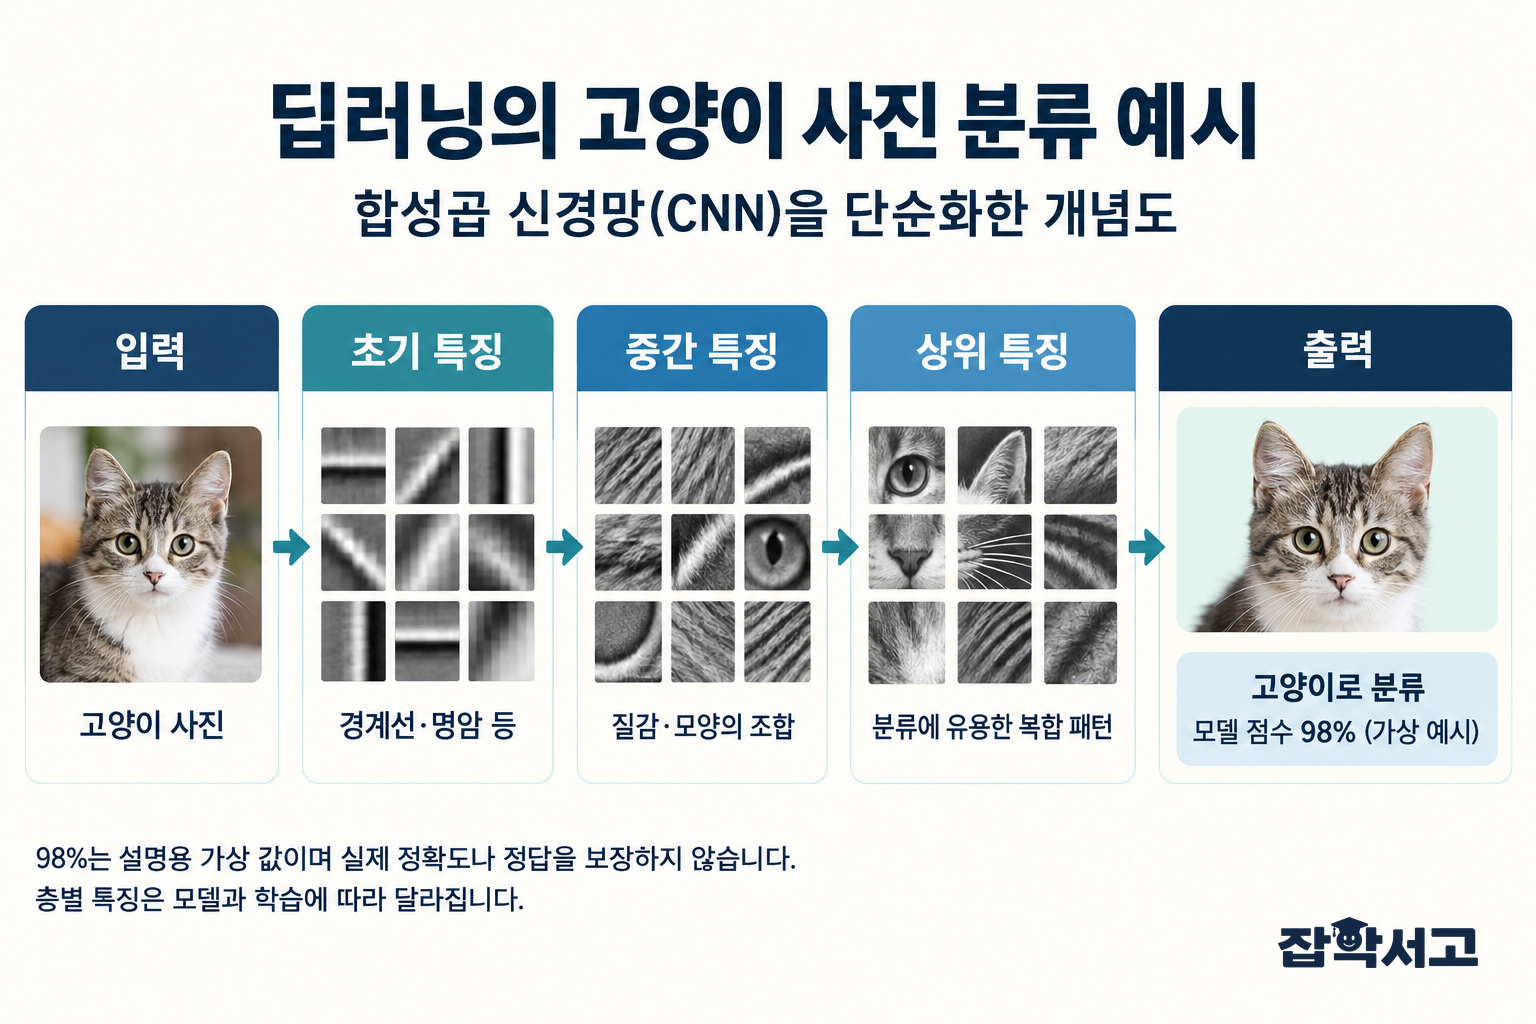
コンピューターが猫の写真を受け取ると、隠れ層では次のようなことが起こります。
- 初期の隠れ層:画像の最も単純な要素である線、明暗、境界線(Edge)を検出します。
- 中間の隠れ層:抽出した線を組み合わせ、質感、曲線、簡単な形(耳の形、瞳の形)を形成します。
- 上位の隠れ層:形を総合して、「猫の顔全体の形」という複合的な構造を完成させます。
- 出力層:「この写真は98%の確率で猫です」という結論を出します。
学習の初期段階では、コンピューターも数多くの予測を間違えます。しかし、予測結果と実際の正解との誤差を計算した後、その誤差を減らす方向に、ニューラルネットワーク内部の結合の強さ(重み、Weight)を後ろから前へとさかのぼりながら修正していきます。これを「誤差逆伝播法(Backpropagation)」というアルゴリズムと呼び、この過程を数百万回繰り返すことで、人工知能は次第に正確な判断能力を身につけていきます。
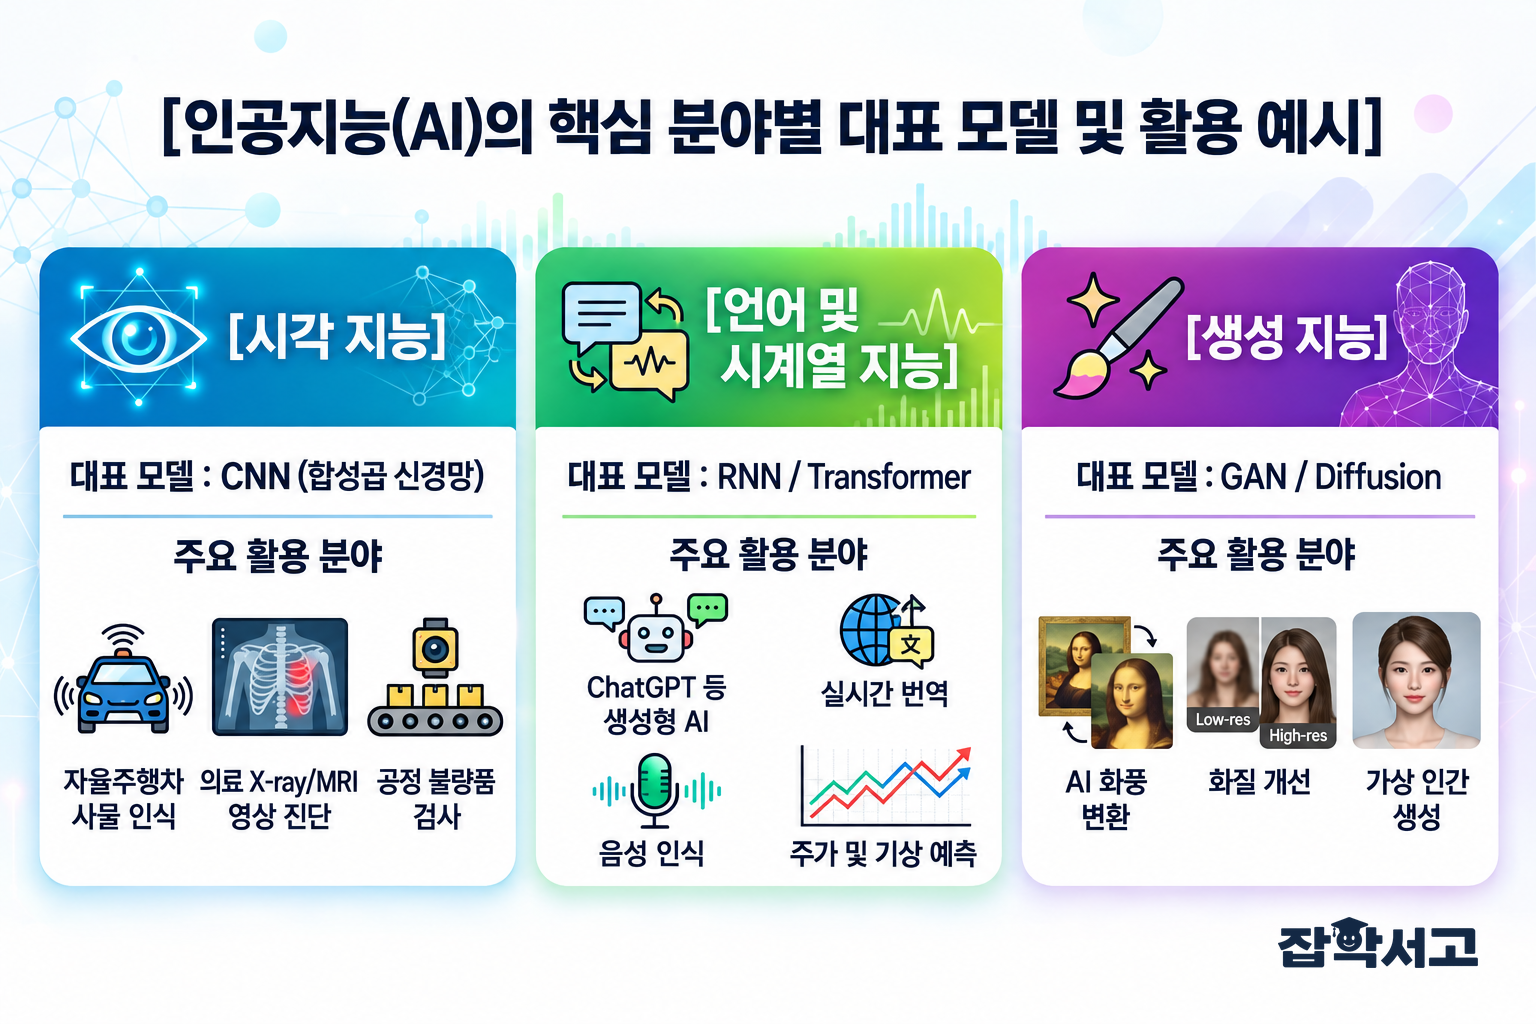
ディープラーニングの代表的な活用分野
ディープラーニングは、扱うデータの種類に応じて最適化されたモデルへと発展してきました。
ディープラーニングの限界と課題
ディープラーニングは優れた性能を誇りますが、乗り越えるべき明確な課題も存在します。
ブラックボックス問題(Explainability)
ディープラーニングは数億個の重みを使って結論を出すため、「なぜその結論に至ったのか」という過程を人間がさかのぼって説明することは困難です。医療や金融、法律など、説明責任が重要な分野では大きな障壁となります。
膨大なデータと資源の消費
高性能なディープラーニングモデルを学習させるには、大規模な計算資源(GPU/NPU)と膨大な電力が消費され、良質なデータセットが不可欠です。
情報技術の未来を変える中核的な原動力
ディープラーニングは、単なるコンピューター技術の進歩を超えて、人間が世界を分析し、問題を解決する方法を根本から変えています。単純な反復作業の自動化にとどまらず、超個別化サービス、新薬開発、気候変動予測など、人類が直面する複雑な問題を解決する中核的なツールとして定着しました。
情報技術の観点からディープラーニングを理解することは、単に最新のトレンドを把握するだけでなく、これから訪れるデータに基づく社会の仕組みを理解する第一歩となるでしょう。