Học máy là yếu tố cốt lõi trong sự phát triển công nghệ hiện đại, thúc đẩy những thay đổi trong nhiều ngành ngay tại trung tâm của cuộc cách mạng dữ liệu. Đã trở thành công cụ thiết yếu để phân tích và dự đoán từ lượng dữ liệu khổng lồ, học máy đang ngày càng mở rộng phạm vi ứng dụng.
Tài liệu này sẽ trình bày toàn diện từ các khái niệm cơ bản của học máy đến những thuật toán chủ yếu, quy trình chuẩn bị dữ liệu, cùng các phương pháp đánh giá và tối ưu hóa mô hình.
Tìm hiểu các khái niệm cơ bản và nguyên lý hoạt động của học máy
Khái niệm cơ bản về học máy
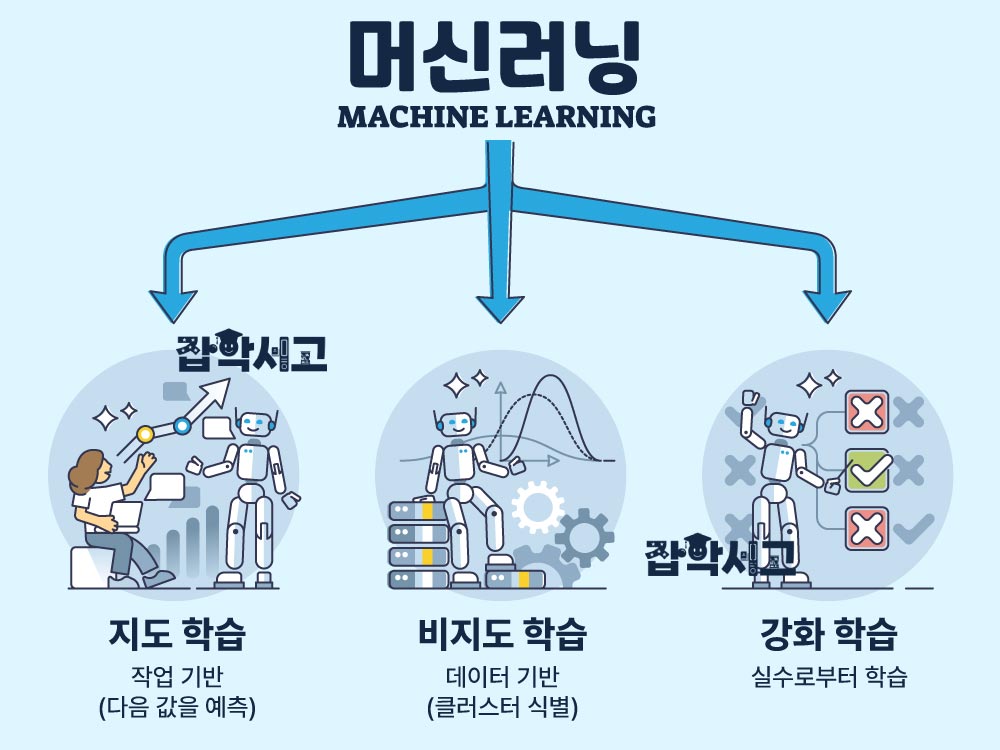
Học máy là công nghệ cho phép máy tính học từ dữ liệu mà không cần được lập trình tường minh, từ đó đưa ra dự đoán hoặc quyết định. Đây là một lĩnh vực của trí tuệ nhân tạo, trong đó máy tính phân tích nhiều loại dữ liệu và tự học các quy luật. Học máy được chia thành ba loại chính: học có giám sát, học không giám sát và học tăng cường. Mỗi phương thức học được áp dụng khác nhau tùy theo dạng dữ liệu hoặc mục tiêu, qua đó có thể giải quyết nhiều vấn đề khác nhau.
Học có giám sát: học từ dữ liệu và đáp án
Học có giám sát là phương pháp huấn luyện mô hình bằng dữ liệu cho trước và đáp án tương ứng (nhãn). Phương thức này tạo ra mô hình dự đoán giá trị đầu ra từ dữ liệu đầu vào, với các thuật toán tiêu biểu là phân tích hồi quy và phân loại. Phân tích hồi quy được dùng để dự đoán các giá trị số liên tục, còn phân loại được dùng để chia dữ liệu thành các nhóm rời rạc. Chẳng hạn, mô hình dự đoán giá nhà hoặc thuật toán dùng để lọc thư rác là những ví dụ về học có giám sát. Học có giám sát càng sử dụng nhiều dữ liệu thì độ chính xác càng cao và đóng vai trò quan trọng trong nhiều ngành.
Học không giám sát: tìm mẫu trong dữ liệu không có nhãn
Học không giám sát là phương pháp phân tích dữ liệu không có đáp án để tìm ra các mẫu hoặc cấu trúc ẩn bên trong. Vì không có nhãn, phương pháp này chủ yếu được dùng để khám phá các đặc tính hoặc cụm của chính dữ liệu. Các thuật toán tiêu biểu gồm phân cụm và học luật kết hợp; phân cụm chia dữ liệu thành những nhóm tương đồng, còn học luật kết hợp tìm mối tương quan giữa các dữ liệu. Phương thức này được sử dụng nhiều trong phân khúc khách hàng, hệ thống gợi ý và các ứng dụng khác; dữ liệu càng nhiều thì càng có thể tìm ra những mẫu phức tạp và tinh vi hơn.
Học tăng cường: học hành động tối ưu thông qua phần thưởng
Học tăng cường là phương thức trong đó tác tử tương tác với môi trường và học hành động tối ưu để tối đa hóa phần thưởng. Tác tử thử nhiều hành động khác nhau, nhận phần thưởng dựa trên kết quả của những hành động đó, rồi học từ đó để đưa ra quyết định tốt hơn. Học tăng cường chủ yếu được sử dụng trong AI trò chơi, điều khiển robot, lái xe tự động và các lĩnh vực tương tự, đòi hỏi khả năng tự học trong môi trường biến động mạnh. Vì tác tử học thông qua thử và sai nên quá trình học có thể kéo dài, nhưng kết quả thu được rất tốt.
Tầm quan trọng của việc chuẩn bị và tiền xử lý dữ liệu
Để xây dựng thành công mô hình học máy, việc chuẩn bị và tiền xử lý dữ liệu là thiết yếu. Quy trình tiền xử lý dữ liệu bao gồm xử lý giá trị thiếu, loại bỏ giá trị ngoại lai, chuẩn hóa dữ liệu và các công việc khác; nếu không có những bước này, hiệu năng mô hình có thể suy giảm đáng kể. Ngoài ra, việc lựa chọn và xử lý các đặc trưng (Feature) phù hợp với mô hình cũng rất quan trọng. Có nhiều dữ liệu không đồng nghĩa với việc chắc chắn đạt hiệu năng tốt; điều cần thiết là dữ liệu được sắp xếp và xử lý phù hợp. Hiệu năng của mô hình học máy phụ thuộc nhiều vào số lượng và chất lượng dữ liệu, vì vậy cần chuẩn bị dữ liệu cẩn thận.
Đánh giá và tối ưu hóa mô hình
Sau khi huấn luyện mô hình, cần có quá trình đánh giá và tối ưu hóa hiệu năng của nó. Để thực hiện điều này, cần chia dữ liệu thành dữ liệu huấn luyện và dữ liệu kiểm thử nhằm đánh giá khả năng dự đoán của mô hình. Thông thường, kiểm định chéo (Cross Validation) được dùng để đo lường hiệu năng mô hình một cách khách quan, đồng thời tiến hành tinh chỉnh siêu tham số để ngăn ngừa quá khớp (Overfitting) hoặc thiếu khớp (Underfitting). Để đạt hiệu năng tối ưu, cần phân tích kỹ hiệu năng mô hình bằng nhiều chỉ số đánh giá khác nhau, chẳng hạn độ chính xác, độ chuẩn xác và độ bao phủ.
Tương lai và ứng dụng của học máy
Học máy được áp dụng trong nhiều ngành và có tiềm năng ứng dụng vô tận. Trong tài chính, y tế, sản xuất, dịch vụ và các lĩnh vực khác, học máy đang tối đa hóa hiệu quả thông qua phân tích dữ liệu và dự đoán. Đặc biệt, trong những lĩnh vực như xe tự lái, chẩn đoán y khoa, quảng cáo cá nhân hóa và đầu tư tài chính, học máy càng phát triển thì càng có nhiều đổi mới xuất hiện. Tương lai của học máy tiếp tục tươi sáng, và nhờ đó, chúng ta sẽ đón nhận một thế giới thông minh và hiệu quả hơn.
Các thuật toán học máy chủ yếu và lĩnh vực ứng dụng
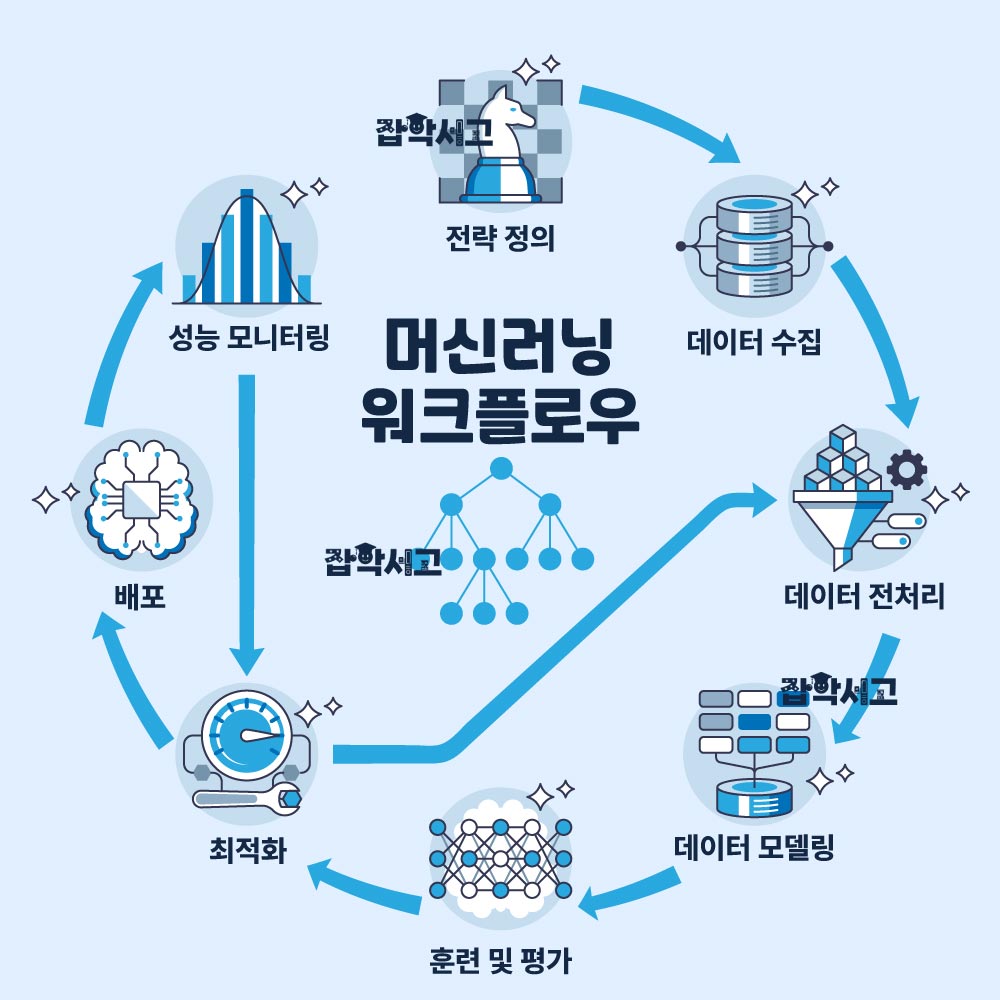
Tổng quan về các thuật toán học máy chủ yếu
Học máy có nhiều thuật toán, mỗi thuật toán cung cấp phương pháp phù hợp tùy theo đặc điểm của vấn đề. Các thuật toán này được sử dụng trong nhiều lĩnh vực ứng dụng, đóng góp lớn cho việc phân tích dữ liệu và dự đoán. Những thuật toán học máy tiêu biểu gồm hồi quy tuyến tính, hồi quy logistic, cây quyết định, rừng ngẫu nhiên, máy vectơ hỗ trợ (SVM), k láng giềng gần nhất (k-NN), Naive Bayes và mạng nơ-ron. Mỗi thuật toán có cách giải quyết vấn đề và mục đích riêng, vì vậy cần hiểu chính xác đặc điểm của chúng để áp dụng.
Hồi quy tuyến tính: dự đoán dữ liệu liên tục
Hồi quy tuyến tính là một trong những thuật toán cơ bản nhất được dùng để dự đoán dữ liệu liên tục. Thuật toán này mô hình hóa quan hệ tuyến tính giữa một hoặc nhiều biến độc lập với biến phụ thuộc, tập trung vào việc dự đoán dựa trên dữ liệu. Chẳng hạn, hồi quy tuyến tính được sử dụng nhiều trong dự đoán giá nhà hoặc doanh số bán hàng. Hồi quy tuyến tính hữu ích để xác định xu hướng dữ liệu và dự đoán giá trị tương lai, nhưng độ chính xác có thể giảm nếu dữ liệu không có tính tuyến tính.
Hồi quy logistic: giải quyết bài toán phân loại nhị phân
Hồi quy logistic là thuật toán phù hợp với bài toán phân loại nhị phân, được dùng để giải quyết những vấn đề có kết quả chia thành hai loại. Chẳng hạn, thuật toán này được ứng dụng nhiều trong phân loại thư rác hoặc dự đoán có mắc bệnh hay không. Hồi quy logistic tính xác suất dựa trên dữ liệu rồi sử dụng kết quả đó để thực hiện phân loại. Đặc biệt, thuật toán này mang lại độ tin cậy cao trong các bài toán phân loại và đạt hiệu năng tốt ngay cả khi dữ liệu có độ phức tạp vừa phải.
Cây quyết định: mô hình trực quan và dễ diễn giải
Cây quyết định là phương pháp trực quan hóa việc ra quyết định dưới dạng cấu trúc cây, tạo nên mô hình trực quan và dễ diễn giải. Mô hình kiểm tra điều kiện tại từng nút rồi đưa ra quyết định tương ứng, được sử dụng cho cả bài toán phân loại và hồi quy. Chẳng hạn, cây quyết định hữu ích trong việc dự đoán khách hàng có rời bỏ dịch vụ hay không hoặc gợi ý sản phẩm cụ thể. Tuy nhiên, cây quyết định dễ xảy ra quá khớp (overfitting), với nhược điểm là mô hình có thể trở nên quá phức tạp.
Rừng ngẫu nhiên: đại diện tiêu biểu của học tổ hợp
Rừng ngẫu nhiên là phương pháp học tổ hợp kết hợp nhiều cây quyết định để cải thiện hiệu năng dự đoán. Phương pháp này cung cấp dự đoán ổn định và chính xác hơn so với một cây quyết định đơn lẻ, đồng thời rất hiệu quả trong việc giảm vấn đề quá khớp. Rừng ngẫu nhiên được sử dụng đặc biệt nhiều trong lĩnh vực tài chính, chẳng hạn phát hiện gian lận và dự đoán điểm tín dụng. Ngoài ra, phương pháp này còn có ưu điểm là duy trì độ tin cậy cao bất kể độ phức tạp của dữ liệu.
Máy vectơ hỗ trợ (SVM): phân loại trong không gian nhiều chiều
Máy vectơ hỗ trợ (SVM) là thuật toán biến đổi dữ liệu sang không gian nhiều chiều để tìm ranh giới phân loại tối ưu. Thuật toán này chủ yếu cho hiệu năng cao trong các bài toán như nhận diện khuôn mặt và phân loại văn bản. SVM đạt hiệu năng tốt ngay cả khi dữ liệu ít, đặc biệt thể hiện khả năng mạnh mẽ trong những bài toán phân loại có ranh giới rõ ràng. Tuy nhiên, khi dữ liệu nhiều hoặc phức tạp, thời gian huấn luyện có thể kéo dài.
Mạng nơ-ron và học sâu: nhận diện các mẫu phức tạp
Mạng nơ-ron là thuật toán mô phỏng cấu trúc não người, có khả năng vượt trội trong việc nhận diện các mẫu phức tạp. Đặc biệt, học sâu là một nhánh của mạng nơ-ron, sử dụng mạng nơ-ron nhiều lớp để đạt hiệu năng tốt trong phân tích dữ liệu quy mô lớn. Học sâu đang cho thấy thành quả nổi bật trong nhiều lĩnh vực như nhận diện hình ảnh, nhận dạng giọng nói và xử lý ngôn ngữ tự nhiên, đồng thời phạm vi ứng dụng ngày càng mở rộng. Học sâu đòi hỏi lượng dữ liệu khổng lồ và năng lực tính toán cao, nhưng cũng có thể tạo ra những kết quả đột phá tương xứng.
k láng giềng gần nhất (k-NN): thuật toán đơn giản nhưng mạnh mẽ
k láng giềng gần nhất (k-NN) là thuật toán so sánh dữ liệu mới với dữ liệu hiện có, tìm k láng giềng gần nhất để phân loại. Thuật toán này có cách tính toán đơn giản, nhưng với dữ liệu dung lượng lớn, tốc độ và mức sử dụng bộ nhớ có thể trở thành vấn đề. Thuật toán chủ yếu được dùng trong nhận diện mẫu, hệ thống gợi ý và các ứng dụng tương tự, đưa ra quyết định dựa trên sự tương đồng của dữ liệu theo cách trực quan.
Naive Bayes: phân loại dựa trên xác suất
Naive Bayes là thuật toán phân loại dựa trên lý thuyết xác suất, phân loại dữ liệu bằng cách tính xác suất có điều kiện. Thuật toán này chủ yếu được sử dụng trong phân loại văn bản, phân tích cảm xúc và các ứng dụng tương tự, vừa đơn giản vừa cho hiệu năng cao. Naive Bayes giả định mọi đặc trưng đều độc lập, nhưng có ưu điểm là vẫn có thể cho kết quả tốt ngay cả khi giả định này không đúng với dữ liệu thực tế.
Tầm quan trọng của việc lựa chọn thuật toán
Các thuật toán học máy khác nhau cần được lựa chọn và áp dụng phù hợp với từng tình huống của bài toán. Việc chọn thuật toán phù hợp dựa trên đặc điểm của vấn đề và dạng dữ liệu rất quan trọng, giúp đạt được kết quả tối ưu. Để áp dụng học máy thành công, cần hiểu đặc điểm và giới hạn của từng thuật toán, đồng thời lựa chọn phương pháp phù hợp nhất để giải quyết vấn đề.
Chuẩn bị và tiền xử lý dữ liệu: nền tảng để học máy thành công
Tầm quan trọng của việc chuẩn bị và tiền xử lý dữ liệu
Thành bại của một dự án học máy được quyết định bởi mức độ kỹ lưỡng của quá trình chuẩn bị và tiền xử lý dữ liệu. Vì dữ liệu ảnh hưởng trực tiếp đến hiệu năng của mô hình học máy nên cần được xử lý cẩn thận trong mọi công đoạn. Các bước như thu thập, làm sạch, biến đổi dữ liệu, trích xuất và lựa chọn đặc trưng là những công việc nền tảng để tối ưu hóa hiệu năng mô hình; nếu không được thực hiện đúng cách, mô hình học máy có thể không cung cấp được kết quả đáng tin cậy.
Thu thập dữ liệu: bảo đảm số lượng và chất lượng
Thu thập dữ liệu là bước đầu tiên để tập hợp dữ liệu phục vụ huấn luyện mô hình. Trong quá trình này, dữ liệu được thu thập bằng nhiều phương pháp như thu thập dữ liệu web, truy vấn cơ sở dữ liệu và gọi API. Không chỉ số lượng mà chất lượng dữ liệu cũng rất quan trọng. Cần có đủ dữ liệu để mô hình học được nhiều mẫu khác nhau, và nếu chất lượng dữ liệu thấp thì độ chính xác dự đoán của mô hình cũng giảm. Vì vậy, ở bước này, điều quan trọng là thu thập dữ liệu đáng tin cậy và có chất lượng cao nhất có thể.
Làm sạch dữ liệu: loại bỏ nhiễu và khiếm khuyết
Làm sạch dữ liệu là quá trình loại bỏ lỗi hoặc các yếu tố không cần thiết khỏi dữ liệu đã thu thập. Quá trình này gồm xử lý giá trị thiếu, loại bỏ dữ liệu trùng lặp, phát hiện và sửa giá trị ngoại lai. Mô hình học máy phụ thuộc nhiều vào chất lượng dữ liệu, vì vậy nếu có dữ liệu chưa được làm sạch, mô hình có thể học sai các mẫu hoặc độ chính xác dự đoán suy giảm đáng kể. Ở bước này, xử lý giá trị thiếu đặc biệt quan trọng, đòi hỏi phải xóa các giá trị thiếu hoặc thay thế chúng bằng phương pháp phù hợp. Vì dữ liệu sai còn sót lại có thể ảnh hưởng lớn đến hiệu năng mô hình, việc làm sạch dữ liệu cần được thực hiện kỹ lưỡng.
Biến đổi dữ liệu: xử lý dữ liệu phù hợp với mô hình
Biến đổi dữ liệu là quá trình chuyển dữ liệu đã thu thập sang dạng mà mô hình có thể hiểu. Quá trình này bao gồm điều chỉnh thang đo, chuẩn hóa theo phân phối, chuẩn hóa thang giá trị và các thao tác khác. Chẳng hạn, có thể cần chuẩn hóa theo phân phối để đưa đơn vị của mọi biến về cùng một thang đo, hoặc sử dụng mã hóa one-hot (One-Hot Encoding) để chuyển biến phân loại thành dạng số. Những thao tác biến đổi này giúp mô hình xử lý và học từ dữ liệu một cách hiệu quả. Nếu quá trình này không được thực hiện chính xác, mô hình có thể không phản ánh đúng đặc điểm dữ liệu, dẫn đến hiệu năng suy giảm.
Trích xuất đặc trưng: làm nổi bật thông tin quan trọng
Trích xuất đặc trưng là quá trình lấy thông tin quan trọng từ dữ liệu gốc để tạo ra các đặc trưng mới. Công việc này có vai trò cốt lõi trong việc tối đa hóa hiệu năng mô hình. Chẳng hạn, phân tích tính chu kỳ hoặc xu hướng trong dữ liệu chuỗi thời gian để tìm ra đặc trưng có ý nghĩa, hoặc trích xuất từ khóa quan trọng từ dữ liệu văn bản là những ví dụ tiêu biểu về trích xuất đặc trưng. Trích xuất đặc trưng giúp nắm bắt tốt hơn các đặc tính bản chất của dữ liệu và hỗ trợ mô hình học những mẫu quan trọng.
Lựa chọn đặc trưng: công việc nhằm tối ưu hóa hiệu năng mô hình
Lựa chọn đặc trưng là quá trình chỉ chọn những đặc trưng quan trọng cho việc huấn luyện mô hình trong số nhiều biến. Loại bỏ các biến không cần thiết có thể giảm độ phức tạp của mô hình, tăng tốc độ huấn luyện và cải thiện độ chính xác dự đoán. Trong quá trình này, các đặc trưng quan trọng được lựa chọn thông qua nhiều phương pháp thống kê như phân tích tương quan và phân tích thành phần chính (PCA), đồng thời ngăn mô hình bị quá khớp. Loại bỏ dữ liệu không cần thiết cũng giúp tăng khả năng diễn giải mô hình, vì vậy lựa chọn đặc trưng là bước rất quan trọng trong học máy.
Sự cần thiết của việc chuẩn bị và tiền xử lý dữ liệu kỹ lưỡng
Chuẩn bị và tiền xử lý dữ liệu là công việc tốn nhiều thời gian nhưng là quá trình thiết yếu để một dự án học máy thành công. Chỉ khi chất lượng và cấu trúc dữ liệu được chuẩn bị phù hợp ở bước này mới có thể xây dựng mô hình dự đoán chính xác và đáng tin cậy. Nhà khoa học dữ liệu cần có khả năng không chỉ phân tích dữ liệu mà còn hiểu đặc điểm của dữ liệu và xử lý phù hợp. Nếu không tiền xử lý dữ liệu kỹ lưỡng, dù mô hình phức tạp đến đâu cũng sẽ cho kết quả không đáng tin cậy.
Phân tích các phương pháp đánh giá và tối ưu hóa mô hình học máy
Tầm quan trọng của việc đánh giá mô hình học máy
Sau khi xây dựng mô hình học máy, việc đánh giá hiệu năng một cách khách quan là thiết yếu. Đánh giá mô hình (Evaluation) là bước đo lường mức độ hiệu quả của mô hình trong việc giải quyết vấn đề được giao, sử dụng nhiều chỉ số đánh giá khác nhau. Mỗi chỉ số phân tích hiệu năng mô hình từ một góc nhìn khác nhau, và cần lựa chọn chỉ số phù hợp tùy theo tình huống.
Các chỉ số đánh giá mô hình phân loại
Khi đánh giá mô hình phân loại, các chỉ số thường được sử dụng gồm độ chính xác (Accuracy), độ chuẩn xác (Precision), độ bao phủ (Recall) và điểm F1 (F1 Score). Độ chính xác thể hiện tỷ lệ dữ liệu mà mô hình dự đoán đúng trên toàn bộ dữ liệu, nhưng có hạn chế khi sử dụng riêng lẻ nếu dữ liệu mất cân bằng nghiêm trọng. Độ chuẩn xác là tỷ lệ trường hợp thực sự dương tính trong số các trường hợp mô hình dự đoán là dương tính, còn độ bao phủ là tỷ lệ trường hợp được mô hình dự đoán là dương tính trong số các trường hợp thực sự dương tính. Điểm F1 là chỉ số kết hợp hài hòa độ chuẩn xác và độ bao phủ, hữu ích khi cần nhấn mạnh sự cân bằng giữa hai chỉ số. Chẳng hạn, trong hệ thống chẩn đoán y khoa, độ bao phủ rất quan trọng nhằm hạn chế tối đa việc bỏ sót bệnh nhân thực sự dương tính.
Các chỉ số đánh giá mô hình hồi quy
Để đánh giá hiệu năng mô hình hồi quy, người ta sử dụng sai số tuyệt đối trung bình (MAE), sai số bình phương trung bình (MSE), hệ số xác định (R²) và các chỉ số khác. MAE là chỉ số đánh giá sai số dự đoán của mô hình bằng cách lấy trung bình giá trị tuyệt đối của chênh lệch giữa giá trị dự đoán và giá trị thực tế. MSE là giá trị trung bình của bình phương chênh lệch giữa giá trị dự đoán và giá trị thực tế, nên phản ánh mạnh hơn các sai số lớn. R² là chỉ số thể hiện mức độ mô hình giải thích dữ liệu, càng gần 1 thì mô hình càng tốt. Chẳng hạn, trong mô hình dự đoán giá nhà, MSE đóng vai trò quan trọng trong việc đánh giá độ chính xác của dự đoán.
Ngăn ngừa quá khớp và thiếu khớp
Khi mô hình quá tập trung vào dữ liệu huấn luyện, hiện tượng quá khớp (Overfitting) xảy ra; ngược lại, nếu mô hình không học đủ từ dữ liệu thì sẽ xảy ra thiếu khớp (Underfitting). Mô hình quá khớp cho hiệu năng rất cao trên dữ liệu huấn luyện nhưng hiệu năng giảm trên dữ liệu mới. Thiếu khớp là trạng thái mô hình chưa nắm bắt đúng các mẫu trong dữ liệu huấn luyện, dẫn đến hiệu năng nhìn chung thấp. Để ngăn ngừa quá khớp, có thể tăng lượng dữ liệu hoặc áp dụng kỹ thuật chính quy hóa (Regularization); để ngăn ngừa thiếu khớp, có thể cần sử dụng mô hình phức tạp hơn.
Đánh giá mô hình bằng kiểm định chéo
Kiểm định chéo (Cross-Validation) là phương pháp rất hữu ích để đánh giá khả năng khái quát hóa của mô hình. Đây là quá trình chia dữ liệu thành nhiều phần, sau đó huấn luyện và đánh giá mô hình đối với từng phần. Phương thức này giảm sự biến động của kết quả đánh giá do cách chia dữ liệu, cho phép đánh giá hiệu năng chính xác hơn. Kiểm định chéo được sử dụng rộng rãi, đặc biệt khi dữ liệu ít hoặc khi muốn đánh giá hiệu năng mô hình chính xác hơn.
Tối ưu hóa siêu tham số
Để tối đa hóa hiệu năng mô hình, cần thực hiện quá trình tối ưu hóa siêu tham số (Hyperparameter Optimization). Siêu tham số là các giá trị thiết lập ảnh hưởng trực tiếp đến quá trình huấn luyện mô hình; hiệu năng mô hình có thể thay đổi đáng kể tùy theo cách điều chỉnh chúng. Tìm kiếm theo lưới (Grid Search) là phương pháp khảo sát mọi tổ hợp siêu tham số có thể có, còn tìm kiếm ngẫu nhiên (Random Search) là phương pháp chọn ngẫu nhiên một số tổ hợp để khảo sát. Gần đây, tối ưu hóa Bayes (Bayesian Optimization) hiệu quả hơn đã được đưa vào sử dụng, có lợi thế trong việc tìm siêu tham số tối ưu với khối lượng tính toán nhỏ.
Cân bằng giữa độ phức tạp và hiệu năng của mô hình
Điều quan trọng trong quá trình tối ưu hóa là duy trì sự cân bằng giữa độ phức tạp và hiệu năng của mô hình. Nếu mô hình quá phức tạp thì khả năng xảy ra quá khớp cao, ngược lại, nếu quá đơn giản thì có thể xảy ra thiếu khớp. Để giải quyết vấn đề này, có thể sử dụng kỹ thuật chính quy hóa (Regularization) để kiểm soát độ phức tạp của mô hình hoặc sử dụng Dropout để ngăn ngừa quá khớp ở mô hình mạng nơ-ron. Cuối cùng, mục tiêu của tối ưu hóa là điều chỉnh độ phức tạp và hiệu năng một cách phù hợp để xây dựng mô hình có khả năng khái quát hóa tốt.
Tầm quan trọng của việc đánh giá và tối ưu hóa
Đánh giá và tối ưu hóa mô hình học máy không đơn thuần là lựa chọn mà là quá trình thiết yếu để một dự án học máy thành công. Cần phân tích kỹ hiệu năng mô hình bằng các chỉ số đánh giá và tối đa hóa hiệu năng thông qua tối ưu hóa siêu tham số. Qua đó, có thể giải quyết vấn đề quá khớp và thiếu khớp, đồng thời xây dựng mô hình tối ưu phù hợp với dữ liệu.
Học máy giữ vị trí quan trọng trong phân tích dữ liệu hiện đại, thúc đẩy những thay đổi mang tính đổi mới trong nhiều lĩnh vực. Để ứng dụng thành công, cần hiểu đầy đủ các khái niệm cơ bản của học máy, lựa chọn thuật toán phù hợp và thực hiện kỹ lưỡng quá trình chuẩn bị, tiền xử lý dữ liệu.
Ngoài ra, quá trình đánh giá và tối ưu hóa hiệu năng mô hình là phần rất quan trọng đối với sự thành công của học máy. Những quá trình này cho phép dự đoán chính xác hơn và ra quyết định hiệu quả hơn, đồng thời đưa ra các giải pháp đổi mới phù hợp với thời đại cách mạng dữ liệu.