El aprendizaje automático es fundamental para el avance de la tecnología moderna y, desde el centro de la revolución de los datos, impulsa cambios en diversos sectores. Se ha consolidado como una herramienta indispensable para analizar grandes volúmenes de datos y hacer predicciones, y su ámbito de aplicación sigue ampliándose.
Este material abarca desde los conceptos básicos del aprendizaje automático hasta los principales algoritmos, el proceso de preparación de los datos y los métodos de evaluación y optimización de modelos.
Conceptos básicos y principios de funcionamiento del aprendizaje automático
Conceptos básicos del aprendizaje automático
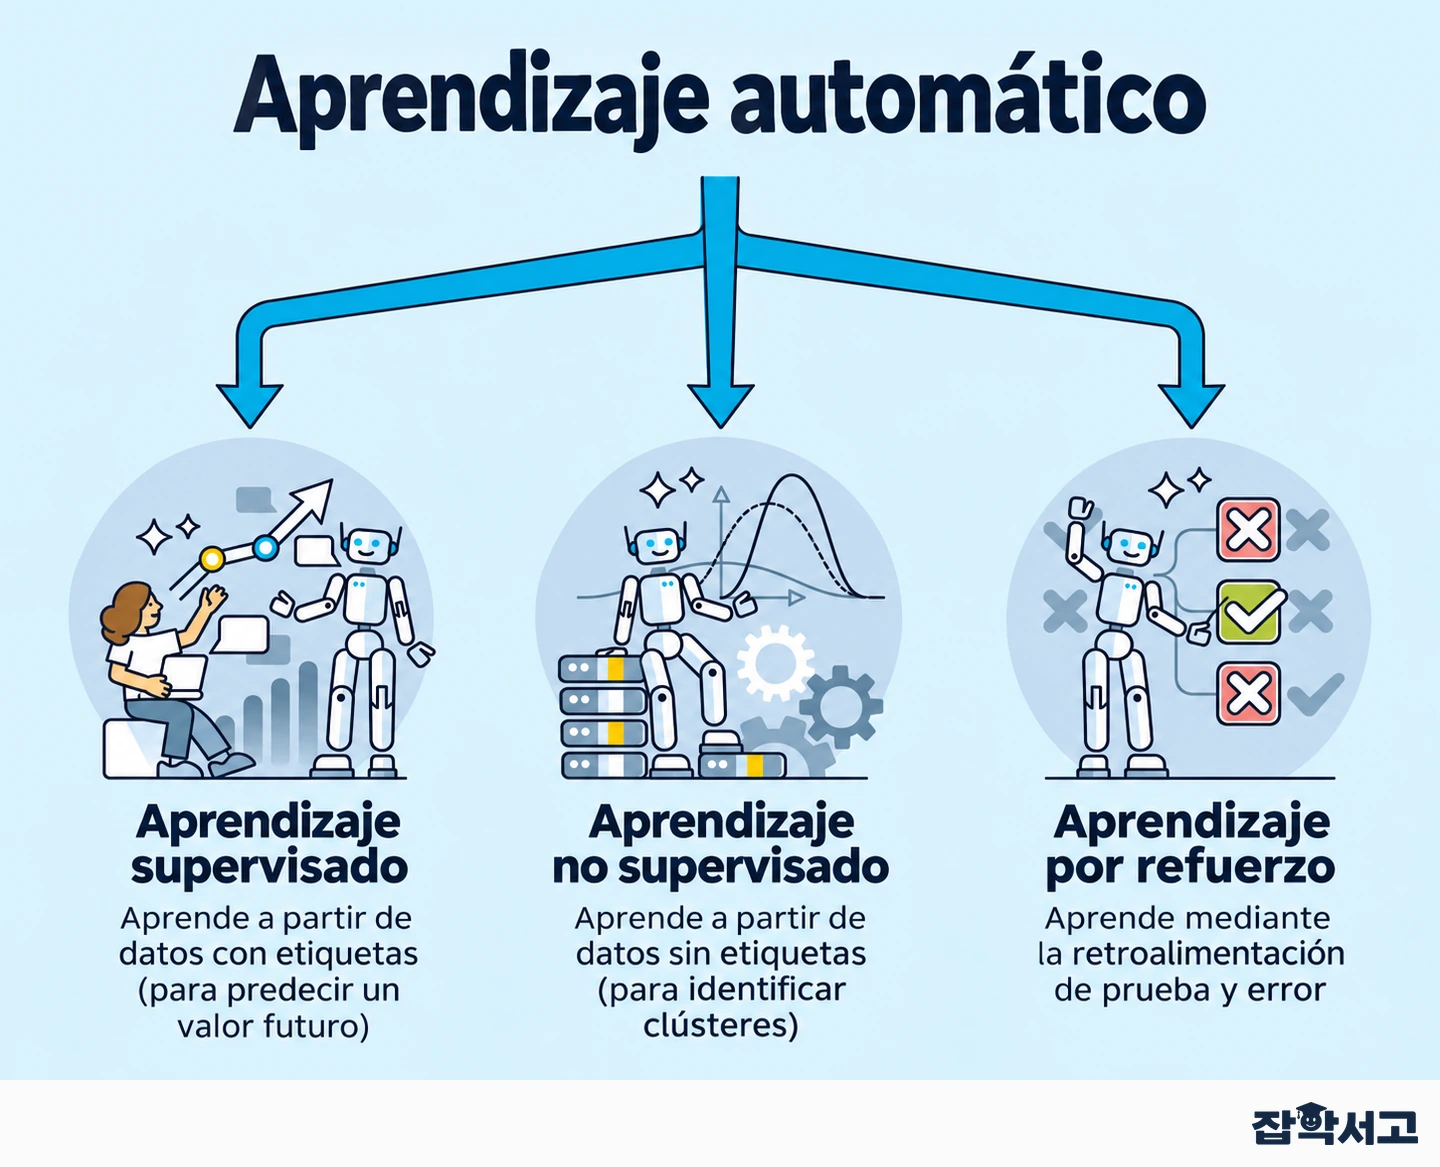
El aprendizaje automático es una tecnología que permite a las computadoras aprender a partir de datos sin programación explícita y usar lo aprendido para hacer predicciones o tomar decisiones. Es una rama de la inteligencia artificial en la que el sistema analiza distintos datos y aprende reglas por sí mismo. Se distinguen tres grandes tipos de aprendizaje automático: el supervisado, el no supervisado y el aprendizaje por refuerzo. Cada modalidad se aplica de manera diferente según el tipo de datos o el objetivo, lo que permite resolver una gran variedad de problemas.
Aprendizaje supervisado a partir de datos y respuestas correctas
El aprendizaje supervisado es un método que entrena un modelo con los datos disponibles y las respuestas correctas correspondientes, llamadas etiquetas. Con este método se crea un modelo que predice valores de salida a partir de datos de entrada. Entre sus algoritmos más representativos están los de regresión y clasificación. La regresión se utiliza para predecir valores continuos, mientras que la clasificación se emplea para dividir los datos en categorías discretas. Un modelo que predice el precio de la vivienda o un algoritmo que filtra el correo no deseado son ejemplos de aprendizaje supervisado. Cuantos más datos se utilizan en el aprendizaje supervisado, mayor es su exactitud. Este método desempeña un papel importante en muchos sectores.
Aprendizaje no supervisado para detectar patrones en datos sin etiquetas
El aprendizaje no supervisado analiza datos sin respuestas conocidas para descubrir patrones o estructuras ocultos en ellos. Como los datos carecen de etiquetas, se utiliza principalmente para identificar sus características o descubrir grupos dentro de ellos. Entre los algoritmos más representativos se encuentran los de agrupamiento y aprendizaje de reglas de asociación. El agrupamiento reúne los datos en grupos de elementos similares, mientras que el aprendizaje de reglas de asociación busca correlaciones entre los datos. Este método se utiliza con frecuencia en la segmentación de clientes y en los sistemas de recomendación, entre otras aplicaciones. Cuantos más datos hay, más complejos y detallados pueden ser los patrones detectados.
Aprendizaje por refuerzo de acciones óptimas mediante recompensas
En el aprendizaje por refuerzo, un agente interactúa con su entorno y aprende qué acciones son óptimas para maximizar la recompensa. El agente prueba distintas acciones, recibe recompensas en función de sus resultados y aprende a tomar mejores decisiones a partir de esa experiencia. El aprendizaje por refuerzo se utiliza principalmente en la inteligencia artificial de los videojuegos, el control de robots y la conducción autónoma, entre otros ámbitos, y requiere la capacidad de aprender de forma autónoma en entornos muy dinámicos. Como el agente aprende por ensayo y error, el entrenamiento puede prolongarse, aunque los resultados que se obtienen son excelentes.
Importancia de la preparación y el preprocesamiento de los datos
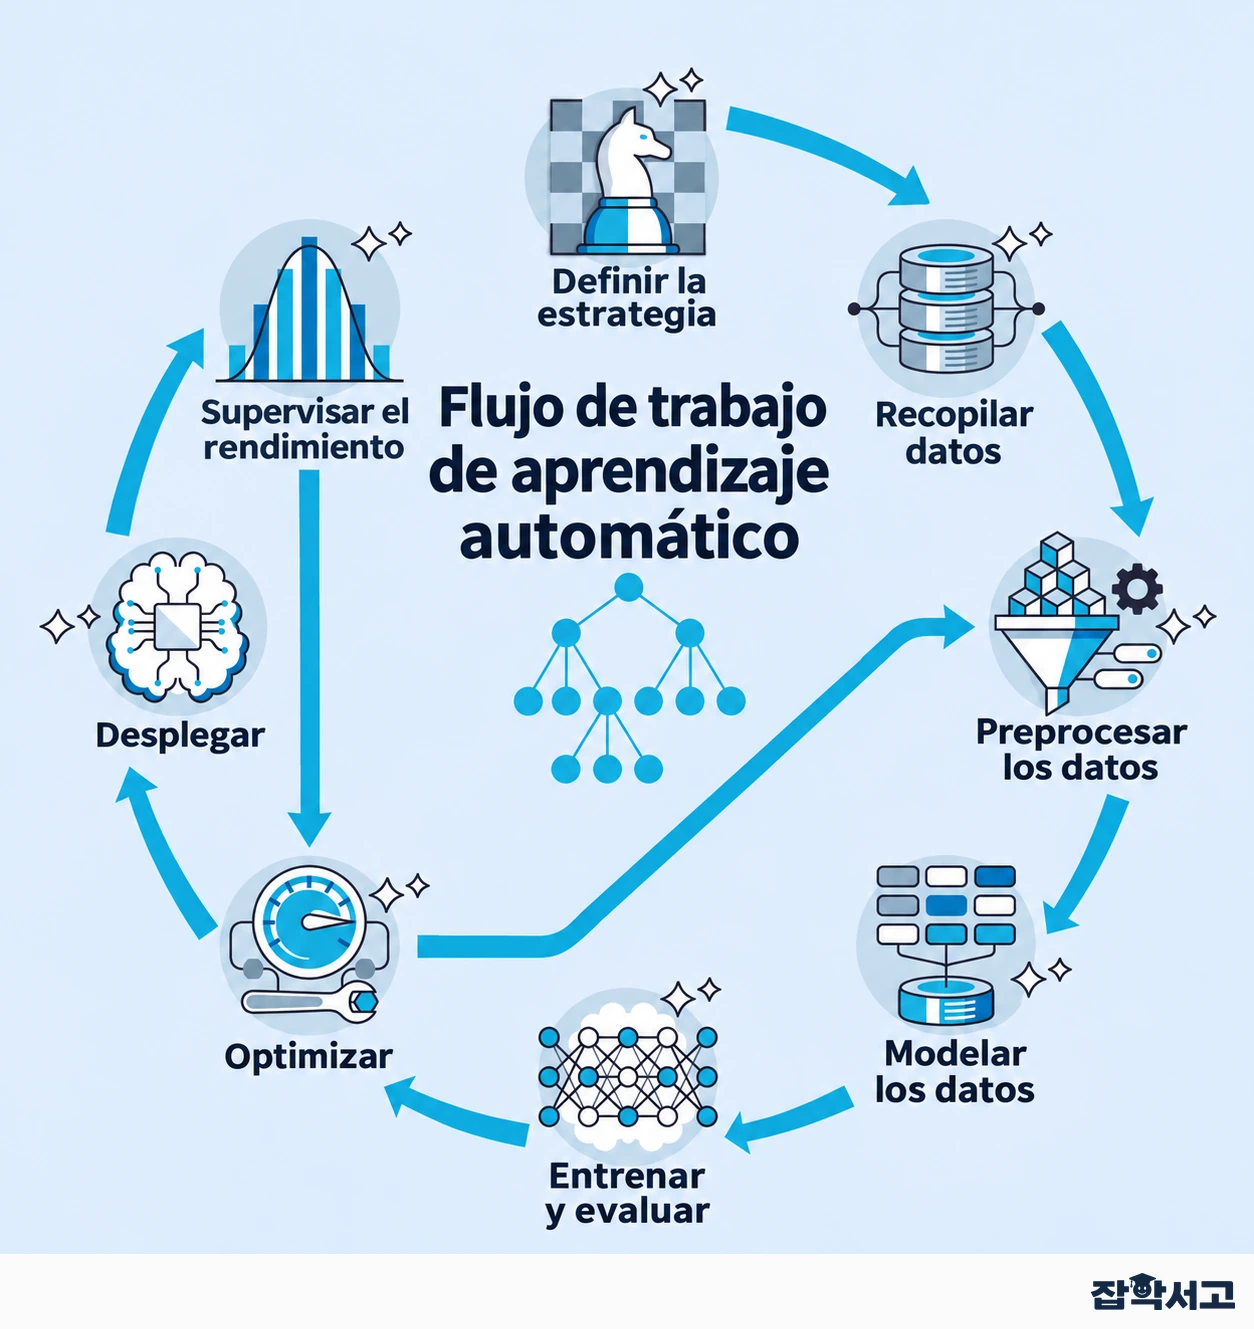
La preparación y el preprocesamiento de los datos son indispensables para construir con éxito un modelo de aprendizaje automático. El preprocesamiento incluye tareas como el tratamiento de valores faltantes, la eliminación de valores atípicos y la normalización de los datos. Si se omiten estas tareas, el rendimiento del modelo puede disminuir considerablemente. También es importante seleccionar y transformar las características (Feature) adecuadas para el modelo. Una gran cantidad de datos por sí sola no garantiza un buen rendimiento, pues los datos deben estar bien organizados. El rendimiento de un modelo de aprendizaje automático depende en gran medida de la cantidad y la calidad de los datos, por lo que estos deben prepararse con cuidado.
Evaluación y optimización del modelo
Una vez entrenado el modelo, es necesario evaluar y optimizar su rendimiento. Para evaluar su capacidad predictiva, se deben separar los datos de entrenamiento de los datos de prueba. Por lo general, el rendimiento del modelo se mide de forma objetiva mediante validación cruzada (Cross Validation) y, al mismo tiempo, se ajustan los hiperparámetros para evitar el sobreajuste (Overfitting) o el subajuste (Underfitting). Para obtener un rendimiento óptimo, hay que analizarlo detenidamente con distintas métricas de evaluación, como la exactitud, la precisión y la exhaustividad.
Futuro y aplicaciones del aprendizaje automático
El aprendizaje automático se aplica en diversos sectores y sus posibilidades de uso son innumerables. En ámbitos como las finanzas, la medicina, la industria manufacturera y los servicios, el análisis de datos y las predicciones permiten maximizar la eficiencia. A medida que avance el aprendizaje automático, habrá más innovaciones, en particular en ámbitos como los vehículos autónomos, el diagnóstico médico, la publicidad personalizada y la inversión financiera. El futuro del aprendizaje automático sigue siendo prometedor y, gracias a esta tecnología, viviremos en un mundo más inteligente y eficiente.
Principales algoritmos de aprendizaje automático y sus ámbitos de aplicación
Panorama de los principales algoritmos de aprendizaje automático
Existen diversos algoritmos de aprendizaje automático y cada uno ofrece un método adecuado según las características del problema. Estos algoritmos se emplean en distintos ámbitos y contribuyen considerablemente al análisis de datos y a la elaboración de predicciones. Entre los más representativos se encuentran la regresión lineal, la regresión logística, los árboles de decisión, los bosques aleatorios, las máquinas de vectores de soporte (SVM), los k vecinos más cercanos (k-NN), Naive Bayes y las redes neuronales. Cada algoritmo tiene un propósito y una forma específica de resolver problemas, por lo que es importante comprender bien sus características y aplicarlo en consecuencia.
Predicción de datos continuos mediante regresión lineal
La regresión lineal es uno de los algoritmos más básicos para predecir datos continuos. Modela la relación lineal entre una o más variables independientes y una variable dependiente, y se centra en hacer predicciones a partir de los datos. Por ejemplo, se usa con frecuencia para predecir el precio de la vivienda o el volumen de ventas. La regresión lineal es útil para identificar tendencias en los datos y predecir valores futuros, aunque su exactitud puede disminuir si los datos no siguen una relación lineal.
Regresión logística para resolver problemas de clasificación binaria
La regresión logística es un algoritmo adecuado para la clasificación binaria y se usa para resolver problemas en los que hay dos resultados posibles. Por ejemplo, se utiliza con frecuencia para clasificar correos no deseados o predecir la presencia o ausencia de una enfermedad. La regresión logística calcula probabilidades a partir de los datos y utiliza esos resultados para realizar la clasificación. Ofrece una alta fiabilidad, especialmente en problemas de clasificación, y tiene un buen rendimiento incluso cuando los datos presentan una complejidad moderada.
El árbol de decisión como modelo intuitivo y fácil de interpretar
El árbol de decisión permite visualizar la toma de decisiones con una estructura de árbol. Es un modelo intuitivo y fácil de interpretar. En cada nodo se comprueba una condición y se toma una decisión en función del resultado. Se utiliza tanto en problemas de clasificación como de regresión. Por ejemplo, sirve para predecir si un cliente dejará de utilizar un servicio o para recomendar un producto específico. Los árboles de decisión tienen la desventaja de ser propensos al sobreajuste (overfitting), por lo que el modelo puede volverse demasiado complejo.
El bosque aleatorio como método representativo del aprendizaje por ensamble
El bosque aleatorio es un método de aprendizaje por ensamble que combina varios árboles de decisión para mejorar el rendimiento predictivo. Ofrece predicciones más estables y exactas que un solo árbol de decisión y resulta muy eficaz para reducir el sobreajuste. Se utiliza especialmente en el sector financiero para detectar fraudes y predecir puntuaciones crediticias, entre otras tareas. También tiene la ventaja de mantener una alta fiabilidad independientemente de la complejidad de los datos.
Máquinas de vectores de soporte (SVM) para la clasificación en espacios de alta dimensión
La máquina de vectores de soporte (SVM) es un algoritmo que transforma los datos para representarlos en un espacio de alta dimensión y encontrar la frontera de clasificación óptima. Suele mostrar un alto rendimiento en problemas como el reconocimiento facial y la clasificación de textos. Las SVM funcionan muy bien incluso con pocos datos y destacan especialmente en problemas de clasificación con fronteras bien definidas. Cuando los datos son abundantes o complejos, el entrenamiento puede llevar más tiempo.
Reconocimiento de patrones complejos con redes neuronales y aprendizaje profundo
Las redes neuronales son algoritmos que imitan la estructura del cerebro humano y destacan por su capacidad para reconocer patrones complejos. En particular, el aprendizaje profundo es una rama de las redes neuronales que utiliza redes de varias capas y ofrece un alto rendimiento en el análisis de grandes volúmenes de datos. Está logrando resultados destacados en ámbitos como el reconocimiento de imágenes y de voz y el procesamiento del lenguaje natural, y su uso se extiende cada vez más. El aprendizaje profundo requiere grandes volúmenes de datos y una elevada capacidad de cómputo, y puede producir resultados innovadores.
Los k vecinos más cercanos (k-NN), un algoritmo sencillo y potente
El algoritmo de los k vecinos más cercanos (k-NN) clasifica datos nuevos comparándolos con los existentes para identificar los k vecinos más próximos. Los cálculos son sencillos, aunque la velocidad y el consumo de memoria pueden convertirse en un problema con grandes volúmenes de datos. Se utiliza sobre todo en el reconocimiento de patrones y en los sistemas de recomendación, entre otras aplicaciones, y toma decisiones de forma intuitiva a partir de la similitud entre los datos.
Clasificación basada en probabilidades con Naive Bayes
Naive Bayes es un algoritmo de clasificación basado en la teoría de la probabilidad que clasifica los datos mediante el cálculo de probabilidades condicionales. Se utiliza principalmente para clasificar textos y analizar sentimientos, entre otras tareas, y combina sencillez con un alto rendimiento. Naive Bayes supone que todas las características son independientes, pero tiene la ventaja de poder dar buenos resultados incluso cuando ese supuesto no se cumple en los datos reales.
Importancia de elegir el algoritmo adecuado
Los distintos algoritmos de aprendizaje automático deben elegirse y aplicarse en función de cada problema. Es importante seleccionar un algoritmo adecuado a las características del problema y al tipo de datos, pues así se pueden obtener resultados óptimos. Para aplicar con éxito el aprendizaje automático, es indispensable comprender las características y limitaciones de cada algoritmo y elegir el método más adecuado para resolver el problema.
La preparación y el preprocesamiento de los datos como base del aprendizaje automático
Importancia de la preparación y el preprocesamiento de los datos
El éxito o el fracaso de un proyecto de aprendizaje automático depende del rigor con que se preparen y preprocesen los datos. Como los datos influyen directamente en el rendimiento del modelo, es necesario tratarlos con cuidado en todas las etapas. La recopilación, la limpieza y la transformación de los datos, así como la extracción y la selección de características, son tareas básicas para optimizar el rendimiento del modelo. Si no se realizan correctamente, es posible que el modelo no produzca resultados fiables.
Recopilación de datos en cantidad suficiente y de buena calidad
La recopilación de datos es la primera etapa y consiste en reunir los datos con los que se entrenará el modelo. Para ello se emplean distintos métodos, como el raspado web, las consultas a bases de datos y las llamadas a API. Tanto la cantidad como la calidad de los datos son muy importantes. El modelo necesita suficientes datos para aprender distintos patrones, y si la calidad de los datos es baja, también disminuye la exactitud de sus predicciones. Por eso, en esta etapa es importante obtener datos de la mayor fiabilidad y calidad posibles.
Limpieza de datos para eliminar ruido y defectos
La limpieza de datos consiste en eliminar errores o elementos innecesarios de los datos recopilados. Incluye el tratamiento de valores faltantes, la eliminación de duplicados y la detección y corrección de valores atípicos, entre otras tareas. Los modelos de aprendizaje automático dependen en gran medida de la calidad de los datos. Si se incluyen datos sin depurar, el modelo puede aprender patrones erróneos o perder considerablemente exactitud en sus predicciones. En esta etapa es especialmente importante tratar los valores faltantes, ya sea eliminándolos o sustituyéndolos con un método adecuado. Los datos erróneos que queden pueden afectar considerablemente al rendimiento del modelo, por lo que la limpieza debe realizarse de forma minuciosa.
Transformación de los datos para adaptarlos al modelo
La transformación de los datos consiste en convertir los datos recopilados a un formato que el modelo pueda interpretar. Incluye operaciones como el escalado, la estandarización y la normalización. Por ejemplo, puede ser necesario estandarizar las variables para ponerlas en una escala común o aplicar la codificación one-hot (One-Hot Encoding) para convertir variables categóricas en numéricas. Estas transformaciones permiten que el modelo procese los datos y aprenda de ellos con eficiencia. Si este proceso no se realiza correctamente, el modelo puede reflejar mal las características de los datos y perder rendimiento.
Extracción de características para resaltar la información importante
La extracción de características consiste en obtener información importante de los datos originales para crear nuevas características. Esta tarea es fundamental para maximizar el rendimiento del modelo. Dos ejemplos típicos son analizar la periodicidad o las tendencias de una serie temporal para identificar características significativas y extraer palabras clave importantes de datos textuales. La extracción de características permite captar mejor las propiedades esenciales de los datos y ayuda al modelo a aprender los patrones importantes.
Selección de características para optimizar el rendimiento del modelo
La selección de características consiste en elegir, entre muchas variables, solo aquellas que son importantes para el entrenamiento del modelo. Al eliminar las variables innecesarias, se puede reducir la complejidad del modelo y mejorar la velocidad de entrenamiento y la exactitud de las predicciones. En este proceso se emplean métodos estadísticos como el análisis de correlación y el análisis de componentes principales (PCA) para seleccionar las características importantes y evitar el sobreajuste. Eliminar datos innecesarios también facilita la interpretación del modelo, por lo que la selección de características es una etapa muy importante del aprendizaje automático.
Necesidad de preparar y preprocesar los datos con rigor
La preparación y el preprocesamiento de los datos requieren mucho tiempo, pero son indispensables para que un proyecto de aprendizaje automático tenga éxito. Para construir modelos predictivos exactos y fiables, en esta etapa hay que asegurar la calidad de los datos y estructurarlos adecuadamente. Además de analizar los datos, los científicos de datos deben saber comprender sus características y tratarlos de forma adecuada. Sin un preprocesamiento riguroso de los datos, incluso el modelo más complejo acabará produciendo resultados poco fiables.
Análisis de métodos de evaluación y optimización de modelos de aprendizaje automático
Importancia de evaluar los modelos de aprendizaje automático
Una vez construido un modelo de aprendizaje automático, es indispensable evaluar su rendimiento de forma objetiva. La evaluación del modelo (Evaluation) mide con distintas métricas hasta qué punto el modelo resuelve eficazmente el problema planteado. Cada métrica analiza el rendimiento del modelo desde una perspectiva distinta, por lo que se debe elegir la más adecuada en cada situación.
Métricas de evaluación de modelos de clasificación
Para evaluar los modelos de clasificación suelen utilizarse métricas como la exactitud (Accuracy), la precisión (Precision), la exhaustividad (Recall) y la puntuación F1 (F1 Score). La exactitud indica la proporción de predicciones correctas sobre el total de los datos, aunque tiene limitaciones si se usa de forma aislada cuando los datos están muy desequilibrados. La precisión indica qué proporción de los casos que el modelo predice como positivos son realmente positivos, mientras que la exhaustividad indica qué proporción de los casos realmente positivos identifica el modelo como tales. La puntuación F1 combina la precisión y la exhaustividad y resulta útil cuando interesa el equilibrio entre ambas métricas. Por ejemplo, la exhaustividad es importante en los sistemas de diagnóstico médico porque permite reducir al mínimo el número de pacientes con un resultado realmente positivo que pasan inadvertidos.
Métricas de evaluación de modelos de regresión
Para evaluar el rendimiento de los modelos de regresión se emplean métricas como el error absoluto medio (MAE), el error cuadrático medio (MSE) y el coeficiente de determinación (R²). El MAE evalúa el error de predicción del modelo mediante el promedio de los valores absolutos de las diferencias entre los valores predichos y los reales. El MSE es el promedio de los cuadrados de esas diferencias, por lo que da más peso a los errores grandes. El R² indica hasta qué punto el modelo explica los datos. Cuanto más se acerca a 1, mejor es el modelo. Por ejemplo, en un modelo que predice el precio de la vivienda, el MSE desempeña un papel importante en la evaluación de la exactitud de las predicciones.
Prevención del sobreajuste y del subajuste
El sobreajuste (Overfitting) se produce cuando el modelo se ajusta demasiado a los datos de entrenamiento. El subajuste (Underfitting) se produce cuando el modelo aprende de forma insuficiente a partir de los datos. Un modelo sobreajustado muestra un rendimiento muy alto con los datos de entrenamiento, pero pierde rendimiento con datos nuevos. En el subajuste, el modelo no capta adecuadamente los patrones de los datos de entrenamiento y su rendimiento es bajo en general. Para prevenir el sobreajuste, se puede aumentar la cantidad de datos o aplicar técnicas de regularización (Regularization). Para evitar el subajuste, puede ser necesario usar un modelo más complejo.
Evaluación del modelo mediante validación cruzada
La validación cruzada (Cross-Validation) es un método muy útil para evaluar la capacidad de generalización de un modelo. Consiste en dividir los datos en varias particiones y entrenar y evaluar el modelo para cada una de ellas. Este método reduce la variabilidad de los resultados de la evaluación debida a la división de los datos y permite evaluar el rendimiento con mayor exactitud. La validación cruzada se utiliza mucho, especialmente cuando hay pocos datos o se quiere evaluar el rendimiento del modelo con mayor exactitud.
Optimización de hiperparámetros
Para maximizar el rendimiento del modelo es necesario optimizar los hiperparámetros (Hyperparameter Optimization). Los hiperparámetros son valores de configuración que influyen directamente en el entrenamiento, y la forma en que se ajusten puede cambiar considerablemente el rendimiento del modelo. La búsqueda en cuadrícula (Grid Search) explora todas las combinaciones posibles de hiperparámetros. La búsqueda aleatoria (Random Search) selecciona al azar algunas combinaciones para explorarlas. En los últimos tiempos se ha introducido la optimización bayesiana (Bayesian Optimization), un método más eficiente que facilita encontrar los hiperparámetros óptimos con menos cálculos.
Equilibrio entre la complejidad y el rendimiento del modelo
Durante la optimización es importante mantener el equilibrio entre la complejidad y el rendimiento del modelo. Un modelo demasiado complejo tiene más probabilidades de sobreajustarse, mientras que uno demasiado simple puede presentar subajuste. Para resolver estos problemas, se puede controlar la complejidad del modelo mediante técnicas de regularización (Regularization) o prevenir el sobreajuste en las redes neuronales mediante el abandono aleatorio de unidades (Dropout). El objetivo final de la optimización es ajustar adecuadamente la complejidad y el rendimiento para construir un modelo que generalice bien.
Importancia de la evaluación y la optimización
Evaluar y optimizar los modelos es indispensable para que un proyecto de aprendizaje automático tenga éxito. Hay que analizar detenidamente el rendimiento del modelo mediante métricas de evaluación y maximizarlo mediante la optimización de los hiperparámetros. Así se pueden resolver los problemas de sobreajuste y subajuste y construir el modelo más adecuado para los datos.
El aprendizaje automático ocupa un lugar importante en el análisis de datos moderno e impulsa cambios innovadores en diversos ámbitos. Para aprovecharlo con éxito, es necesario comprender bien sus conceptos básicos, seleccionar los algoritmos adecuados y preparar y preprocesar los datos con rigor.
Evaluar y optimizar el rendimiento del modelo también es fundamental para el éxito del aprendizaje automático. Estos procesos permiten obtener predicciones más exactas, tomar decisiones más eficaces y proponer soluciones innovadoras acordes con la era de la revolución de los datos.