回帰分析は統計学とデータ科学における重要なツールであり、さまざまな産業や研究分野でデータの予測と分析に広く活用されています。変数間の関係をモデル化して理解することで、今後生じる結果の予測に大きく役立ち、意思決定の過程で非常に有用な情報を提供します。
本資料では、回帰分析の基本概念とさまざまな回帰手法を取り上げ、実際の活用事例と限界も併せて見ていきます。これを通じて、回帰分析がデータ予測の中核技術として定着している理由を深く理解することを目指します。
回帰分析の基本概念:統計学の重要なツール
回帰分析の定義と役割
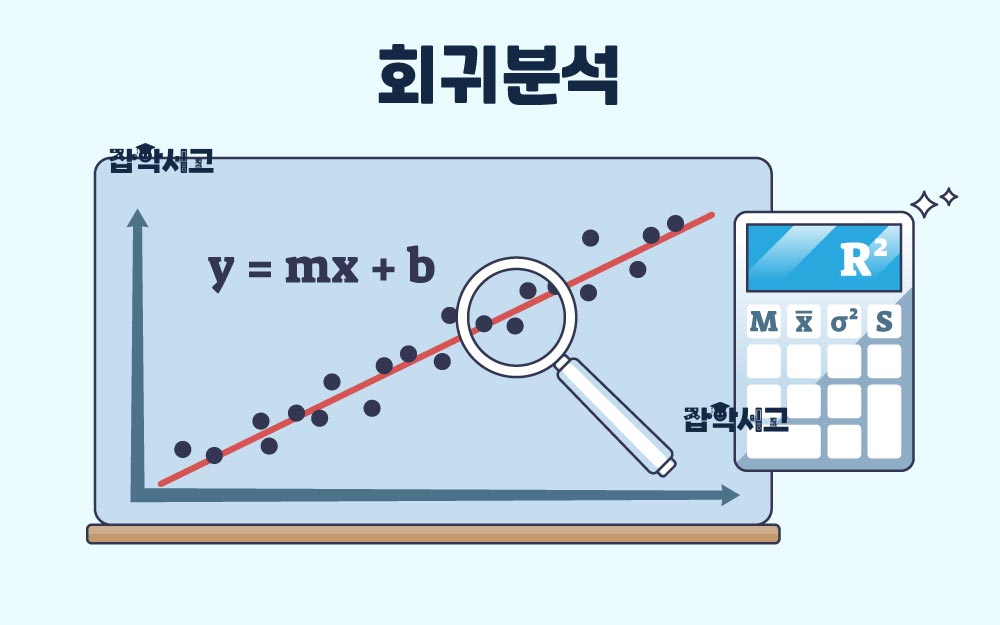
回帰分析は、複数の変数間の関係を説明し、予測する統計的手法です。主に単一の従属変数と複数の独立変数を用いて、従属変数の変化を予測するために活用されます。回帰分析の主な目的は、変数間の関係を説明し、新たな観測値を予測することです。これにより、データセット内に見られるパターンを理解し、さまざまな変数が相互に作用する仕組みを把握できます。こうした分析結果は、経済、経営、社会科学など、多くの分野で意思決定の重要な基礎資料として活用されます。
データ収集と前処理の重要性
回帰モデルを構築するために最初に行うべきことは、質の高いデータを収集することです。データはさまざまな情報源から入手でき、その品質は回帰分析の結果に大きく影響します。欠損値や外れ値を含むデータは誤った分析結果につながる可能性があるため、収集後の前処理が不可欠です。データのクレンジングでは、欠損値を処理し、外れ値を除去または修正し、必要に応じて変数変換を行い、分析に適した形式に整える必要があります。この過程で信頼できるデータを準備することが、分析の精度を高める重要な段階となります。
最小二乗法:回帰分析の中核手法
回帰分析で最も広く使われている手法の一つが最小二乗法です。最小二乗法は、モデルの予測値と実際の観測値との差を最小化するパラメータを推定する方法です。つまり、観測されたデータと回帰モデルの予測値との差が最も小さくなるように、回帰モデルの係数を決定します。これにより、モデルがデータの傾向をよりよく反映し、予測精度を高められます。最小二乗法は特に線形回帰モデルで多く使われ、数学的に簡潔でありながら効果的な方法と評価されています。
モデルの適合度検定:分析の信頼性評価
回帰モデルがどの程度うまく機能しているかを評価するには、モデルの適合度検定を行う必要があります。適合度検定は、モデルがデータをどの程度よく説明しているかを評価する過程であり、決定係数(R²)などの指標を活用します。R²の値は0から1の間で表され、1に近いほど、モデルがデータをよく説明していることを意味します。逆に、R²の値が低い場合は、モデルがデータを十分に説明できていないことを意味します。この検定を通じて、分析者はモデルの信頼性を確認し、必要に応じてモデルを改善するための情報を得られます。
さまざまな回帰モデルの種類と適用
回帰分析にはさまざまな種類の回帰モデルがあり、データの特性に応じて適切なモデルを選ぶことが重要です。代表的な回帰モデルには、線形回帰と非線形回帰があります。線形回帰は、独立変数と従属変数の関係が直線的な場合に適しており、主にデータを簡潔に説明できる状況で使われます。一方、非線形回帰は、独立変数と従属変数の関係が曲線状になる場合に使われ、複雑なデータパターンを説明するのに役立ちます。
多項式回帰は線形回帰を拡張したもので、データが2次以上の関数の形を示す場合に使われます。このほか、ロジスティック回帰は二値の従属変数を予測するために使われ、主に分類問題に活用されます。それぞれの回帰モデルはデータの構造によって異なる性能を発揮するため、データの特性に合ったモデルを選ぶことが非常に重要です。
回帰分析の限界と改善方法
回帰分析は強力な予測ツールですが、いくつかの限界もあります。まず、回帰モデルは変数間の因果関係よりも、相関関係の説明に重点を置いています。また、データが線形でない場合や外れ値を含む場合には、モデルの予測性能が大きく低下することがあります。こうした問題を解決するには、変数選択や正則化、非線形変換などの方法を検討できます。また、残差分析を通じてモデルの予測誤差を分析し、改善の余地を評価できます。こうした過程により、分析の正確性を高め、より信頼性の高い結果を得られます。
線形回帰と非線形回帰の違いを分析
線形回帰の定義と特性
線形回帰は、回帰分析の中で最も基本的かつ広く使われる手法であり、独立変数と従属変数の間に線形関係があると仮定します。つまり、従属変数は独立変数の線形結合で表され、主にy = ax + bという形の方程式で示されます。ここで「a」は独立変数の影響の大きさを示す傾き、「b」はy軸との切片です。線形回帰はデータ全体の傾向を把握するのに適しており、計算が簡単で解釈もしやすいため、迅速に結果を得られるという利点があります。
このモデルは、経済学、社会科学、生物学など、さまざまな分野で広く活用されており、独立変数と従属変数の関係が比較的単純な場合に効果的です。ただし、データのパターンが複雑な場合や非線形の場合には、線形回帰では十分な説明力を得られないという限界があります。
非線形回帰の定義と特性
非線形回帰は、独立変数と従属変数の関係が非線形である場合に使われる回帰モデルです。このモデルでは、複雑なパターンを説明するためにさまざまな関数の形を利用でき、データが曲線状に分布する場合に適しています。非線形回帰は、y = ax² + bx + cのように異なる次数の項を含むことがあり、指数関数や対数関数など、非線形の形で表されることもあります。
非線形回帰は、線形回帰では説明できないデータの複雑さを説明することに強みがありますが、その分、計算が複雑になり、解釈も難しくなる場合があります。また、モデルがデータに過度に敏感に適合すると、過学習(overfitting)のリスクが生じます。これを防ぐために、モデルの複雑さを調整する正則化(regularization)を適用できます。
線形回帰と非線形回帰の主な違い
線形回帰と非線形回帰は、独立変数と従属変数の関係を説明する方法が大きく異なります。線形回帰は、独立変数と従属変数の関係が直線的な場合に使われ、解釈が簡単で計算も速い一方、複雑なデータパターンを説明するには限界があります。一方、非線形回帰には、データの複雑なパターンを説明できる柔軟性があり、さまざまな関数の形を用いて複雑な関係をモデル化できます。
ただし、非線形回帰には、解釈が難しく、過学習のリスクがあるという欠点があります。こうした問題を解決するために、正則化を適用してモデルの複雑さを制御し、予測性能を改善できます。
モデルの適合度検定とその違い
線形回帰では、決定係数(R²)のような簡単な指標でモデルの適合度を評価できます。R²の値が高いほど、モデルがデータをよく説明しているとみなされます。ただし、非線形回帰では、モデルの適合度を評価する過程がより複雑になることがあり、さまざまな適合度検定の手法が必要です。例えば、残差分析やAIC(Akaike Information Criterion)などの指標を通じて、モデルの性能を評価できます。
線形回帰と非線形回帰の選択基準
データ分析で線形回帰と非線形回帰のどちらを選ぶかは、データの特性や分析の目的によって異なります。線形回帰は単純な関係を説明したい場合に有用で、データ全体の傾向を把握するのに適しています。一方、データが非線形の特性を示す場合や、複雑な関係を説明する必要がある場合には、非線形回帰の方が適切なことがあります。
データサイエンティストや統計学者は、こうしたモデルの特性と限界を十分に理解し、データに最も適したモデルを選ぶ必要があります。適切なモデルの選択は、予測の正確性を高め、データのパターンをよりよく説明することにつながります。
線形回帰と非線形回帰の活用と考慮事項
線形回帰と非線形回帰にはそれぞれ長所と短所があり、データの構造や分析の目的に応じて適切に選ぶ必要があります。線形回帰は簡単で解釈しやすい一方、非線形回帰には複雑なデータパターンを説明できる柔軟性があります。モデルを選ぶ際には、データの特性だけでなく、過学習のリスクやモデルの解釈可能性などもすべて考慮する必要があります。
回帰分析を活用したデータ予測の実例
回帰分析の実社会での活用事例の概要
回帰分析はさまざまな産業で実際の問題解決に貢献しており、その有用性は多くの分野で実証されています。データに基づく予測や分析が必要な場面で重要なツールとして使われ、特に経済、金融、医療、マーケティング、交通、環境の分野で大きな影響力を持っています。さまざまな事例を通じて、回帰分析が実際の問題解決にどのように役立っているのか、具体的に見ていきます。
不動産市場における回帰分析の活用
不動産市場では、回帰分析が住宅価格の予測に役立っています。住宅の広さ、立地、築年数、階数など、さまざまな独立変数を考慮して従属変数である住宅価格を予測することで、不動産仲介業者や購入者に重要な情報を提供します。例えば、似た条件の住宅がどのような価格で取引されたかを分析すれば、対象の住宅が今後どの程度の価格で取引される可能性が高いかを予測できます。これにより、仲介業者は合理的な価格を提示でき、購入者は市場の状況を把握して、よりよい意思決定を行えます。
金融市場における回帰分析
金融業界でも、回帰分析は株式市場の分析やリスク管理で重要な役割を果たしています。株価、取引量、経済指標などを独立変数として用いて株価の変動を予測し、投資戦略の策定を支援します。特に時系列データを活用した回帰分析は、過去のデータに基づいて将来の経済状況を予測することに強みがあります。経済指標の変化が株価に与える影響を分析し、それに基づいて投資判断を行うことで、より戦略的な投資が可能になります。
医療分野における回帰分析の適用
医療分野でも、回帰分析は疾病の予測や患者に合わせた治療計画の策定に役立ちます。患者の病歴、年齢、性別、各種検査結果などのデータを総合し、疾病を発症する可能性を予測することで、医療従事者がより適切な治療法を見つけられるよう支援します。例えば、回帰分析を通じて特定の要因が疾病の発生に与える影響を把握すれば、予防措置や早期診断が可能になり、患者の健康状態をより効果的に管理できます。
マーケティングにおける回帰分析の活用
回帰分析は、マーケティング戦略の策定にも大きく貢献します。消費者の購買パターン、年齢、所得、好みなど、さまざまなデータを分析して、今後の購買行動を予測できます。これに基づき、企業は効果的なマーケティング戦略を策定し、対象に合わせた広告キャンペーンを展開できます。例えば、特定の製品に対する消費者の関心がどのように変化するかを予測し、広告予算を効率的に配分したり、新製品の発売時期を調整したりできます。これにより、売上の増加と資源配分の最適化が可能になります。
交通・物流における回帰分析の適用
交通分野では、回帰分析によって交通量を予測し、交通渋滞の軽減に役立てています。例えば、特定の時間帯や天候による交通量の変動を分析し、道路の混雑を緩和する方策を立てられます。また、配送サービスの分野では、回帰分析を通じて配送時間を予測し、その情報に基づいて顧客に正確な配送予定を伝えることで、顧客満足度を高められます。これにより、交通システムや物流ネットワークの効率を大幅に向上できます。
気候変動の予測と回帰分析の役割
気候変動の研究でも、回帰分析は重要な役割を果たしています。気温、降水量、風速などの気候データを分析して将来の気候変動を予測することで、政策立案者による環境政策の策定を支援します。例えば、回帰分析を通じて特定地域の気候変動のパターンを分析し、それに応じて農業、エネルギー消費、災害管理などの計画を立てられます。このように、気候変動に関するデータに基づいて回帰分析を行うことで、環境保護や気候変動への対応戦略の策定に貢献できます。
回帰分析の幅広い活用と価値
回帰分析はさまざまな分野で重要な予測ツールとして定着しており、不動産、金融、医療、マーケティング、交通、環境など、多くの分野で実質的な価値を提供しています。データに基づく意思決定を通じて問題を解決し、よりよい戦略を立てるうえで、回帰分析は不可欠なツールとなっています。適切に活用することで、より効率的で正確な予測と分析が可能になり、各産業の競争力を高められます。
回帰分析の限界と精度向上の方法を探る
回帰分析の限界と仮定の重要性
回帰分析はデータ分析や予測における強力なツールですが、いくつかの重要な限界があります。最初の限界は、回帰分析がデータに関する特定の仮定に依存していることです。特に線形回帰は、独立変数と従属変数の間に線形関係があると仮定しており、この仮定が満たされないとモデルの予測性能は大きく低下します。例えば、独立変数と従属変数の間に非線形の関係がある場合、線形回帰モデルではそれを正確に説明できず、誤った結論を導く可能性があります。
これを克服するには、まずデータが線形であるかを確認し、線形性が不十分であれば、非線形回帰モデルやほかの方法論を用いる必要があります。また、回帰モデルの仮定の一つである独立変数同士の独立性も検討する必要があり、多重共線性(multicollinearity)が存在するとモデルの性能が低下する可能性があるため、その解決方法を考慮しなければなりません。
外れ値の処理とモデルの信頼性確保
回帰分析におけるもう一つの顕著な限界は、外れ値(outlier)の存在です。外れ値は、データ内のほかの観測値と比べて極端な値を持つ点であり、回帰モデルの性能に悪影響を与えることがあります。外れ値を含むデータはモデルをゆがめ、予測結果を不正確にする可能性が高くなります。
外れ値を特定して処理する方法の一つに、残差分析があります。残差(residuals)はモデルの予測値と実際の観測値との差を意味し、残差分析を通じて、どのデータが外れ値なのかを把握できます。外れ値を除去したり、必要に応じて調整したりすることで、モデルの信頼性を確保できます。
変数選択とモデルの単純化
モデルの性能を向上させるには、適切な変数選択が非常に重要です。すべての独立変数が従属変数に意味のある影響を与えるわけではなく、不要な変数を含めると、モデルに過学習(overfitting)が生じる可能性があります。過学習とは、モデルが訓練データに過度に適合し、新しいデータに対する予測性能が低下する現象です。
変数選択の手法には、変数増加法(forward selection)、変数減少法(backward elimination)、ステップワイズ法(stepwise selection)などがあります。これらの手法は、モデルの複雑さを抑えながら重要な変数だけを残すことで、予測性能の向上に貢献します。これにより、より単純で解釈可能なモデルを構築できます。
正則化による過学習の防止
回帰分析で過学習を防ぐための別の方法として、正則化(regularization)があります。正則化は、モデルの複雑さを調整することで過学習を防ぎ、予測性能の改善に役立ちます。代表的な正則化の方法には、ラッソ(Lasso)回帰とリッジ(Ridge)回帰があります。
ラッソ回帰は、不要な変数の係数を0にすることで変数選択の効果を得られ、リッジ回帰は係数の大きさを制限することで過学習を抑えます。これらの手法はデータの特性に応じて使い分けることができ、モデルの解釈可能性を高めながら予測精度を維持できます。
交差検証によるモデル評価
モデルの性能を客観的に評価するために、交差検証(cross-validation)がよく使われます。交差検証は、データを複数の部分に分けて訓練と検証を繰り返す方法で、モデルが新しいデータに対してどの程度汎化できるかを評価します。これにより、過学習を防ぎ、さまざまなデータの状況でも一貫した性能を示すモデルを構築できます。
交差検証で最も一般的な方法の一つは、k分割交差検証(k-fold cross-validation)です。データをk個のフォールドに分け、それぞれを順番に検証に用いる方法です。この方法は、データ量が少ない場合や、過学習の懸念がある場合に特に有用です。
最新の手法とツールの活用
回帰分析の精度を高めるには、最新の手法やツールを活用することも重要です。機械学習の発展とともに、回帰分析の手法もさらに精緻化しています。例えば、ランダムフォレスト回帰(random forest regression)やサポートベクター回帰(support vector regression)など、機械学習に基づく回帰モデルは、従来の回帰分析を補完し、より正確な予測を可能にします。
データサイエンティストは、こうした最新のツールを適切に活用することで、データ分析や予測でよりよい成果を上げ、回帰分析から得られる洞察を最大限に引き出せます。
回帰分析の限界と改善に向けたアプローチ
回帰分析は強力な予測ツールですが、その限界を認識し、改善に向けてさまざまな方法論を適用することが重要です。データの特性を理解し、適切な変数選択と外れ値の処理によってモデルの性能を改善できるほか、正則化や交差検証を活用して過学習を防ぎ、精度を高められます。最新の手法を継続的に学び、適用する過程で、回帰分析の可能性を最大限に生かせるでしょう。
回帰分析はデータ予測に不可欠な技術として定着し、さまざまな分野でその有用性が広く認められています。線形回帰と非線形回帰の違いを理解し、実際の事例を通じてこの技術の価値を確認できます。ただし、回帰分析にはいくつかの限界があり、それを補うためのさまざまな研究やアプローチが存在します。
データサイエンティストや分析者は、こうした限界を認識し、適切な代替策を探ることで、より信頼性の高い予測と分析を行う必要があります。回帰分析は今後も、データに基づく意思決定の重要なツールとして発展を続け、その活用範囲はさらに広がると見込まれます。