मशीन लर्निंग आधुनिक तकनीकी विकास का एक प्रमुख आधार है और डेटा क्रांति के केंद्र में रहकर विभिन्न उद्योगों में बदलाव ला रही है। विशाल मात्रा में डेटा का विश्लेषण करने और पूर्वानुमान लगाने के लिए एक आवश्यक साधन बन चुकी मशीन लर्निंग का उपयोग लगातार बढ़ रहा है।
इस सामग्री में मशीन लर्निंग की बुनियादी अवधारणाओं से लेकर प्रमुख एल्गोरिदम, डेटा तैयार करने की प्रक्रिया और मॉडल के मूल्यांकन तथा अनुकूलन की विधियों तक व्यापक चर्चा की जाएगी।
मशीन लर्निंग की बुनियादी अवधारणाओं और कार्यप्रणाली को समझना
मशीन लर्निंग की बुनियादी अवधारणाएँ
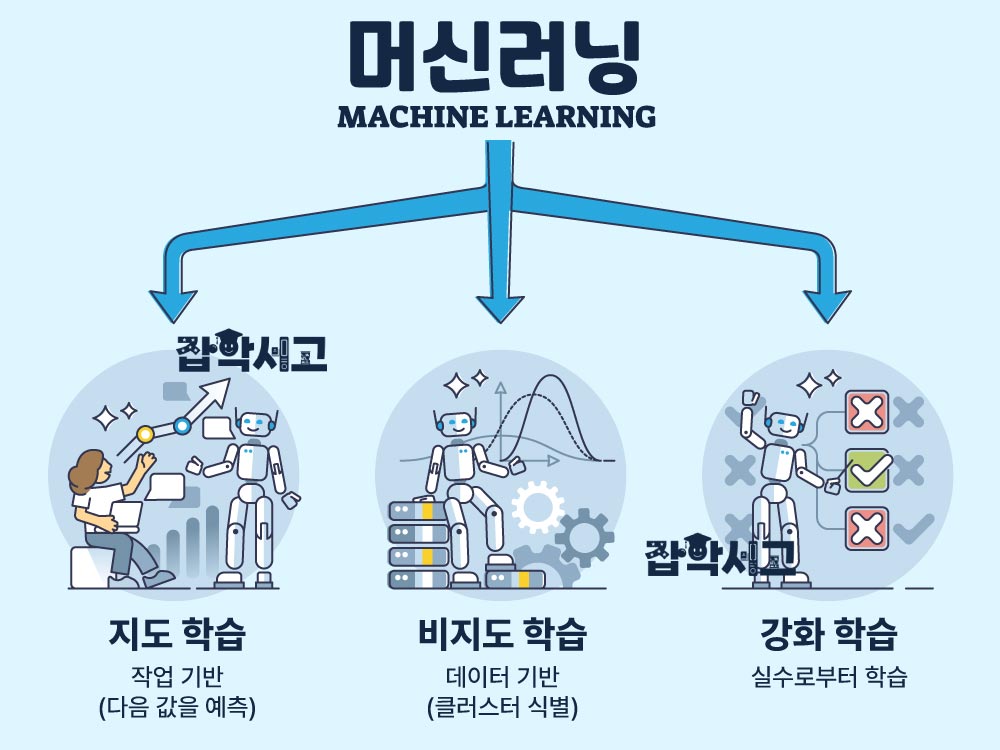
मशीन लर्निंग ऐसी तकनीक है जो कंप्यूटर को स्पष्ट प्रोग्रामिंग के बिना डेटा से सीखने और उसके आधार पर पूर्वानुमान लगाने या निर्णय लेने में सक्षम बनाती है। यह कृत्रिम बुद्धिमत्ता की एक शाखा है, जिसमें विभिन्न प्रकार के डेटा का विश्लेषण करके स्वयं नियम सीखने की प्रक्रिया अपनाई जाती है। मशीन लर्निंग को मुख्यतः तीन प्रकारों में बाँटा जाता है: पर्यवेक्षित अधिगम, अपर्यवेक्षित अधिगम और पुनर्बलन अधिगम। प्रत्येक अधिगम पद्धति को डेटा के स्वरूप या उद्देश्य के अनुसार अलग तरह से लागू किया जाता है, जिससे विभिन्न समस्याओं का समाधान किया जा सकता है।
पर्यवेक्षित अधिगम: डेटा और सही उत्तरों से सीखना
पर्यवेक्षित अधिगम में दिए गए डेटा और उसके सही उत्तरों यानी लेबल का उपयोग करके मॉडल को प्रशिक्षित किया जाता है। इस पद्धति में ऐसा मॉडल बनाया जाता है जो इनपुट डेटा के लिए आउटपुट मानों का पूर्वानुमान लगाए; प्रतिगमन विश्लेषण और वर्गीकरण इसके प्रमुख एल्गोरिदम हैं। प्रतिगमन विश्लेषण का उपयोग सतत संख्यात्मक मानों के पूर्वानुमान के लिए किया जाता है, जबकि वर्गीकरण डेटा को असतत श्रेणियों में बाँटने के लिए उपयोग होता है। उदाहरण के लिए, मकानों की कीमतों का पूर्वानुमान लगाने वाला मॉडल या ईमेल स्पैम फ़िल्टरिंग में प्रयुक्त एल्गोरिदम पर्यवेक्षित अधिगम के उदाहरण हैं। पर्यवेक्षित अधिगम में अधिक डेटा इस्तेमाल करने से सटीकता बढ़ती है और यह कई उद्योगों में महत्वपूर्ण भूमिका निभाता है।
अपर्यवेक्षित अधिगम: बिना लेबल वाले डेटा में पैटर्न खोजना
अपर्यवेक्षित अधिगम ऐसी विधि है जिसमें सही उत्तरों के बिना उपलब्ध डेटा का विश्लेषण करके उसमें छिपे पैटर्न या संरचनाएँ खोजी जाती हैं। लेबल न होने के कारण इसका उपयोग मुख्यतः डेटा की अपनी विशेषताओं या समूहों को खोजने के लिए किया जाता है। क्लस्टरिंग और साहचर्य नियम अधिगम इसके प्रमुख एल्गोरिदम हैं; क्लस्टरिंग डेटा को समान समूहों में बाँटती है, जबकि साहचर्य नियम अधिगम डेटा के बीच सहसंबंध खोजता है। इस पद्धति का व्यापक उपयोग ग्राहक विभाजन और अनुशंसा प्रणालियों जैसे क्षेत्रों में होता है तथा अधिक डेटा उपलब्ध होने पर इससे अधिक जटिल और सूक्ष्म पैटर्न खोजे जा सकते हैं।
पुनर्बलन अधिगम: पुरस्कारों के माध्यम से सर्वोत्तम व्यवहार सीखना
पुनर्बलन अधिगम ऐसी पद्धति है जिसमें एजेंट परिवेश के साथ अंतःक्रिया करते हुए पुरस्कार को अधिकतम करने के लिए सर्वोत्तम व्यवहार सीखता है। एजेंट विभिन्न क्रियाएँ आज़माता है और उनके परिणामों के अनुसार पुरस्कार प्राप्त करता है, जिनके आधार पर वह बेहतर निर्णय लेना सीखता है। पुनर्बलन अधिगम का मुख्य उपयोग गेम AI, रोबोट नियंत्रण और स्वचालित वाहन संचालन जैसे क्षेत्रों में होता है, जहाँ अत्यंत गतिशील परिवेश में स्वयं सीखने की क्षमता आवश्यक होती है। इस अधिगम पद्धति में एजेंट प्रयास और त्रुटि से सीखता है, इसलिए सीखने की प्रक्रिया लंबी हो सकती है, लेकिन इससे मिलने वाले परिणाम बहुत उत्कृष्ट होते हैं।
डेटा की तैयारी और पूर्वप्रसंस्करण का महत्व
सफल मशीन लर्निंग मॉडल बनाने के लिए डेटा की तैयारी और पूर्वप्रसंस्करण आवश्यक हैं। डेटा पूर्वप्रसंस्करण में अनुपलब्ध मानों का प्रबंधन, अपवाद मानों को हटाना और डेटा का सामान्यीकरण जैसी प्रक्रियाएँ शामिल हैं; इनके बिना मॉडल का प्रदर्शन काफी गिर सकता है। इसके अतिरिक्त, मॉडल के अनुकूल उपयुक्त विशेषताओं (Feature) को चुनना और संसाधित करना भी महत्वपूर्ण है। केवल अधिक डेटा होने से अच्छे प्रदर्शन की गारंटी नहीं मिलती; उचित ढंग से व्यवस्थित डेटा आवश्यक होता है। मशीन लर्निंग मॉडल का प्रदर्शन डेटा की मात्रा और गुणवत्ता पर बहुत निर्भर करता है, इसलिए डेटा सावधानी से तैयार करना चाहिए।
मॉडल का मूल्यांकन और अनुकूलन
मॉडल को प्रशिक्षित करने के बाद उसके प्रदर्शन का मूल्यांकन और अनुकूलन करना आवश्यक होता है। इसके लिए डेटा को प्रशिक्षण डेटा और परीक्षण डेटा में बाँटकर मॉडल की पूर्वानुमान क्षमता का मूल्यांकन करना चाहिए। आम तौर पर क्रॉस वैलिडेशन (Cross Validation) के माध्यम से मॉडल का प्रदर्शन वस्तुनिष्ठ रूप से मापा जाता है और अतिअनुकूलन (Overfitting) या अल्पअनुकूलन (Underfitting) को रोकने के लिए हाइपरपैरामीटर ट्यूनिंग भी की जाती है। सर्वोत्तम प्रदर्शन प्राप्त करने के लिए विभिन्न मूल्यांकन मापकों, जैसे सटीकता, परिशुद्धता और रिकॉल, का उपयोग करके मॉडल के प्रदर्शन का गहन विश्लेषण करना चाहिए।
मशीन लर्निंग का भविष्य और अनुप्रयोग
मशीन लर्निंग का उपयोग विभिन्न उद्योगों में किया जाता है और इसके अनुप्रयोगों की संभावनाएँ असीम हैं। वित्त, चिकित्सा, विनिर्माण और सेवा जैसे क्षेत्रों में डेटा विश्लेषण तथा पूर्वानुमान के माध्यम से दक्षता को अधिकतम किया जा रहा है। विशेष रूप से स्वचालित वाहनों, चिकित्सकीय निदान, व्यक्तिगत विज्ञापन और वित्तीय निवेश जैसे क्षेत्रों में मशीन लर्निंग के विकास के साथ और अधिक नवाचार होंगे। मशीन लर्निंग का भविष्य उज्ज्वल बना हुआ है और इसके माध्यम से हम एक अधिक स्मार्ट तथा कुशल दुनिया में प्रवेश करेंगे।
प्रमुख मशीन लर्निंग एल्गोरिदम और उनके अनुप्रयोग क्षेत्र
प्रमुख मशीन लर्निंग एल्गोरिदम का अवलोकन
मशीन लर्निंग में कई प्रकार के एल्गोरिदम होते हैं और प्रत्येक समस्या की विशेषताओं के अनुसार उपयुक्त विधि प्रदान करता है। इन एल्गोरिदम का उपयोग विभिन्न अनुप्रयोग क्षेत्रों में होता है और ये डेटा विश्लेषण तथा पूर्वानुमान में महत्वपूर्ण योगदान देते हैं। प्रमुख मशीन लर्निंग एल्गोरिदम में रैखिक प्रतिगमन, लॉजिस्टिक प्रतिगमन, निर्णय वृक्ष, रैंडम फ़ॉरेस्ट, सपोर्ट वेक्टर मशीन (SVM), k-निकटतम पड़ोसी (k-NN), नाइव बेयज़ और न्यूरल नेटवर्क शामिल हैं। प्रत्येक एल्गोरिदम की समस्या हल करने की एक विशिष्ट पद्धति और उद्देश्य होता है, इसलिए उसकी विशेषताओं को ठीक से समझना और लागू करना महत्वपूर्ण है।
रैखिक प्रतिगमन: सतत डेटा का पूर्वानुमान
रैखिक प्रतिगमन सतत डेटा के पूर्वानुमान के लिए उपयोग होने वाले सबसे बुनियादी एल्गोरिदम में से एक है। यह एक या अधिक स्वतंत्र चरों और आश्रित चर के बीच रैखिक संबंध का मॉडल बनाता है तथा डेटा के आधार पर पूर्वानुमान लगाने पर केंद्रित रहता है। उदाहरण के लिए, आवास की कीमतों या बिक्री की मात्रा के पूर्वानुमान में रैखिक प्रतिगमन का व्यापक उपयोग होता है। रैखिक प्रतिगमन डेटा की प्रवृत्ति समझने और भविष्य के मानों का पूर्वानुमान लगाने में उपयोगी है, लेकिन डेटा रैखिक न होने पर इसकी सटीकता घट सकती है।
लॉजिस्टिक प्रतिगमन: द्विआधारी वर्गीकरण की समस्याओं का समाधान
लॉजिस्टिक प्रतिगमन द्विआधारी वर्गीकरण की समस्याओं के लिए उपयुक्त एल्गोरिदम है और इसका उपयोग उन समस्याओं को हल करने में किया जाता है जिनके परिणाम दो श्रेणियों में बँटते हैं। उदाहरण के लिए, स्पैम ईमेल के वर्गीकरण या रोग की उपस्थिति अथवा अनुपस्थिति के पूर्वानुमान में इसका व्यापक उपयोग होता है। लॉजिस्टिक प्रतिगमन डेटा के आधार पर प्रायिकता की गणना करता है और उसके परिणाम से वर्गीकरण करता है। विशेष रूप से वर्गीकरण की समस्याओं में यह उच्च विश्वसनीयता प्रदान करता है और मध्यम जटिलता वाले डेटा पर भी अच्छा प्रदर्शन करता है।
निर्णय वृक्ष: सहज और आसानी से व्याख्या किया जा सकने वाला मॉडल
निर्णय वृक्ष निर्णय लेने की प्रक्रिया को वृक्ष संरचना में दर्शाने की विधि है और यह सहज तथा आसानी से व्याख्या किया जा सकने वाला मॉडल है। इसमें प्रत्येक नोड पर शर्त की जाँच करके उसके अनुसार निर्णय लिया जाता है और इसका उपयोग वर्गीकरण तथा प्रतिगमन, दोनों प्रकार की समस्याओं में होता है। उदाहरण के लिए, ग्राहक के सेवा छोड़ने की संभावना का पूर्वानुमान लगाने या किसी विशेष उत्पाद की अनुशंसा करने में यह उपयोगी है। लेकिन निर्णय वृक्ष में अतिअनुकूलन (overfitting) आसानी से हो सकता है, जिससे मॉडल अत्यधिक जटिल हो सकता है।
रैंडम फ़ॉरेस्ट: एन्सेम्बल अधिगम का एक प्रमुख उदाहरण
रैंडम फ़ॉरेस्ट एन्सेम्बल अधिगम की ऐसी विधि है जो कई निर्णय वृक्षों को जोड़कर पूर्वानुमान के प्रदर्शन में सुधार करती है। यह एकल निर्णय वृक्ष की तुलना में अधिक स्थिर और सटीक पूर्वानुमान प्रदान करती है तथा अतिअनुकूलन की समस्या को कम करने में बहुत प्रभावी है। वित्तीय क्षेत्र में धोखाधड़ी का पता लगाने और क्रेडिट स्कोर का पूर्वानुमान लगाने जैसे कार्यों में रैंडम फ़ॉरेस्ट का विशेष रूप से व्यापक उपयोग होता है। इसके अतिरिक्त, डेटा की जटिलता चाहे जैसी हो, उच्च विश्वसनीयता बनाए रख पाना इसका एक लाभ है।
सपोर्ट वेक्टर मशीन (SVM): उच्च आयामों में वर्गीकरण
सपोर्ट वेक्टर मशीन (SVM) ऐसा एल्गोरिदम है जो डेटा को उच्च आयामी स्थान में रूपांतरित करके सर्वोत्तम वर्गीकरण सीमा खोजता है। यह विशेष रूप से चेहरा पहचानने और पाठ वर्गीकरण जैसी समस्याओं में उच्च प्रदर्शन दिखाता है। कम डेटा होने पर भी SVM उत्कृष्ट प्रदर्शन करता है और विशेष रूप से स्पष्ट सीमाओं वाली वर्गीकरण समस्याओं में इसकी क्षमता प्रभावशाली होती है। हालाँकि, डेटा अधिक या जटिल होने पर प्रशिक्षण में अधिक समय लग सकता है।
न्यूरल नेटवर्क और डीप लर्निंग: जटिल पैटर्न की पहचान
न्यूरल नेटवर्क मानव मस्तिष्क की संरचना की नकल करने वाला एल्गोरिदम है, जो जटिल पैटर्न पहचानने में उत्कृष्ट है। विशेष रूप से डीप लर्निंग न्यूरल नेटवर्क की एक शाखा है, जो बहुपरतीय न्यूरल नेटवर्क का उपयोग करके बड़े पैमाने के डेटा विश्लेषण में उत्कृष्ट प्रदर्शन करती है। छवि पहचान, वाक् पहचान और प्राकृतिक भाषा प्रसंस्करण जैसे विभिन्न क्षेत्रों में इसके परिणाम उत्कृष्ट हैं और इसका उपयोग लगातार बढ़ रहा है। डीप लर्निंग के लिए विशाल मात्रा में डेटा और उच्च गणना क्षमता आवश्यक है, लेकिन उसी अनुपात में इससे नवाचारी परिणाम भी प्राप्त किए जा सकते हैं।
k-निकटतम पड़ोसी (k-NN): सरल लेकिन शक्तिशाली एल्गोरिदम
k-निकटतम पड़ोसी (k-NN) ऐसा एल्गोरिदम है जो नए डेटा की मौजूदा डेटा से तुलना करता है और सबसे नज़दीकी k पड़ोसियों को खोजकर उसका वर्गीकरण करता है। इस एल्गोरिदम की गणना सरल होती है, लेकिन बड़े डेटा में गति और मेमोरी की खपत समस्या बन सकती है। इसका मुख्य उपयोग पैटर्न पहचान और अनुशंसा प्रणालियों जैसे क्षेत्रों में होता है तथा यह सहज तरीके से डेटा की समानता के आधार पर निर्णय लेता है।
नाइव बेयज़: प्रायिकता पर आधारित वर्गीकरण
नाइव बेयज़ प्रायिकता सिद्धांत पर आधारित वर्गीकरण एल्गोरिदम है, जो सशर्त प्रायिकता की गणना करके डेटा का वर्गीकरण करता है। इसका मुख्य उपयोग पाठ वर्गीकरण और भाव विश्लेषण जैसे क्षेत्रों में होता है तथा यह सरल होने के साथ उच्च प्रदर्शन भी दिखाता है। नाइव बेयज़ यह मानता है कि सभी विशेषताएँ स्वतंत्र हैं, लेकिन वास्तविक डेटा में यह धारणा सही न होने पर भी अच्छे परिणाम दे पाना इसका एक लाभ है।
एल्गोरिदम के चयन का महत्व
विभिन्न मशीन लर्निंग एल्गोरिदम को प्रत्येक समस्या की परिस्थिति के अनुसार चुना और लागू किया जाना चाहिए। समस्या की विशेषताओं तथा डेटा के स्वरूप के अनुसार उपयुक्त एल्गोरिदम चुनना महत्वपूर्ण है और इससे सर्वोत्तम परिणाम प्राप्त किए जा सकते हैं। मशीन लर्निंग के सफल उपयोग के लिए प्रत्येक एल्गोरिदम की विशेषताओं और सीमाओं को समझना तथा समस्या के समाधान के लिए सबसे उपयुक्त विधि चुनना आवश्यक है।
डेटा की तैयारी और पूर्वप्रसंस्करण: सफल मशीन लर्निंग का आधार
डेटा की तैयारी और पूर्वप्रसंस्करण का महत्व
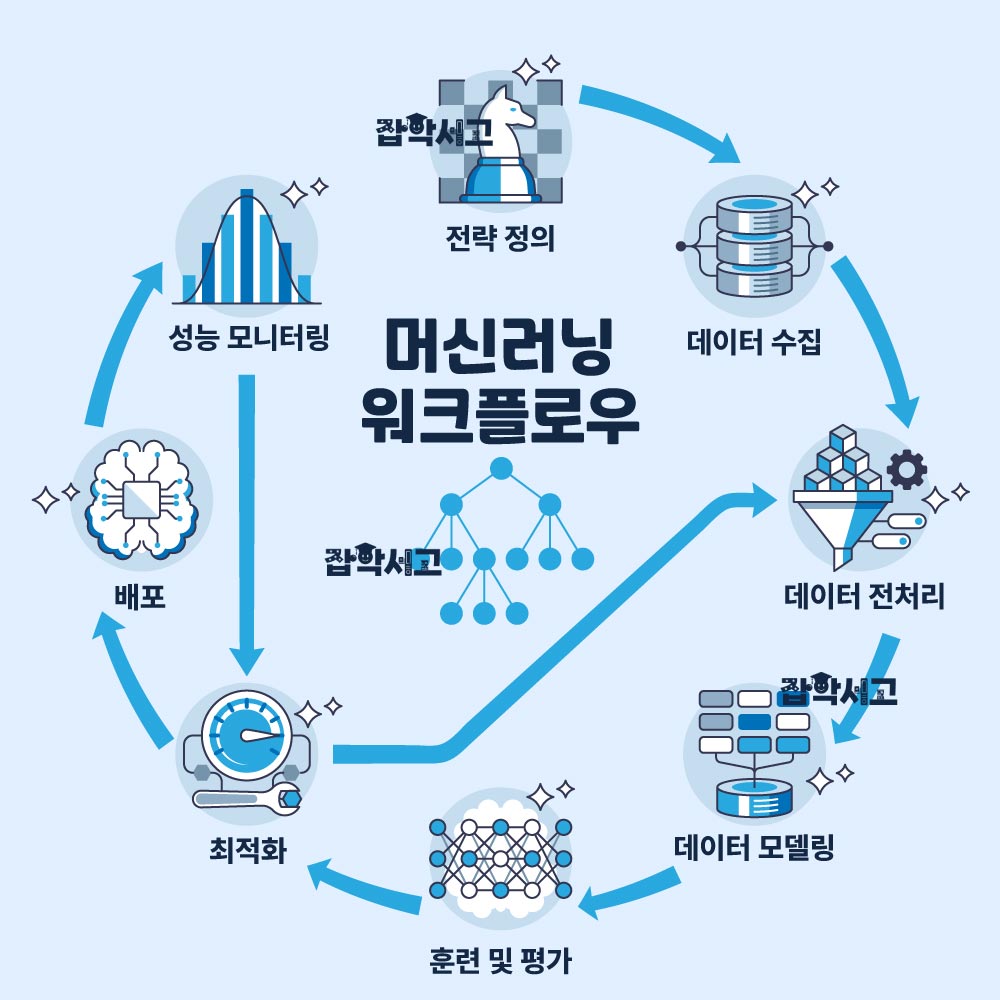
मशीन लर्निंग परियोजना की सफलता या विफलता इस बात पर निर्भर करती है कि डेटा की तैयारी और पूर्वप्रसंस्करण कितनी गहनता से किया गया है। डेटा मशीन लर्निंग मॉडल के प्रदर्शन को सीधे प्रभावित करता है, इसलिए हर प्रक्रिया में उसे सावधानी से संभालना आवश्यक है। डेटा संग्रह, शोधन, रूपांतरण, विशेषता निष्कर्षण और चयन जैसे चरण मॉडल के प्रदर्शन को अनुकूलित करने के बुनियादी कार्य हैं; यदि इन्हें ठीक से नहीं किया जाए, तो मशीन लर्निंग मॉडल विश्वसनीय परिणाम देने में असमर्थ हो सकता है।
डेटा संग्रह: मात्रा और गुणवत्ता सुनिश्चित करना
डेटा संग्रह मॉडल को प्रशिक्षित करने के लिए डेटा जुटाने का पहला चरण है। इस प्रक्रिया में वेब स्क्रैपिंग, डेटाबेस क्वेरी और API कॉल जैसी विभिन्न विधियों से डेटा एकत्र किया जाता है। डेटा की मात्रा के साथ उसकी गुणवत्ता भी बहुत महत्वपूर्ण है। मॉडल को विभिन्न पैटर्न सीखने के लिए पर्याप्त मात्रा में डेटा चाहिए और डेटा की गुणवत्ता घटने पर मॉडल के पूर्वानुमान की सटीकता भी कम होती है। इसलिए इस चरण में यथासंभव विश्वसनीय और उच्च गुणवत्ता वाला डेटा प्राप्त करना महत्वपूर्ण है।
डेटा शोधन: शोर और दोष हटाना
डेटा शोधन एकत्रित डेटा से त्रुटियों या अनावश्यक तत्वों को हटाने की प्रक्रिया है। इसमें अनुपलब्ध मानों का प्रबंधन, दोहराव हटाना तथा अपवाद मानों का पता लगाना और उन्हें सुधारना शामिल है। मशीन लर्निंग मॉडल डेटा की गुणवत्ता पर बहुत निर्भर करता है, इसलिए अशोधित डेटा शामिल होने पर मॉडल गलत पैटर्न सीख सकता है या उसके पूर्वानुमान की सटीकता काफी घट सकती है। इस चरण में अनुपलब्ध मानों का प्रबंधन विशेष रूप से महत्वपूर्ण है और उन्हें हटाने या उचित तरीके से प्रतिस्थापित करने की आवश्यकता होती है। गलत डेटा के बने रहने से मॉडल का प्रदर्शन बहुत प्रभावित होता है, इसलिए डेटा शोधन सावधानीपूर्वक किया जाना चाहिए।
डेटा रूपांतरण: मॉडल के अनुरूप डेटा का प्रसंस्करण
डेटा रूपांतरण एकत्रित डेटा को ऐसे स्वरूप में बदलने की प्रक्रिया है जिसे मॉडल समझ सके। इसमें स्केलिंग, मानकीकरण और सामान्यीकरण जैसे कार्य शामिल होते हैं। उदाहरण के लिए, सभी चरों की इकाइयों को एकसमान करने के लिए मानकीकरण की आवश्यकता हो सकती है या श्रेणीबद्ध चरों को संख्यात्मक रूप में बदलने के लिए वन-हॉट एन्कोडिंग (One-Hot Encoding) की आवश्यकता पड़ सकती है। इन रूपांतरण कार्यों से मॉडल डेटा को कुशलता से संसाधित कर सकता है और उससे सीख सकता है। यह प्रक्रिया ठीक से न होने पर मॉडल डेटा की विशेषताओं को सही ढंग से प्रतिबिंबित नहीं कर पाता, जिससे उसका प्रदर्शन घट सकता है।
विशेषता निष्कर्षण: महत्वपूर्ण जानकारी को उभारना
विशेषता निष्कर्षण मूल डेटा से महत्वपूर्ण जानकारी निकालकर नई विशेषताएँ बनाने की प्रक्रिया है। यह कार्य मॉडल के प्रदर्शन को अधिकतम करने के लिए केंद्रीय महत्व रखता है। उदाहरण के लिए, समय श्रृंखला डेटा में आवर्तिता या प्रवृत्ति का विश्लेषण करके सार्थक विशेषताएँ खोजना अथवा पाठ डेटा से महत्वपूर्ण मुख्य शब्द निकालना विशेषता निष्कर्षण के प्रमुख उदाहरण हैं। विशेषता निष्कर्षण से डेटा की मूलभूत विशेषताओं को बेहतर समझने में मदद मिलती है और मॉडल महत्वपूर्ण पैटर्न सीख पाता है।
विशेषता चयन: मॉडल के प्रदर्शन को अनुकूलित करने का कार्य
विशेषता चयन कई चरों में से केवल उन्हीं विशेषताओं को चुनने की प्रक्रिया है जो मॉडल के प्रशिक्षण के लिए महत्वपूर्ण हैं। अनावश्यक चरों को हटाकर मॉडल की जटिलता कम की जा सकती है और प्रशिक्षण की गति तथा पूर्वानुमान की सटीकता बढ़ाई जा सकती है। इस प्रक्रिया में सहसंबंध विश्लेषण और प्रमुख घटक विश्लेषण (PCA) जैसी विभिन्न सांख्यिकीय विधियों से महत्वपूर्ण विशेषताएँ चुनी जाती हैं और मॉडल को अतिअनुकूलन से बचाया जाता है। अनावश्यक डेटा हटाने से मॉडल की व्याख्या करना भी आसान हो जाता है, इसलिए विशेषता चयन मशीन लर्निंग का एक बहुत महत्वपूर्ण चरण है।
गहन डेटा तैयारी और पूर्वप्रसंस्करण की आवश्यकता
डेटा की तैयारी और पूर्वप्रसंस्करण में बहुत समय लगता है, लेकिन सफल मशीन लर्निंग परियोजना के लिए ये आवश्यक प्रक्रियाएँ हैं। इस चरण में डेटा की गुणवत्ता और संरचना को उचित ढंग से तैयार करने पर ही सटीक तथा विश्वसनीय पूर्वानुमान मॉडल बनाया जा सकता है। डेटा वैज्ञानिकों में केवल डेटा का विश्लेषण करने से आगे बढ़कर उसकी विशेषताओं को समझने और उचित ढंग से संसाधित करने की क्षमता भी होनी चाहिए। गहन डेटा पूर्वप्रसंस्करण के बिना अत्यंत जटिल मॉडल भी अविश्वसनीय परिणाम ही देगा।
मशीन लर्निंग मॉडल के मूल्यांकन और अनुकूलन की विधियों का विश्लेषण
मशीन लर्निंग मॉडल के मूल्यांकन का महत्व
मशीन लर्निंग मॉडल बनाने के बाद उसके प्रदर्शन का वस्तुनिष्ठ मूल्यांकन करना आवश्यक है। मॉडल मूल्यांकन (Evaluation) वह चरण है जिसमें मापा जाता है कि मॉडल दी गई समस्या को कितनी प्रभावी ढंग से हल करता है और इसके लिए विभिन्न मूल्यांकन मापकों का उपयोग होता है। प्रत्येक मापक मॉडल के प्रदर्शन का अलग दृष्टिकोण से विश्लेषण करता है और परिस्थिति के अनुसार उपयुक्त मापक चुनना चाहिए।
वर्गीकरण मॉडल के मूल्यांकन मापक
वर्गीकरण मॉडल के मूल्यांकन में मुख्यतः सटीकता (Accuracy), परिशुद्धता (Precision), रिकॉल (Recall) और F1 स्कोर (F1 Score) जैसे मापकों का उपयोग होता है। सटीकता कुल डेटा में मॉडल द्वारा सही पूर्वानुमान किए गए मामलों का अनुपात बताती है, लेकिन डेटा में बहुत असंतुलन होने पर अकेले इसके उपयोग की सीमाएँ हैं। परिशुद्धता मॉडल द्वारा सकारात्मक बताए गए मामलों में वास्तव में सकारात्मक मामलों का अनुपात है, जबकि रिकॉल वास्तव में सकारात्मक मामलों में उन मामलों का अनुपात है जिन्हें मॉडल ने सकारात्मक बताया है। F1 स्कोर परिशुद्धता और रिकॉल को समन्वित करने वाला मापक है और दोनों मापकों के संतुलन पर ज़ोर देने के लिए उपयोगी है। उदाहरण के लिए, चिकित्सकीय निदान प्रणाली में रिकॉल महत्वपूर्ण है, ताकि वास्तव में सकारात्मक रोगियों में से यथासंभव कोई छूट न जाए।
प्रतिगमन मॉडल के मूल्यांकन मापक
प्रतिगमन मॉडल के प्रदर्शन के मूल्यांकन के लिए माध्य निरपेक्ष त्रुटि (MAE), माध्य वर्ग त्रुटि (MSE) और निर्धारण गुणांक (R²) आदि का उपयोग किया जाता है। MAE पूर्वानुमानित और वास्तविक मानों के अंतर के निरपेक्ष मानों का औसत लेकर मॉडल की पूर्वानुमान त्रुटि का मूल्यांकन करता है। MSE पूर्वानुमानित और वास्तविक मानों के अंतर के वर्गों का औसत है, जिसमें बड़ी त्रुटियों को अधिक महत्व मिलता है। R² यह बताता है कि मॉडल डेटा की कितनी अच्छी व्याख्या करता है और इसका मान 1 के जितना निकट हो, मॉडल उतना ही बेहतर माना जाता है। उदाहरण के लिए, आवास की कीमतों का पूर्वानुमान लगाने वाले मॉडल में MSE पूर्वानुमान की सटीकता के मूल्यांकन में महत्वपूर्ण भूमिका निभाता है।
अतिअनुकूलन और अल्पअनुकूलन की रोकथाम
जब मॉडल प्रशिक्षण डेटा पर अत्यधिक केंद्रित हो जाता है, तो अतिअनुकूलन (Overfitting) होता है; इसके विपरीत, जब वह डेटा से पर्याप्त रूप से नहीं सीख पाता, तो अल्पअनुकूलन (Underfitting) होता है। अतिअनुकूलित मॉडल प्रशिक्षण डेटा पर बहुत अच्छा प्रदर्शन करता है, लेकिन नए डेटा पर उसका प्रदर्शन घट जाता है। अल्पअनुकूलन वह स्थिति है जिसमें प्रशिक्षण डेटा के पैटर्न ठीक से नहीं समझे गए होते और मॉडल का समग्र प्रदर्शन कम होता है। अतिअनुकूलन रोकने के लिए डेटा की मात्रा बढ़ाई जा सकती है या नियमितीकरण (Regularization) तकनीक अपनाई जा सकती है, जबकि अल्पअनुकूलन रोकने के लिए अधिक जटिल मॉडल का उपयोग आवश्यक हो सकता है।
क्रॉस वैलिडेशन के माध्यम से मॉडल का मूल्यांकन
क्रॉस वैलिडेशन (Cross-Validation) मॉडल की सामान्यीकरण क्षमता का मूल्यांकन करने की बहुत उपयोगी विधि है। इसमें डेटा को कई फ़ोल्ड में बाँटने के बाद प्रत्येक फ़ोल्ड के लिए मॉडल को प्रशिक्षित और उसका मूल्यांकन किया जाता है। यह पद्धति डेटा विभाजन के कारण मूल्यांकन परिणामों में आने वाली परिवर्तनशीलता कम करती है और प्रदर्शन का अधिक सटीक मूल्यांकन संभव बनाती है। विशेष रूप से कम डेटा उपलब्ध होने या मॉडल के प्रदर्शन का अधिक सटीक मूल्यांकन करने की आवश्यकता होने पर क्रॉस वैलिडेशन का व्यापक उपयोग होता है।
हाइपरपैरामीटर अनुकूलन
मॉडल के प्रदर्शन को अधिकतम करने के लिए हाइपरपैरामीटर अनुकूलन (Hyperparameter Optimization) की प्रक्रिया आवश्यक है। हाइपरपैरामीटर ऐसे सेटिंग मान हैं जो मॉडल के प्रशिक्षण को सीधे प्रभावित करते हैं और उनके समायोजन के तरीके के अनुसार मॉडल का प्रदर्शन काफी बदल सकता है। ग्रिड सर्च (Grid Search) सभी संभावित हाइपरपैरामीटर संयोजनों की खोज करने की विधि है, जबकि रैंडम सर्च (Random Search) कुछ संयोजनों को यादृच्छिक रूप से चुनकर उनकी खोज करने की विधि है। हाल में अधिक कुशल बेयज़ियन अनुकूलन (Bayesian Optimization) अपनाया गया है, जो कम गणना के साथ भी सर्वोत्तम हाइपरपैरामीटर खोजने में लाभदायक है।
मॉडल की जटिलता और प्रदर्शन का संतुलन
अनुकूलन की प्रक्रिया में मॉडल की जटिलता और प्रदर्शन के बीच संतुलन बनाए रखना महत्वपूर्ण है। मॉडल अत्यधिक जटिल होने पर अतिअनुकूलन की संभावना बढ़ती है और इसके विपरीत, बहुत सरल होने पर अल्पअनुकूलन हो सकता है। इसे हल करने के लिए नियमितीकरण (Regularization) तकनीकों से मॉडल की जटिलता नियंत्रित की जा सकती है या ड्रॉपआउट (Dropout) के माध्यम से न्यूरल नेटवर्क मॉडल में अतिअनुकूलन रोका जा सकता है। अंततः अनुकूलन का लक्ष्य जटिलता और प्रदर्शन का उचित समायोजन करके ऐसा मॉडल बनाना है जो नए डेटा पर भी अच्छा प्रदर्शन करे।
मूल्यांकन और अनुकूलन का महत्व
मशीन लर्निंग मॉडल का मूल्यांकन और अनुकूलन केवल वैकल्पिक कार्य नहीं, बल्कि सफल मशीन लर्निंग परियोजना के लिए आवश्यक प्रक्रियाएँ हैं। मूल्यांकन मापकों से मॉडल के प्रदर्शन का गहन विश्लेषण करना चाहिए और हाइपरपैरामीटर अनुकूलन से उसके प्रदर्शन को अधिकतम करना चाहिए। इससे अतिअनुकूलन और अल्पअनुकूलन की समस्याओं को हल करके डेटा के लिए सर्वोत्तम मॉडल बनाया जा सकता है।
मशीन लर्निंग आधुनिक डेटा विश्लेषण में महत्वपूर्ण स्थान रखती है और विभिन्न क्षेत्रों में नवाचारी बदलावों का नेतृत्व कर रही है। इसके सफल उपयोग के लिए मशीन लर्निंग की बुनियादी अवधारणाओं की पर्याप्त समझ, उपयुक्त एल्गोरिदम का चयन तथा डेटा की गहन तैयारी और पूर्वप्रसंस्करण आवश्यक हैं।
इसके अतिरिक्त, मॉडल के प्रदर्शन का मूल्यांकन और अनुकूलन मशीन लर्निंग की सफलता का बहुत महत्वपूर्ण हिस्सा है। इन प्रक्रियाओं के माध्यम से अधिक सटीक पूर्वानुमान और प्रभावी निर्णय संभव होते हैं तथा डेटा क्रांति के युग के अनुकूल नवाचारी समाधान प्रस्तुत किए जा सकते हैं।