今回は、図書館で目録作成に使われるMARCの構造を詳しく見ていきます。もちろん、この構造や仕組みを知らなくてもMARCの作業に支障はありませんが、理解しておけば、状況に応じて起こるさまざまな事態への対応力が高まると思います。
本資料では、『三国志』という本を例に、その構造を詳しく分析していきます。
MARC入門
 韓国国立中央図書館『三国志』の書誌情報
まず、本資料で例として取り上げる『三国志』の書誌情報を、韓国国立中央図書館のウェブサイトで検索した画面です。目的の本を検索した後、上部の[MARC表示/ダウンロード]ボタンを押すと、MARC情報の表示やダウンロードができます。
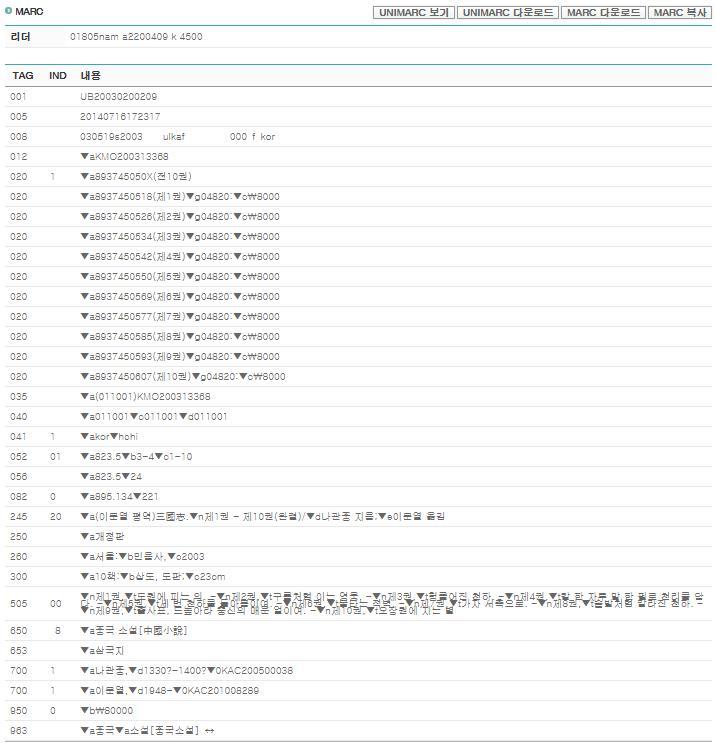 MARC表示
上の画像は、[MARC表示]で確認した『三国志』の目録作成結果です。図書館情報学を専攻している人や図書館で働いている人なら、見慣れた画面でしょう。
この画面では、タグを中心に、インディケータや識別記号などで区分された書誌情報を確認できます。
これに関連して、目録作成に使うKORMARCのタグについては、以下の資料が参考になるでしょう。
今回の資料では、「MARC表示」画面からさらに一歩踏み込み、上のような画面が表示される仕組みを見ていきます。
この画面ではMARCファイルをダウンロードすることもできます。そのファイルをダウンロードして、ハングル文書として開いた結果が以下のとおりです。
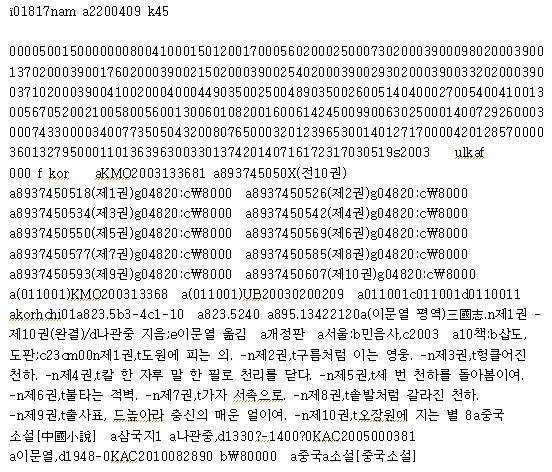 雑然と並ぶ文字(MARCの元データ)
この内容を見て、何か感じることがあるでしょう。ウェブサイトで表示されていた整理された内容とは異なり、とても複雑で雑然として見えます。並び順も、先ほどタグごとに整理されていた内容とは異なり、数字だけが延々と並んだ後に、本の情報が出てきます。
つまり、先ほどの タグ-インディケータ-フィールド という順序できれいに表示されていたものとは異なり、それまで見えていなかったディレクトリが含まれ、 リーダー-ディレクトリ-フィールド の情報が表示されているのです。
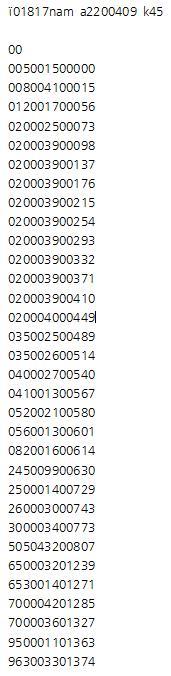 数字を整理した結果
雑然と並んでいた数字を12桁ずつ区切って整理した結果が、上の画像です。これらの数字の先頭の文字をよく見るとわかるように、MARCのタグ番号を表しています。
なお、キャプチャ画像の上部で「00」が離れている箇所は、本来は最上行のリーダーの末尾で4500となるべきものです。
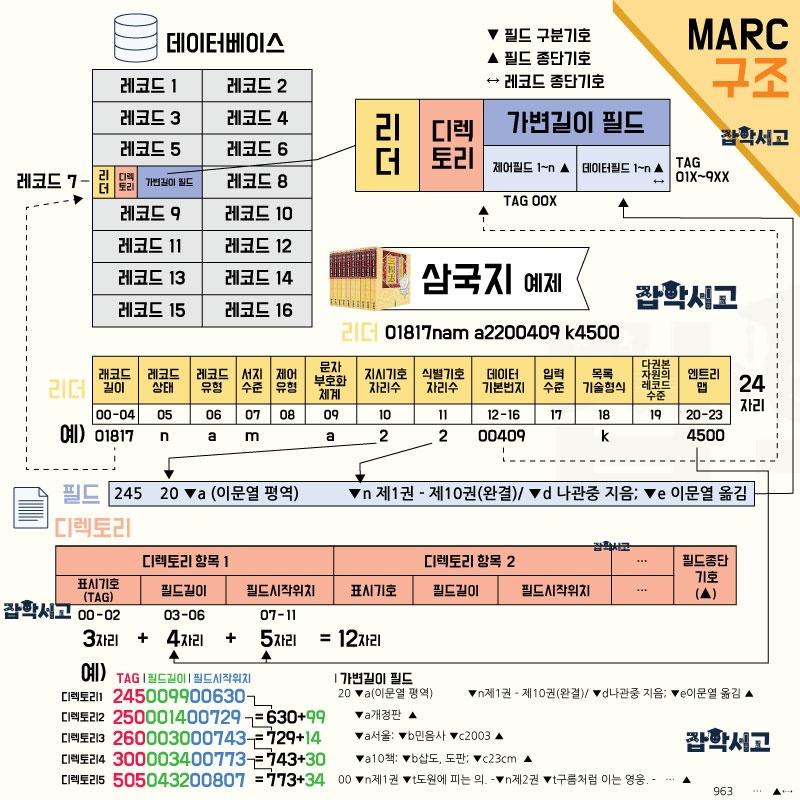
それでは、なぜ数字を12桁ずつ区切ったのか、それまでわからなかったリーダーやディレクトリとは何なのか、以下の画像を通して確認していきます。
MARCの構造と仕組み
 MARCの構造概念図
先ほどの複雑な情報をひと目で把握しやすいように、画像にまとめて整理してみました。情報が多く複雑に見えるかもしれませんが、上から順に丁寧に見ていけば、先ほどの複雑な数字や内容がどのように構成されているかがわかるでしょう。
最上位の概念といえるのは、すべての情報を格納している データベースであり、その中には、それぞれの本の情報を格納した レコードが無数に収められています。
(DB > レコード > リーダー > ディレクトリ > フィールド)
こうしたレコードは、リーダー、ディレクトリ、可変長フィールドに分けられ、 リーダーは24文字で構成され、そのレコードに関する基本情報や検索のための情報を格納しています。また、 ディレクトリは、MARCの作業画面で行(列)の単位となる各フィールドの情報(TAG[3文字]、長さ[4文字]、開始位置[5文字])を格納しています。
ここで、各ディレクトリは12文字で構成されており、実際のMARCデータでは、可変長フィールドが現れるまで区切りなく連続しています。
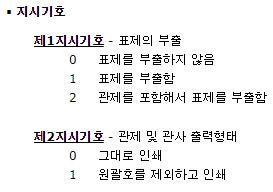 245 TAGのインディケータ
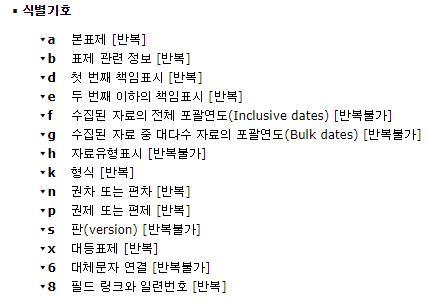 245 TAGの識別記号
最後の 可変長フィールドには、通常、MARC表示で見られるインディケータ、識別記号(▼)、書誌情報などの内容が格納されており、各フィールドの末尾にはフィールド終端記号(▲)を、各レコードの末尾にはレコード終端記号(↔)を入れます。
以上、MARCの構造と仕組みについて見てきました。本内容は統合書誌用KORMARCを基準に作成したもので、今後新しいMARCが登場すれば一部が変わる可能性はありますが、大枠ではこれと似た方式になると思われます。
しっかりと身につけたい場合は、MARCの構造を参考にしながら、韓国国立中央図書館のウェブサイトで実際にMARCデータをダウンロードし、本資料のように各要素を分析すると、理解を深められるでしょう。