假设医院发现,从全体患者来看,A疗法比B疗法效果更好,但按轻症、重症分开来看,两组中都是B更好,你会选择哪种疗法?这种数字一“合并”就反转的奇怪现象,在数据解读中反复出现。这就是“辛普森悖论(Simpson’s Paradox)”。
简单来说,辛普森悖论是指“分别观察多个群体时呈现出某一方向的关系,但把这些群体合并后,这种关系减弱甚至完全反转”的现象。爱德华·辛普森(Edward H. Simpson)于1951年对其进行了总结,而在此之前,卡尔·皮尔逊(Karl Pearson)在1899年、乌德尼·尤尔(Udny Yule)在1903年也提到过类似的案例。
本文将通俗易懂地梳理辛普森悖论的定义与产生原理、具有代表性的真实案例,以及解读数据时避免陷入其中的检查要点。
辛普森悖论的结构与解读原则
什么是辛普森悖论?
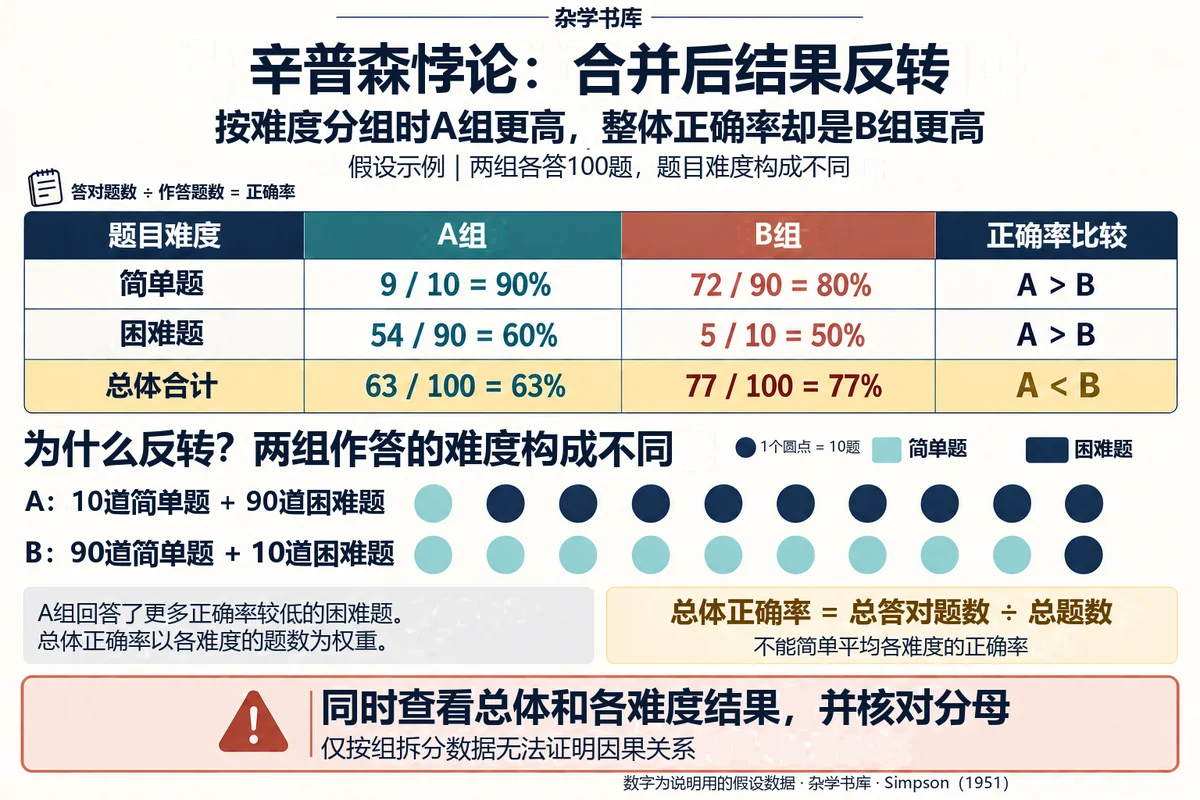
辛普森悖论并不是简单的计算错误。比如在每个群体内部A的成功率都高于B,但合并起来后B的成功率反而更高——当“部分之和”与“整体”不一致时,悖论就成立了。凭直觉很容易认为“每一部分都赢,整体也应该赢”,但在把比率合并的那一刻,这种直觉就可能失灵。
为什么会发生这种情况?关键在于各群体的样本量和构成不同。例如,如果A疗法多用于重症患者,B疗法多用于轻症患者,那么A的整体成功率会被重症患者的比例拉低,而B的则被轻症患者的比例拉高。即使在各群体中A都胜出,合并之后呈现的却是B胜出的局面。
- 组内趋势(Within-group trend):在各个子群体内部观察到的关系方向。
- 整体趋势(Aggregate trend):将子群体合并后观察到的关系方向。
- 悖论(Paradox):两种方向彼此不一致或相反的状态。
数字为何会反转:混杂变量的作用
统计学认为,这一现象背后存在“混杂变量(Confounding Variable)”或“潜伏变量(Lurking Variable)”。也就是说,第三个变量同时扰动了我们所关注的两个变量之间的关系。
(1)群体规模不均衡
如果样本集中在某一个群体,该群体的结果就会在整体中被过度体现。即使小群体中有明显的效果,大群体中相反的效果也可能左右总体结果。
(2)处理与条件同时变化
如果疗法没有随机分配给难治和易治的患者,“疗法的效果”与“患者的状况”就会混在一起。这时如果只看汇总表,很容易误以为是疗法本身好或不好。
(3)比率的加权平均
成功率不是简单平均,而是按人数加权的平均。如果各群体的权重不同,各群体内部的胜负与整体的胜负就可能不一致。
简单来说,辛普森悖论是一盏警示灯,提醒我们“按什么层次来划分”可能会改变结论。
通过简单案例理解辛普森悖论
最常被引用的案例之一是肾结石治疗的比较。只看整体时,外科治疗与非外科治疗中似乎有一方占优,但有报告显示,按结石较小和较大的情况分开后,占优的一方会发生反转。如果省略了“对谁、在什么条件下”,治疗成绩单就会被扭曲。
棒球击球率也可以用类似的结构来解释。有时选手A在上半赛季和下半赛季的击球率都高于选手B,但合并整个赛季来看,B的击球率反而更高。这是因为不同时期的出场局数和打席数差异很大。也就是说,“各时期的赢家”与“整个赛季的赢家”可能不同,这很好地说明了只用一行数据阅读成绩单时产生的错觉。
在大学录取率的争论中也会用到类似的逻辑。只看整体录取率,性别差距似乎很大,但按院系分开来看,差距有时会消失或缩小。此时关键不是马上得出“不存在歧视”的结论,而是要追问是哪个层次(院系、申请规模、竞争率)主导了整体结果。
[案例要点]
- 不要只相信汇总表,要重新拆分成有意义的子群体。
- 同时标注各子群体的规模(权重)。
- 单独说明“为什么人会集中在那个群体”。
解读数据时不掉入陷阱的4个习惯
没有能完全“消除”辛普森悖论的公式。但只要改变解读习惯,就能大大降低掉入陷阱的概率。
(1)先确定分层
事先列出性别、年龄、严重程度、地区、产品类别等可能影响结果的变量,把汇总表和分层表并排对照。
(2)比率与人数一起看
即使成功率是80%,如果样本只有5人,意义也完全不同。对于隐藏分母(尝试次数、人数)的图表要保持怀疑。
(3)区分因果与相关
不能因为合并结果发生了反转,就立刻断定“原因”。首先要确认是否有实验设计或随机分配。
(4)明确结论的单位
在句子中写清楚是“以全体患者为准”还是“以重症患者为准”。即使是同样的数据,参照群体一变,建议也可能随之改变。
新闻中的民意调查、医院成绩单、应用程序的A/B测试、学校招生统计——凡是出现比率的地方,辛普森悖论都可能现身。汇总数字越方便,越需要再拆分一次的态度。越是华丽的信息图,分母和分层越常被隐藏,因此养成先确认“这个数字的单位是什么”的习惯会很有帮助。
不在汇总数字面前止步,而是追问“是哪些层次造就了这个数字”,这才是统计思维的第一步。