体检时听到准确率99%的检查呈阳性,多数人会觉得自己患病的可能性也大约是99%。可如果这种病在一万人里大约只出现一例,情况就完全不同了。被眼前的证据吸引,忘掉“这件事本来有多常见”——这种判断陷阱,就是“基率谬误(Base Rate Fallacy)”。
简单来说,基率谬误是指“忽略某事在整体中发生的原本比例(基率),只凭单个案例的具体信息来判断概率”的错误。检查结果、目击证词、第一印象这类鲜活信息越强,我们就越容易跳过底下的数字。在医疗、司法、招聘、安防等概率判断至关重要的地方,这一错误的代价也更大。
本文将依次说明基率谬误的含义与研究起点、著名出租车问题背后的计算原理、日常中的例子,以及减少错误的方法与局限。
证据之前先要问的数字:基率
什么是基率谬误?
基率(Base Rate)是在得知特定信息之前,整体群体中业已存在的比例。统计学上也称之为先验概率:新证据到来时,正确的顺序是以这一先验为起点,再修正判断。
系统揭示这一错误的,是心理学家丹尼尔·卡尼曼(Daniel Kahneman)与阿莫斯·特沃斯基(Amos Tversky)。两人在1973年的论文中指出,人们判断概率时往往以“有多像某个典型”为标准,这就是代表性启发式(Representativeness Heuristic)。
在著名实验中,研究者向被试展示从100名工程师与律师中抽出的一份人物描述。一组被告知工程师有70人,另一组为30人;但读到对方喜欢数学谜题和木工后,两组给出的答案几乎相同。描述一旦“看起来像工程师”,70人与30人的差别便从判断中消失了。
用出租车问题看基率的力量
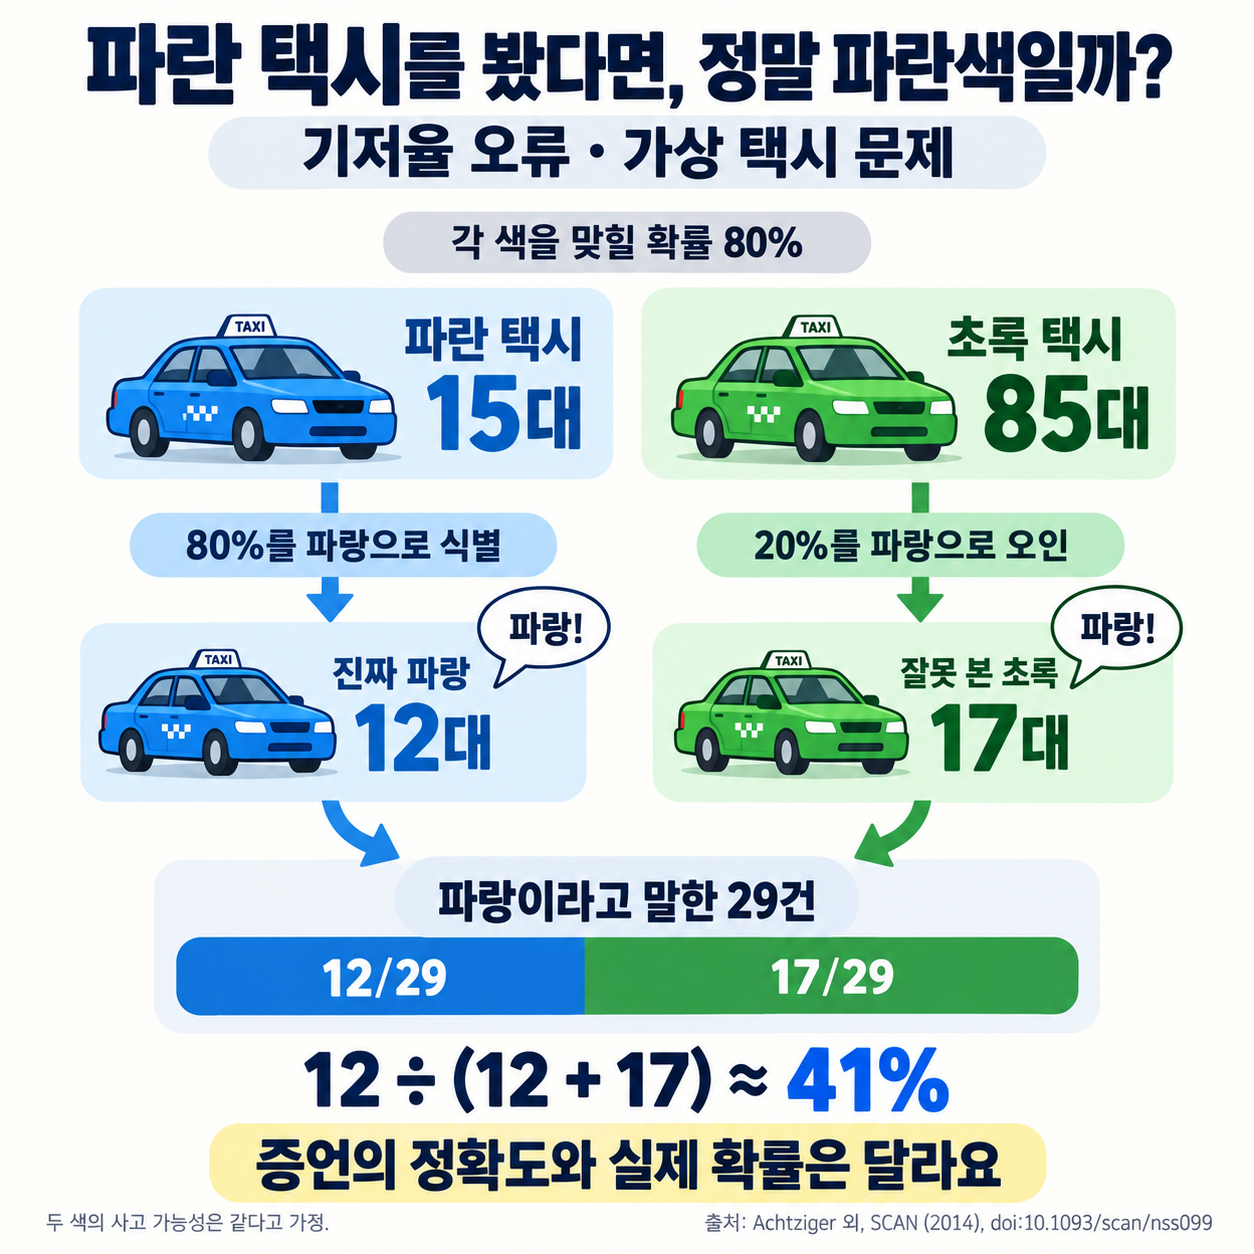
卡尼曼与特沃斯基提出的出租车问题,是解释基率谬误时最常用的例子。某城夜里发生肇事逃逸,该城出租车中85%属绿色公司、15%属蓝色公司。目击者称看到的是蓝色出租车;在相同条件下测试,目击者辨色准确率为80%。
人们最常给出的答案是“蓝色出租车的概率为80%”。但若把基率一并纳入,结果就会不同。
(1)正确认出真正的蓝色出租车
100辆出租车中有15辆蓝色;目击者以80%准确率认出,约有12辆被正确指认为“蓝色”。
(2)误认绿色出租车
85辆绿色出租车中,20%即约17辆也会被错误指认为“蓝色”。
(3)最终概率
在29次“蓝色”指认中,真正蓝色的只有12次,因此实际概率约为41%。即便有证词,绿色出租车的可能性仍更大。
特沃斯基与卡尼曼解释说,这是因为85比15的基率差距比目击者的可靠度更极端。证据再看似有理,若抽掉作为起点的比例,计算从一开始就会偏。
隐藏在日常中的基率谬误
基率谬误不只存在于计算题里,反而更常出现在做出重要决定的现实中。
- 罕见病筛查(Medical Screening):1978年美国哈佛医学院的研究中,在患病率1/1000、假阳性率5%的条件下询问阳性结果的含义,最常见的回答是95%。假设敏感度(患者中检测呈阳性的比例)为100%,阳性结果中真正患病的比例为0.001 ÷ (0.001 + 0.05 × 0.999) ≈ 1.96%。若未给出敏感度,就无法确定精确数值;在这些条件下,约2%是上限。
- 人才招聘(Hiring):若真正出众的人才在100名申请者中只有1人,面试中“看起来很厉害”的申请者,不少其实可能只是普通人。
- 安全警报(Security Alert):在攻击罕见的系统里,即便探测器很准,响起的警报也容易大部分是误报。
共同点是:要找的对象很稀少。在敏感度和假阳性率不变的情况下,对象越稀少,阳性结果中真正符合条件的比例通常越低。但假阳性不一定比真阳性多,具体取决于基率、敏感度和假阳性率。因此,必须结合基率与检测性能来判断。
减少基率谬误的方法及其局限
避开基率谬误的关键,是在看证据之前先养成问“这件事本来有多常见”的习惯,再把证据的准确度加到那个数字上调整判断。这正是贝叶斯定理(Bayes’ Theorem)所描述的思维方式。
(1)先核对基率
下结论之前,先查类似情况在整体中有多常见。
(2)改用自然频数
比起“80%”这类概率,“100辆中有12辆”这样的人数或个数更直观。心理学家格尔德·吉仁泽(Gerd Gigerenzer)的研究表明,这样呈现时正确率会大幅提高。
(3)分清颠倒的概率
要意识到:“是蓝色出租车时说成蓝色的概率”与“说成蓝色时真是蓝色出租车的概率”是不同的值。
不过基率也不是万能的。使用过时或统计有误的基率,反而会把判断带偏。把群体平均机械套到个人身上,也可能变成合理化刻板印象与歧视的工具。基率只是判断的起点,不该成为预先给个人贴上标签的烙印。
当鲜活的证据盖过安静的数字时,基率谬误便会出现。自卡尼曼与特沃斯基的实验以来,这一概念已成为医疗诊断、司法、招聘与安防等一切需要概率判断之处的重要标准。
面对惊人证据时,再问一次这件事本来有多常见——这便是不被数字迷惑、迈向理性判断的第一步。