Tại bệnh viện, phương pháp điều trị A được đánh giá là tốt hơn B khi xét toàn bộ bệnh nhân, nhưng khi chia thành nhóm bệnh nhẹ và bệnh nặng thì B lại tốt hơn ở cả hai nhóm, bạn sẽ chọn phương pháp nào? Hiện tượng kỳ lạ khi các con số đảo chiều lúc được “gộp lại” này xuất hiện nhiều lần trong quá trình diễn giải dữ liệu. Đó chính là “nghịch lý Simpson (Simpson’s Paradox)”.
Nói một cách đơn giản, nghịch lý Simpson là “hiện tượng khi xem xét riêng từng nhóm, ta thấy một mối quan hệ theo hướng nhất định, nhưng khi gộp các nhóm ấy lại, mối quan hệ trở nên yếu đi hoặc thậm chí đảo sang hướng ngược lại”. Edward H. Simpson đã hệ thống hóa hiện tượng này vào năm 1951; trước đó, Karl Pearson vào năm 1899 và Udny Yule vào năm 1903 cũng từng đề cập đến những trường hợp tương tự.
Tài liệu này trình bày một cách dễ hiểu từ định nghĩa và cơ chế phát sinh nghịch lý Simpson đến những trường hợp thực tế tiêu biểu, cùng các điểm cần kiểm tra để tránh rơi vào cái bẫy này khi đọc dữ liệu.
Cấu trúc của nghịch lý Simpson và nguyên tắc diễn giải
Nghịch lý Simpson là gì?
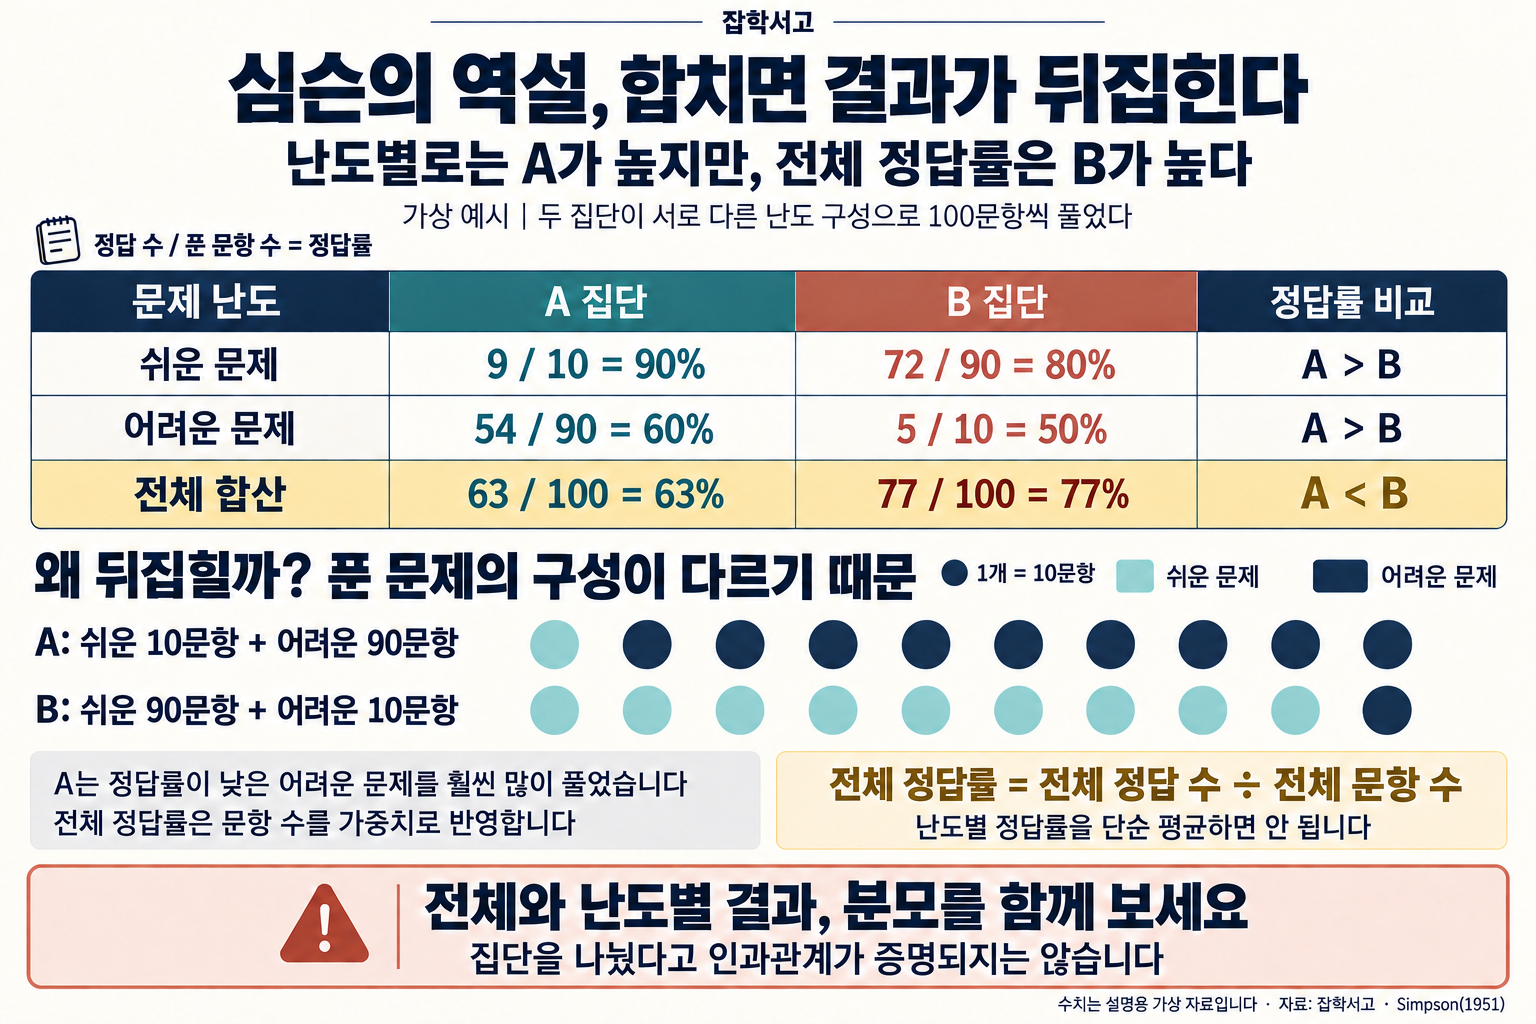
Nghịch lý Simpson không đơn thuần là một lỗi tính toán. Hiện tượng này xảy ra khi “tổng các phần” và “toàn thể” không khớp nhau, chẳng hạn A có tỷ lệ thành công cao hơn B trong từng nhóm, nhưng khi gộp tất cả lại, B lại có tỷ lệ thành công cao hơn. Theo trực giác, ta dễ cảm thấy rằng “nếu thắng ở từng phần thì cũng phải thắng khi xét toàn bộ”, nhưng trực giác ấy có thể bị phá vỡ ngay khi các tỷ lệ được gộp lại.
Vì sao điều này xảy ra? Điểm mấu chốt là quy mô và cơ cấu mẫu khác nhau giữa các nhóm. Chẳng hạn, nếu phương pháp điều trị A được dùng nhiều cho bệnh nhân nặng, còn phương pháp B được dùng nhiều cho bệnh nhân nhẹ, tỷ lệ thành công chung của A sẽ bị kéo xuống bởi tỷ trọng bệnh nhân nặng, còn của B được kéo lên bởi tỷ trọng bệnh nhân nhẹ. Kết quả là A thắng trong từng nhóm, nhưng B lại thắng khi gộp chung.
- Xu hướng trong nhóm (Within-group trend): Chiều hướng của mối quan hệ quan sát được trong từng nhóm con.
- Xu hướng tổng hợp (Aggregate trend): Chiều hướng của mối quan hệ quan sát được sau khi gộp các nhóm con.
- Nghịch lý (Paradox): Trạng thái hai chiều hướng không khớp nhau hoặc đối lập nhau.
Vì sao các con số đảo chiều: Vai trò của biến gây nhiễu
Trong thống kê học, người ta cho rằng phía sau hiện tượng này có “biến gây nhiễu (Confounding Variable)” hoặc “biến ẩn (Lurking Variable)”. Đây là trường hợp một biến thứ 3 đồng thời tác động làm thay đổi mối quan hệ giữa hai biến đang được quan tâm.
(1) Sự mất cân đối về quy mô nhóm
Khi mẫu tập trung vào một nhóm, kết quả của nhóm đó sẽ được phản ánh quá mức trong kết quả chung. Dù nhóm nhỏ có một hiệu ứng rõ rệt, hiệu ứng ngược chiều ở nhóm lớn vẫn có thể chi phối kết quả tổng hợp.
(2) Can thiệp và điều kiện cùng thay đổi
Nếu phương pháp điều trị không được phân bổ ngẫu nhiên cho những bệnh nhân khó và dễ điều trị, “hiệu quả của phương pháp điều trị” sẽ bị trộn lẫn với “tình trạng bệnh nhân”. Khi đó, chỉ nhìn vào bảng tổng hợp rất dễ khiến ta hiểu nhầm rằng bản thân phương pháp điều trị là tốt hay kém.
(3) Trung bình có trọng số của các tỷ lệ
Tỷ lệ thành công không phải là trung bình cộng mà là trung bình có trọng số theo số người. Nếu trọng số khác nhau giữa các nhóm, bên thắng và bên thua trong từng nhóm có thể khác với bên thắng và bên thua khi xét tổng thể.
Nói một cách dễ hiểu, nghịch lý Simpson là tín hiệu cảnh báo rằng “việc chia dữ liệu theo những tầng nào” có thể làm thay đổi kết luận.
Tìm hiểu nghịch lý Simpson qua những ví dụ đơn giản
Một trong những ví dụ thường được trích dẫn nhất là so sánh các phương pháp điều trị sỏi thận. Khi chỉ xét tổng thể, điều trị bằng phẫu thuật hoặc điều trị không phẫu thuật có vẻ chiếm ưu thế, nhưng đã có báo cáo về mô hình trong đó bên chiếm ưu thế đảo ngược khi chia thành trường hợp sỏi nhỏ và sỏi lớn. Nếu bỏ qua câu hỏi “đối với ai, trong điều kiện nào”, bảng kết quả điều trị sẽ bị bóp méo.
Tỷ lệ đánh trúng bóng trong bóng chày cũng được giải thích bằng cấu trúc tương tự. Có trường hợp cầu thủ A có tỷ lệ đánh trúng bóng cao hơn cầu thủ B trong cả nửa đầu lẫn nửa sau mùa giải, nhưng khi gộp cả mùa, B lại có tỷ lệ cao hơn. Nguyên nhân là số hiệp thi đấu và số lượt lên đánh khác nhau rất lớn giữa các giai đoạn. Điều đó có nghĩa là “người thắng theo từng giai đoạn” và “người thắng cả mùa” có thể khác nhau, qua đó cho thấy rõ ảo giác nảy sinh khi chỉ đọc bảng thành tích qua một dòng duy nhất.
Lập luận tương tự cũng được sử dụng trong các cuộc tranh luận về tỷ lệ trúng tuyển đại học. Có trường hợp chênh lệch giới tính có vẻ lớn khi chỉ nhìn vào tỷ lệ trúng tuyển chung, nhưng lại biến mất hoặc thu hẹp khi chia theo từng khoa. Khi đó, điều cốt yếu không phải là lập tức kết luận “không có phân biệt đối xử”, mà là đặt câu hỏi tầng nào, như khoa, quy mô ứng tuyển hay tỷ lệ cạnh tranh, đã chi phối kết quả chung.
[Điểm cần chú ý từ các ví dụ]
- Đừng chỉ tin vào bảng tổng hợp; hãy chia lại dữ liệu thành các nhóm con có ý nghĩa.
- Ghi kèm quy mô của các nhóm con, tức trọng số của chúng.
- Giải thích riêng “vì sao nhiều người lại tập trung vào nhóm đó”.
4 thói quen giúp tránh bẫy khi đọc dữ liệu
Không có công thức nào hoàn toàn “loại bỏ” được nghịch lý Simpson. Tuy nhiên, thay đổi thói quen diễn giải có thể làm giảm đáng kể khả năng rơi vào bẫy.
(1) Xác định các tầng trước tiên
Ghi trước những biến có thể ảnh hưởng đến kết quả như giới tính, độ tuổi, mức độ bệnh nặng, khu vực và nhóm sản phẩm, rồi đặt bảng tổng hợp cạnh bảng phân theo tầng để xem xét.
(2) Xem cả tỷ lệ lẫn số người
Ngay cả tỷ lệ thành công 80% cũng mang ý nghĩa khác nếu mẫu chỉ có 5 người. Hãy hoài nghi những biểu đồ che giấu mẫu số, tức số lần thử hoặc số người.
(3) Phân biệt quan hệ nhân quả và tương quan
Đừng vội khẳng định “nguyên nhân” chỉ vì kết quả tổng hợp bị đảo chiều. Trước hết, hãy kiểm tra xem có thiết kế thí nghiệm hoặc phân bổ ngẫu nhiên hay không.
(4) Nêu rõ đơn vị áp dụng của kết luận
Nêu rõ trong câu rằng kết luận “dựa trên toàn bộ bệnh nhân” hay “dựa trên bệnh nhân nặng”. Với cùng một dữ liệu, khuyến nghị có thể thay đổi khi nhóm tham chiếu thay đổi.
Nghịch lý Simpson có thể xuất hiện ở bất cứ nơi nào có tỷ lệ, từ thăm dò dư luận trên bản tin, bảng kết quả của bệnh viện, thử nghiệm A/B của ứng dụng đến thống kê tuyển sinh của trường học. Càng thuận tiện khi dùng số liệu tổng hợp, ta càng cần có thái độ sẵn sàng chia nhỏ dữ liệu thêm một lần nữa. Đồ họa thông tin càng bắt mắt thì càng hay che khuất mẫu số và các tầng, vì vậy thói quen kiểm tra trước “đơn vị của con số này là gì” sẽ hữu ích.
Không dừng lại ở con số tổng hợp mà đặt câu hỏi “những tầng nào đã tạo nên con số này” chính là bước đầu tiên của tư duy thống kê.