Si cada vez que escribieras una dirección en la barra del navegador, este descargara la lista de sitios peligrosos de toda Internet para comprobar si el sitio figura en ella, el proceso sería demasiado lento y pesado. Almacenar los millones de direcciones en el dispositivo también supondría una carga. En estos casos se utiliza una herramienta que, con muy poca memoria, permite determinar rápidamente que una dirección está con certeza fuera de la lista.
Esta herramienta se llama filtro de Bloom (Bloom Filter). Es una estructura de datos probabilística que permite comprobar con muy poco espacio si un valor pertenece a un conjunto. Burton Howard Bloom la propuso en 1970. Tiene una garantía particular: la respuesta «no está» siempre es correcta, mientras que «sí está» puede ser incorrecta en ocasiones.
Veremos qué problema dio origen al filtro de Bloom, cómo se insertan y se consultan los valores, cómo se controla la probabilidad de error y cuáles son sus aplicaciones y limitaciones en servicios reales.
Cómo detectar ausencias con un pequeño arreglo de bits
Sacrificar algo de precisión para ahorrar memoria
Bloom puso como ejemplo el problema de dividir con guiones 50 decenas de miles de palabras de un diccionario. El 90 % de las palabras se podía dividir con reglas sencillas, pero para el 10 % restante había que leer patrones específicos del disco. Recordar con exactitud qué palabras eran excepciones requería mucha memoria.
(1) El costo de una tabla hash exacta
Crear una tabla que recuerde las palabras excepcionales con total precisión exige una cantidad de memoria acorde.
(2) La idea de admitir errores
Si se acepta que de vez en cuando haya una consulta innecesaria al disco, basta con una tabla mucho más pequeña.
(3) Efecto
Según el artículo de Bloom, con solo el 18 % del tamaño de la tabla ideal se puede eliminar el 87 % de los accesos innecesarios al disco.
Lo esencial es que el error solo se admite en un sentido. Todas las consultas necesarias se realizan y el único error posible es que se haga alguna consulta innecesaria, de modo que el resultado siempre es seguro. Más que dar la respuesta exacta, el filtro de Bloom actúa como un guardián que comprueba primero si se puede omitir una verificación costosa.
Cómo funcionan el arreglo de bits y las funciones hash
El filtro de Bloom consta de un arreglo largo de bits, inicialmente lleno de 0, y k funciones hash que devuelven valores distintos entre sí.
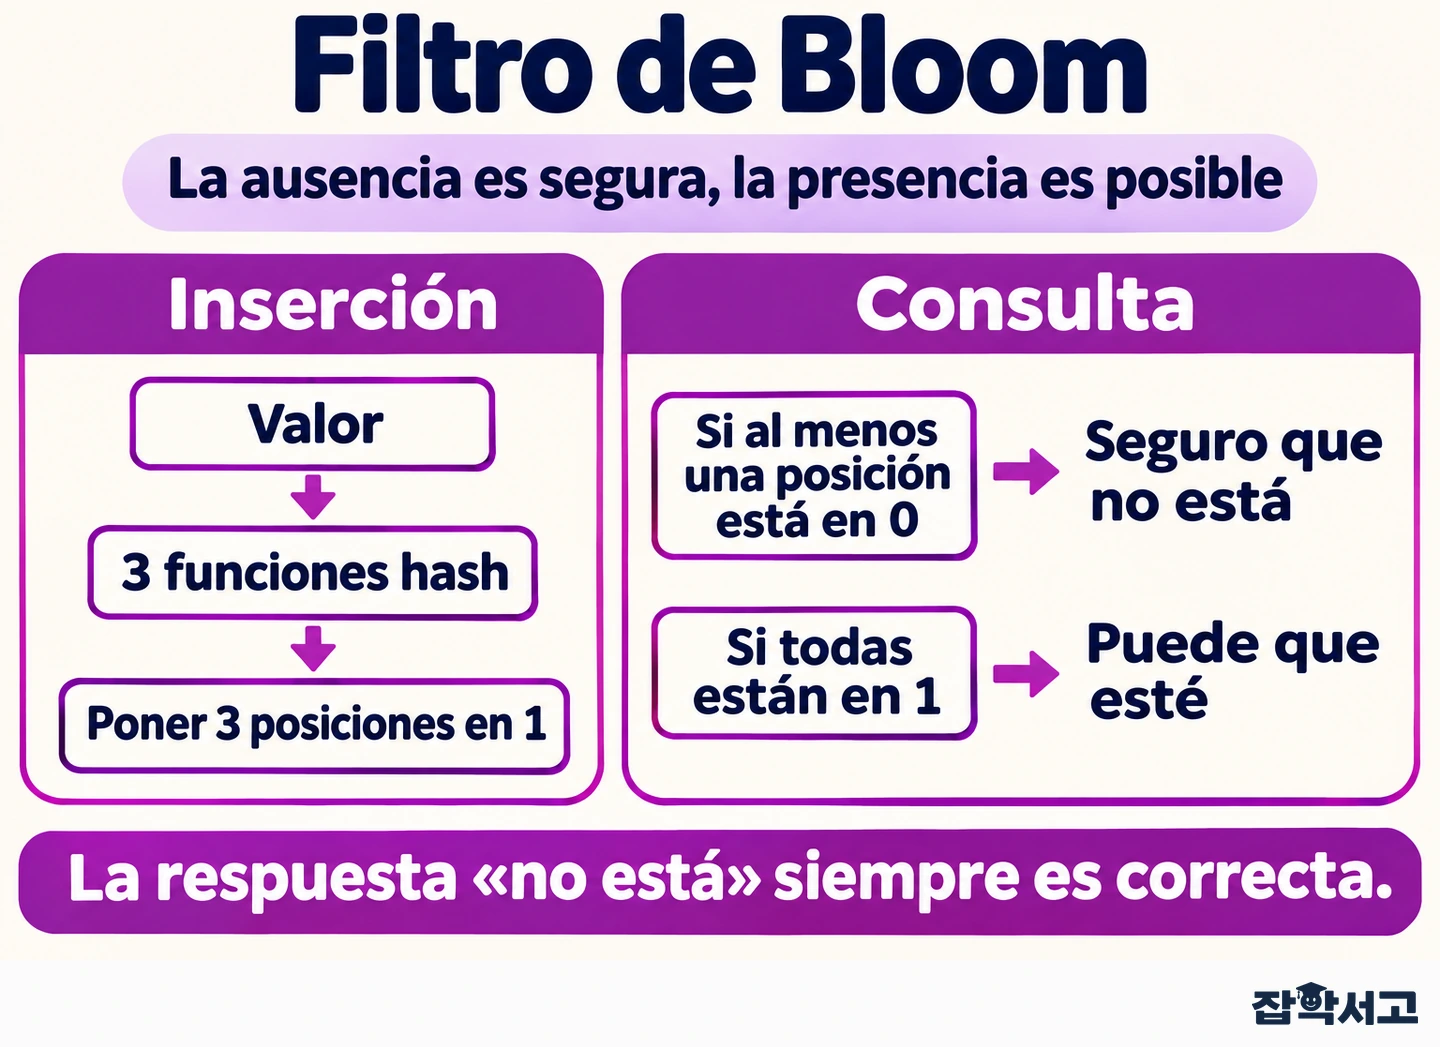
- Insertar (Add) consiste en aplicar al valor las k funciones hash y poner en 1 las k posiciones resultantes.
- Consultar (Query) consiste en calcular las k posiciones del mismo modo. Si al menos una contiene un 0, la respuesta es «seguro que no está».
- Si todas las posiciones contienen un 1 (Possibly in Set), el valor podría estar realmente en el conjunto o podría ocurrir que otros valores hayan ocupado esas posiciones por casualidad. Por eso, la única respuesta es «puede que esté».
- El tiempo de cálculo (Time) de una consulta se limita a k cálculos y es el mismo con independencia de cuántos valores se hayan insertado.
Esta estructura prescinde de almacenar los valores en sí. Por eso, ocupan el mismo espacio sean largos o cortos, insertar varias veces el mismo valor deja el arreglo tal como estaba y resulta imposible reconstruir qué valores se habían insertado.
Como ejemplo sencillo, imaginemos un filtro con 18 posiciones de bits y 3 funciones hash. Si insertamos tres valores, como máximo 9 posiciones quedarán en 1. Si al menos una de las tres posiciones que señala un nuevo valor contiene un 0, tenemos la certeza de que ese valor nunca se insertó. También se pueden combinar dos filtros del mismo tamaño que utilicen las mismas funciones hash mediante una operación de unión bit a bit.
Cómo controlar la probabilidad de error
Cuantos más valores se insertan, más frecuentes son las respuestas incorrectas de «sí está», llamadas falsos positivos (False Positive). A medida que más bits pasan a 1, aumenta la probabilidad de que por casualidad todas las posiciones consultadas contengan un 1. Por pequeño que sea el arreglo, siempre se puede insertar un valor. Si se siguen insertando valores indefinidamente, todas las posiciones acabarán en 1 y el filtro responderá «puede que esté» a cualquier consulta.
(1) Tamaño del arreglo
Cuanto mayor sea el arreglo, menor será la probabilidad de falsos positivos. La regla básica es dimensionarlo en proporción al número de valores que se van a insertar.
(2) Número de funciones hash
Con muy pocas funciones se pierde capacidad de distinción y con demasiadas las posiciones se llenan rápidamente. En teoría, el número óptimo se aproxima al cociente entre el tamaño del arreglo y el número de valores, multiplicado por el logaritmo natural de 2.
(3) Cuánto espacio se necesita
Para limitar la probabilidad de falsos positivos al 1 %, bastan unos 9.6 bits por valor. Si se añaden unos 4.8 bits, la probabilidad se reduce a la décima parte. Estas cifras son independientes del tamaño de los valores.
(4) Ausencia de falsos negativos
Mientras se conserven los bits del arreglo después de insertar un valor, el filtro nunca indicará que ese valor está ausente.
Aplicaciones y limitaciones en servicios reales
Bases de datos como Google Bigtable, Apache HBase y Apache Cassandra usan filtros de Bloom para reducir las lecturas de disco al buscar filas inexistentes. Akamai, una empresa de distribución de contenidos, comprobó que los objetos web solicitados una sola vez representaban casi 3/4 de los objetos candidatos a entrar en la caché y utilizó este filtro para almacenarlos a partir de la segunda solicitud. Durante un tiempo, Google Chrome también usó este filtro para examinar primero las direcciones en busca de posibles coincidencias con direcciones maliciosas y solo verificaba a fondo las que el filtro señalaba.
- Imposibilidad de eliminación (No Deletion). La versión básica impide retirar valores, porque una posición puede corresponder a varios valores y borrarla podría hacer que también desaparecieran otros.
- Filtro de Bloom con contadores (Counting Bloom Filter). Sustituye el 1 bit de cada posición por un número pequeño para permitir la eliminación, pero requiere entre 3 y 4 veces más espacio.
- Filtro de cuco (Cuckoo Filter). Es una alternativa que guarda una huella corta de cada valor y permite eliminarlo.
- Saturación (Saturation). Si se insertan demasiados valores, aumentan los falsos positivos y, con el tiempo, hay que crear un filtro nuevo.
En su día, las carteras de Bitcoin usaron este filtro para acelerar la sincronización y se descubrió que podía exponer información privada. Ese caso muestra que también hace falta criterio para decidir dónde conviene usarlo. Cuando no se necesita una respuesta perfecta, basta con detectar rápidamente los casos de «seguro que no está» para ahorrarse la mayor parte del trabajo. El primer paso para usar un filtro de Bloom es renunciar a recordarlo todo con exactitud y decidir de antemano cuánto error se puede tolerar.