假设我们要比较两个班级的考试成绩。如果平均分相同,分数的分散程度相同,连表示学习时间与成绩关系的数字也一模一样,那么能说这两个班实际上是同一个班吗?大多数人会回答“能”。然而,把这些数字画成图,却可能呈现出完全不同的形状。仅用四组数据就揭示了这一事实的,正是“安斯库姆四重奏(Anscombe’s Quartet)”。
简单来说,安斯库姆四重奏是指“平均值、方差、相关系数、回归线等摘要统计量几乎完全相同,但画成图后样子截然不同的四组数据”。四重奏是音乐中指四个人一起演奏的用语,因为这四组数据作为一套整体出现,所以得了这个名字。
本文将依次介绍安斯库姆四重奏诞生的背景、四张图各自揭示的陷阱、随后出现的恐龙形状数据,以及正确解读数据的方法。
看清数字背后隐藏的形状
什么是安斯库姆四重奏?

这组数据最早由英国出生的统计学家弗朗西斯·安斯库姆(Francis Anscombe)于1973年发表在学术期刊《美国统计学家》(The American Statistician)上的论文《统计分析中的图形》(Graphs in Statistical Analysis)中提出。当时统计学家之间普遍存在“计算是精确的,图形只是粗略看看”的观念,安斯库姆想要颠覆这种想法。
(1) 相同的摘要统计量
四组数据都由11个点组成,以下数值几乎相同。
- x的平均值(Mean of x):四组都恰好是9。
- x的方差(Variance of x):四组都恰好是11。
- y的平均值(Mean of y):精确到小数点后两位,同为7.50。
- 相关系数(Correlation Coefficient):精确到小数点后三位,同为0.816。
- 回归线(Regression Line):都是y = 3.00 + 0.500x。
(2) 安斯库姆想说的话
只看数字,四组数据就像双胞胎一样。但安斯库姆想要说明的是:如果不画图就先计算,就会错过数据的真实面貌。
四张图揭示的陷阱
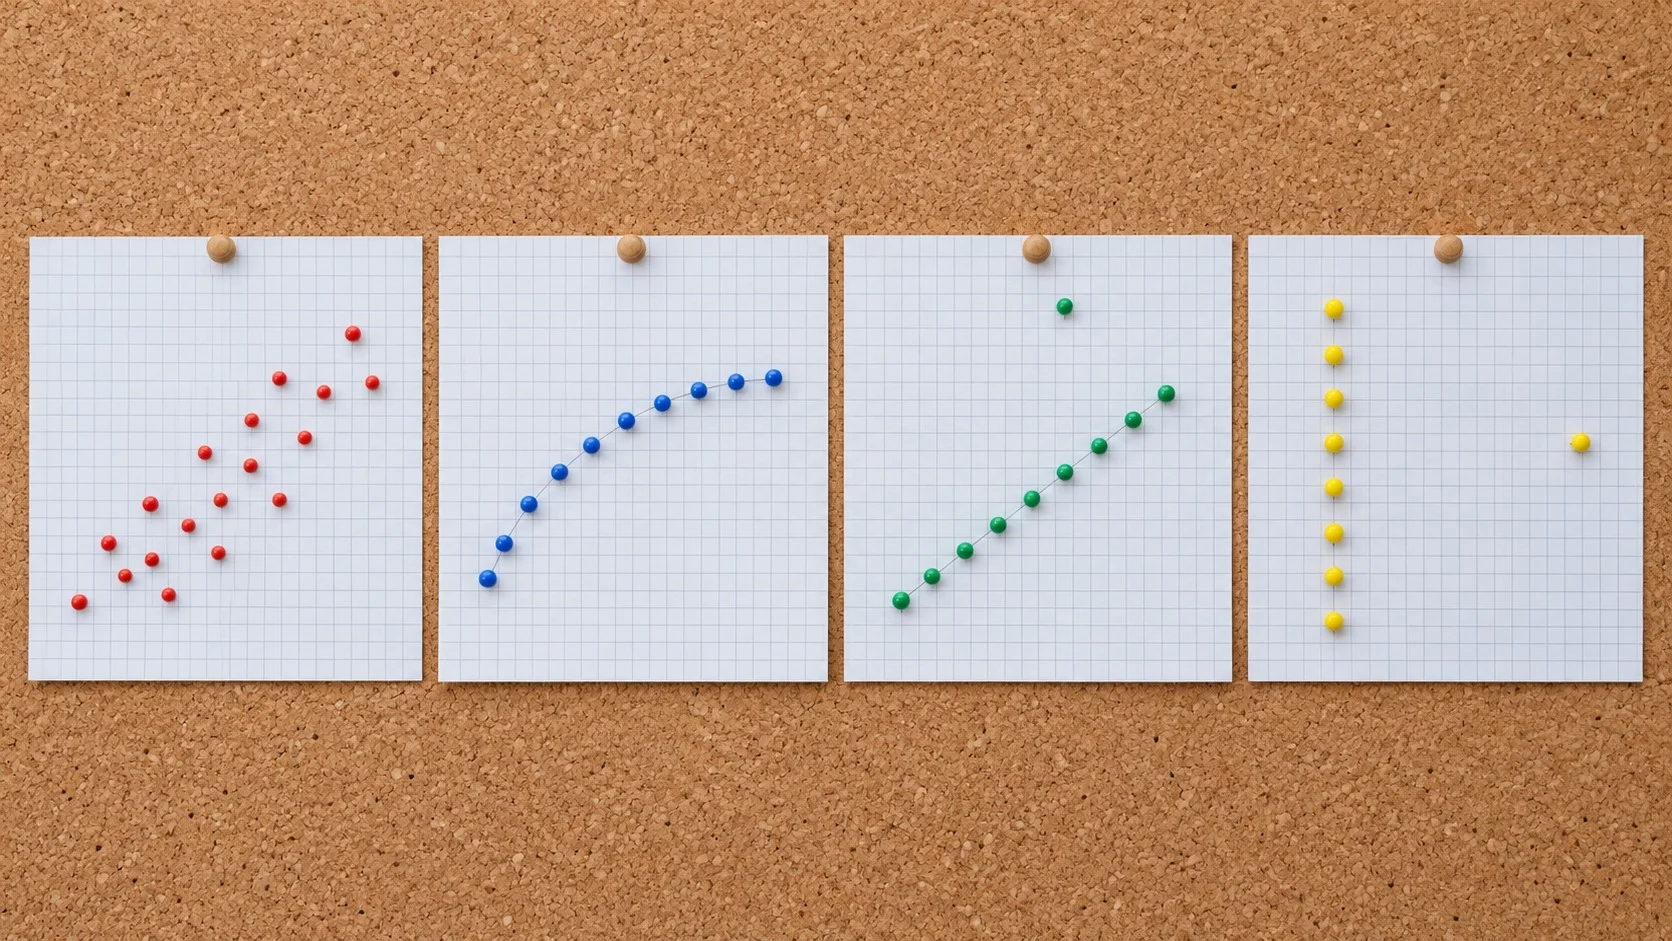
把四组数据画成散点图,数字所掩盖的差异便一目了然。
(1) 第一组
点向右上方斜向散布。看起来是直线关系中掺杂了少许误差,这是摘要统计量能比较好地描述数据的唯一情况。
(2) 第二组
点构成一条平滑的曲线。两个变量之间存在明确的关系,但因为不是直线,以直线为前提的相关系数和回归线无法正确反映这种关系。
(3) 第三组
10个点几乎完美地落在一条直线上,只有一个点高高地偏离在上方。这一个异常值(Outlier)把回归线拉向自己,并把原本接近1的相关系数拉低到0.816。
(4) 第四组
10个点全部聚集在x = 8的竖线上,只有一个点孤零零地落在x = 19处。其余的点根本无法说明任何关系,但这一个孤立的点却造出了很高的相关系数。
延续到恐龙的实验
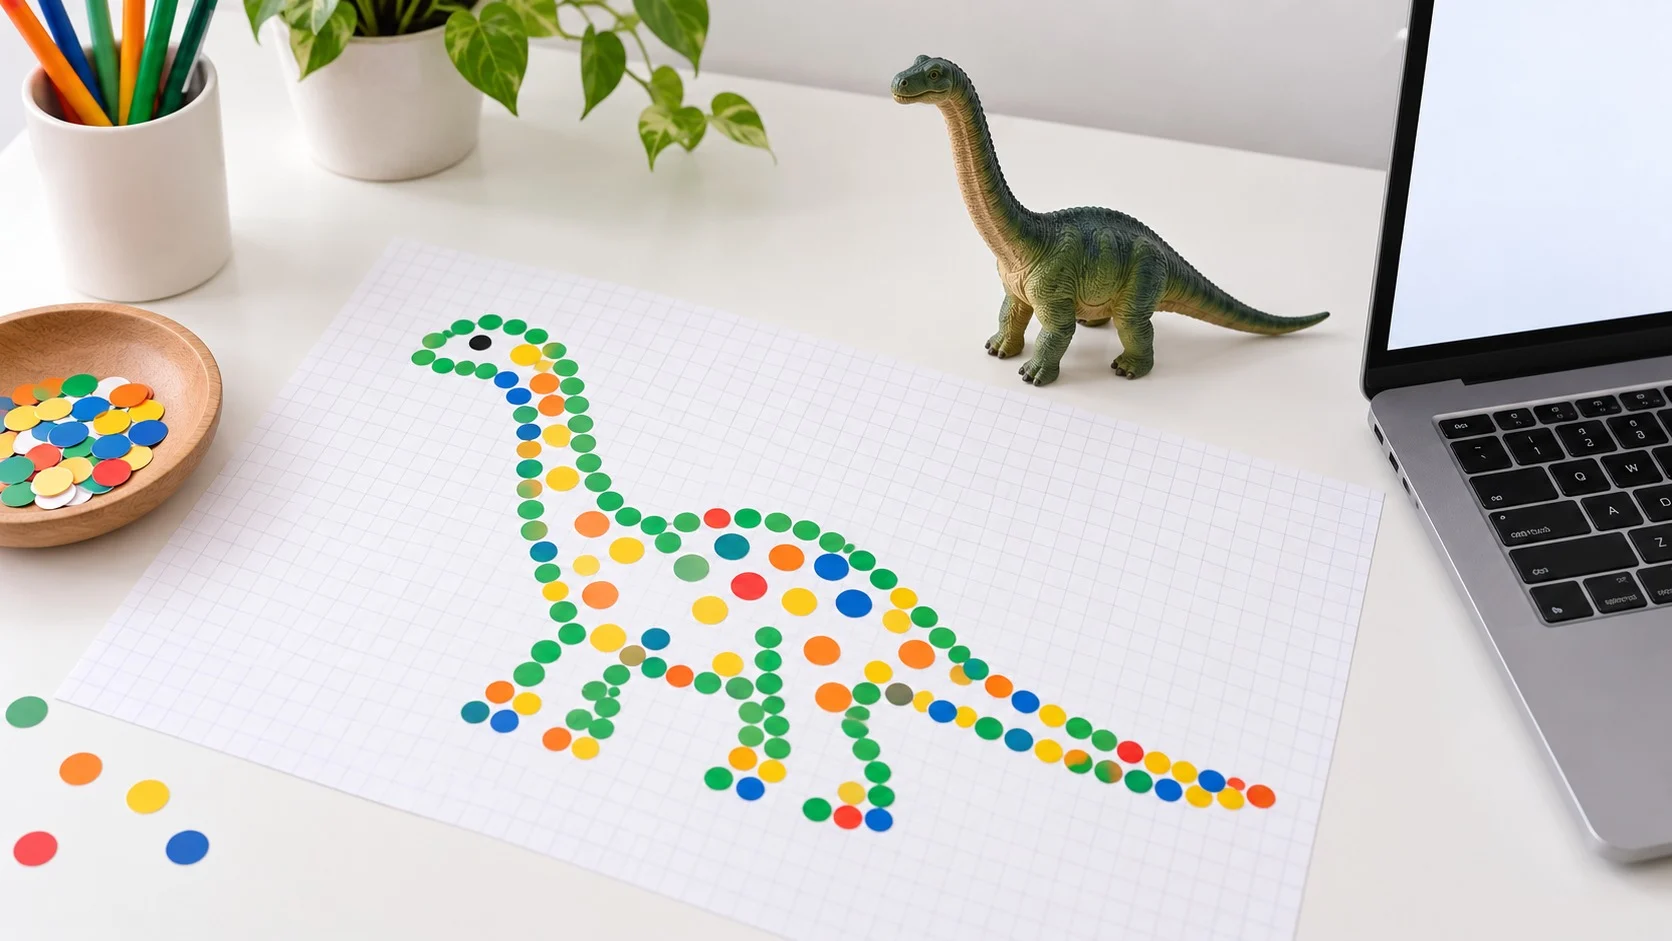
安斯库姆是如何构造出这些数字的,至今不得而知。后来,研究者们开始寻找方法,刻意制造摘要统计量相同而形状不同的数据。
[案例1] 数据龙(Datasaurus)
2016年,数据可视化研究者阿尔贝托·开罗(Alberto Cairo)制作了一组用点画出恐龙图案的数据,并称之为“数据龙(Datasaurus)”。这是一个机智的警告:平平无奇的摘要统计量背后,也可能藏着一只恐龙。
[案例2] 数据龙一打(Datasaurus Dozen)
2017年,欧特克研究院(Autodesk Research)的贾斯汀·马泰伊卡(Justin Matejka)和乔治·菲茨莫里斯(George Fitzmaurice)以这组恐龙数据为基础,提出了一种一点点移动数据点、同时让摘要统计量保持到小数点后两位不变的方法。结果诞生了“数据龙一打(Datasaurus Dozen)”:恐龙、星星、同心圆、条纹等13幅各不相同的图形,拥有相同的统计量。
正确解读数据的方法
安斯库姆四重奏至今仍常常出现在统计学和数据分析课程的第一堂课上,也被收录在爱德华·塔夫特(Edward Tufte)的著作《定量信息的视觉显示》(The Visual Display of Quantitative Information)中。这个案例留下的教训如下。
(1) 先画图再计算
开始分析之前,先用散点图或直方图确认数据的形状。是不是曲线关系、是否偏向一侧、有没有远离群体的点,只有看图才能知道。
(2) 单独审视突出的点
异常值和孤立点即使只有几个,也会大幅动摇结果。应先确认这个点是录入错误还是真正特殊的个案,再决定分析方法。
(3) 不要凭一个数字下结论
相关系数高,只说明点接近一条直线排列,并不能告诉我们关系的形状或原因。
安斯库姆四重奏表明,摘要统计量不过是压缩数据后投下的影子。正如多种不同的物体可以投下同样的影子,同样的数字背后也可能隐藏着截然不同的形状。
在相信数字之前,亲手把产生这些数字的数据画出来——这就是正确解读数据的统计思维的第一步。