Hãy tưởng tượng chúng ta đang so sánh điểm thi của hai lớp. Nếu điểm trung bình giống nhau, mức độ phân tán của điểm giống nhau, thậm chí con số thể hiện mối quan hệ giữa thời gian học và điểm số cũng giống hệt nhau, liệu có thể nói hai lớp về cơ bản là như nhau không? Phần lớn mọi người sẽ trả lời là có. Thế nhưng, khi biểu diễn những con số này trên đồ thị, các hình dạng hoàn toàn khác nhau có thể xuất hiện. “Bộ tứ Anscombe (Anscombe's Quartet)” đã cho thấy điều đó chỉ bằng bốn bộ dữ liệu.
Nói một cách đơn giản, Bộ tứ Anscombe là “bốn bộ dữ liệu có các thống kê tóm tắt như trung bình, phương sai, hệ số tương quan và đường hồi quy gần như giống hệt nhau, nhưng lại có hình dạng hoàn toàn khác nhau khi vẽ đồ thị”. Trong âm nhạc, quartet có nghĩa là tứ tấu, tức bốn người cùng biểu diễn; tên gọi này được đặt với ý nghĩa bốn bộ dữ liệu đi cùng nhau thành một bộ.
Trong bài này, chúng ta sẽ lần lượt tìm hiểu bối cảnh ra đời của Bộ tứ Anscombe, những cạm bẫy mà từng đồ thị trong bốn đồ thị cho thấy, bộ dữ liệu hình khủng long xuất hiện sau đó và cách đọc dữ liệu đúng đắn.
Cách nhìn ra hình dạng ẩn sau những con số
Bộ tứ Anscombe là gì?

Bộ dữ liệu này được nhà thống kê người Anh Francis Anscombe giới thiệu lần đầu trong bài báo “Đồ thị trong phân tích thống kê (Graphs in Statistical Analysis)”, đăng trên tạp chí “Nhà thống kê Hoa Kỳ (The American Statistician)” năm 1973. Khi ấy, trong giới thống kê tồn tại quan niệm rằng “tính toán thì chính xác, còn đồ thị chỉ để xem đại khái”, và Anscombe muốn đảo ngược suy nghĩ này.
(1) Các thống kê tóm tắt giống hệt nhau
Cả bốn bộ đều gồm 11 điểm và có các giá trị sau gần như giống nhau.
- Trung bình của x (Mean of x): Cả bốn bộ đều có giá trị chính xác là 9.
- Phương sai của x (Variance of x): Cả bốn bộ đều có giá trị chính xác là 11.
- Trung bình của y (Mean of y): Đều bằng 7.50 khi xét đến chữ số thứ hai sau dấu thập phân.
- Hệ số tương quan (Correlation Coefficient): Đều bằng 0.816 khi xét đến chữ số thứ ba sau dấu thập phân.
- Đường hồi quy (Regression Line): Tất cả đều giống nhau, là y = 3.00 + 0.500x.
(2) Thông điệp Anscombe muốn truyền tải
Nếu chỉ nhìn vào các con số, bốn bộ dữ liệu trông như những bản sao của nhau. Nhưng Anscombe muốn cho thấy rằng nếu bắt đầu tính toán mà không vẽ đồ thị, chúng ta sẽ bỏ lỡ diện mạo thực sự của dữ liệu.
Những cạm bẫy mà bốn đồ thị cho thấy
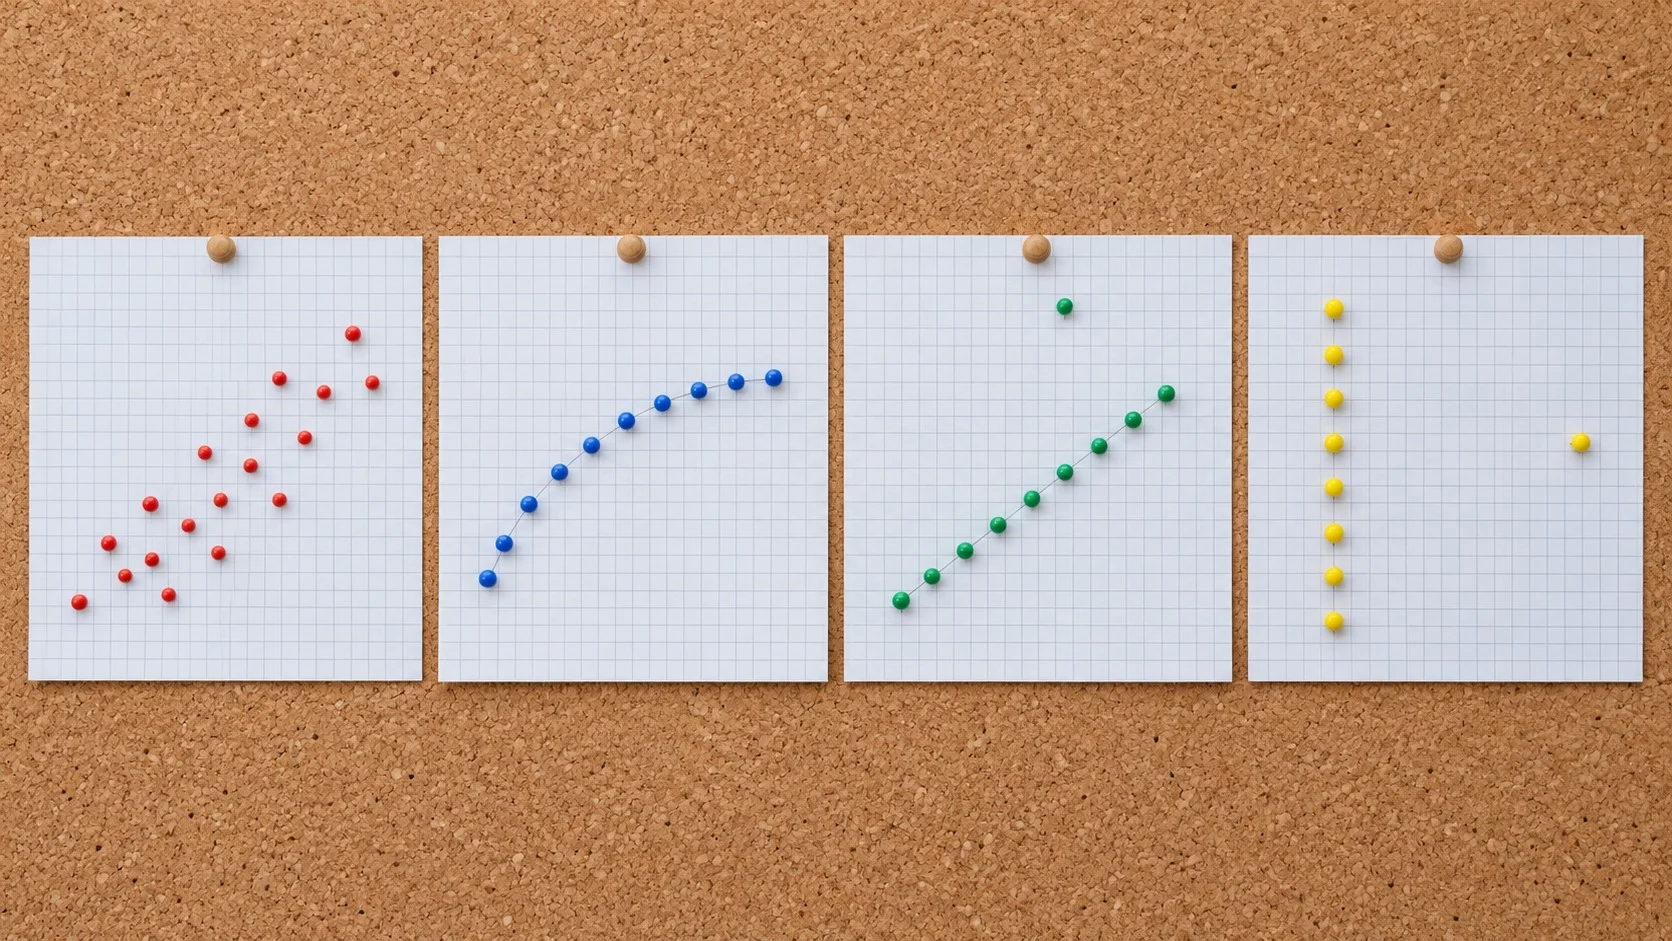
Khi biểu diễn bốn bộ dữ liệu bằng biểu đồ phân tán, những khác biệt bị các con số che khuất sẽ hiện ra ngay trước mắt.
(1) Bộ thứ nhất
Các điểm phân tán theo hướng xiên lên phía trên bên phải. Hình dạng này thể hiện một mối quan hệ tuyến tính có lẫn chút sai số, và đây là trường hợp duy nhất mà các thống kê tóm tắt mô tả dữ liệu tương đối tốt.
(2) Bộ thứ hai
Các điểm tạo thành một đường cong mượt. Giữa hai biến có mối quan hệ rõ ràng, nhưng đó không phải là quan hệ tuyến tính, nên hệ số tương quan và đường hồi quy dựa trên giả định về đường thẳng không thể phản ánh đúng mối quan hệ này.
(3) Bộ thứ ba
Có 10 điểm nằm gần như hoàn hảo trên một đường thẳng, nhưng một điểm lại lệch hẳn lên phía trên. Chỉ một điểm ngoại lai (Outlier) này đã kéo đường hồi quy về phía nó và làm hệ số tương quan vốn có thể gần 1 giảm xuống còn 0.816.
(4) Bộ thứ tư
Cả 10 điểm tập trung trên đường thẳng đứng x = 8, chỉ có một điểm nằm tách biệt tại x = 19. Dù các điểm còn lại không cho phép nói lên mối quan hệ nào, chỉ một điểm đơn độc này lại tạo ra hệ số tương quan cao.
Thí nghiệm tiếp nối với hình khủng long
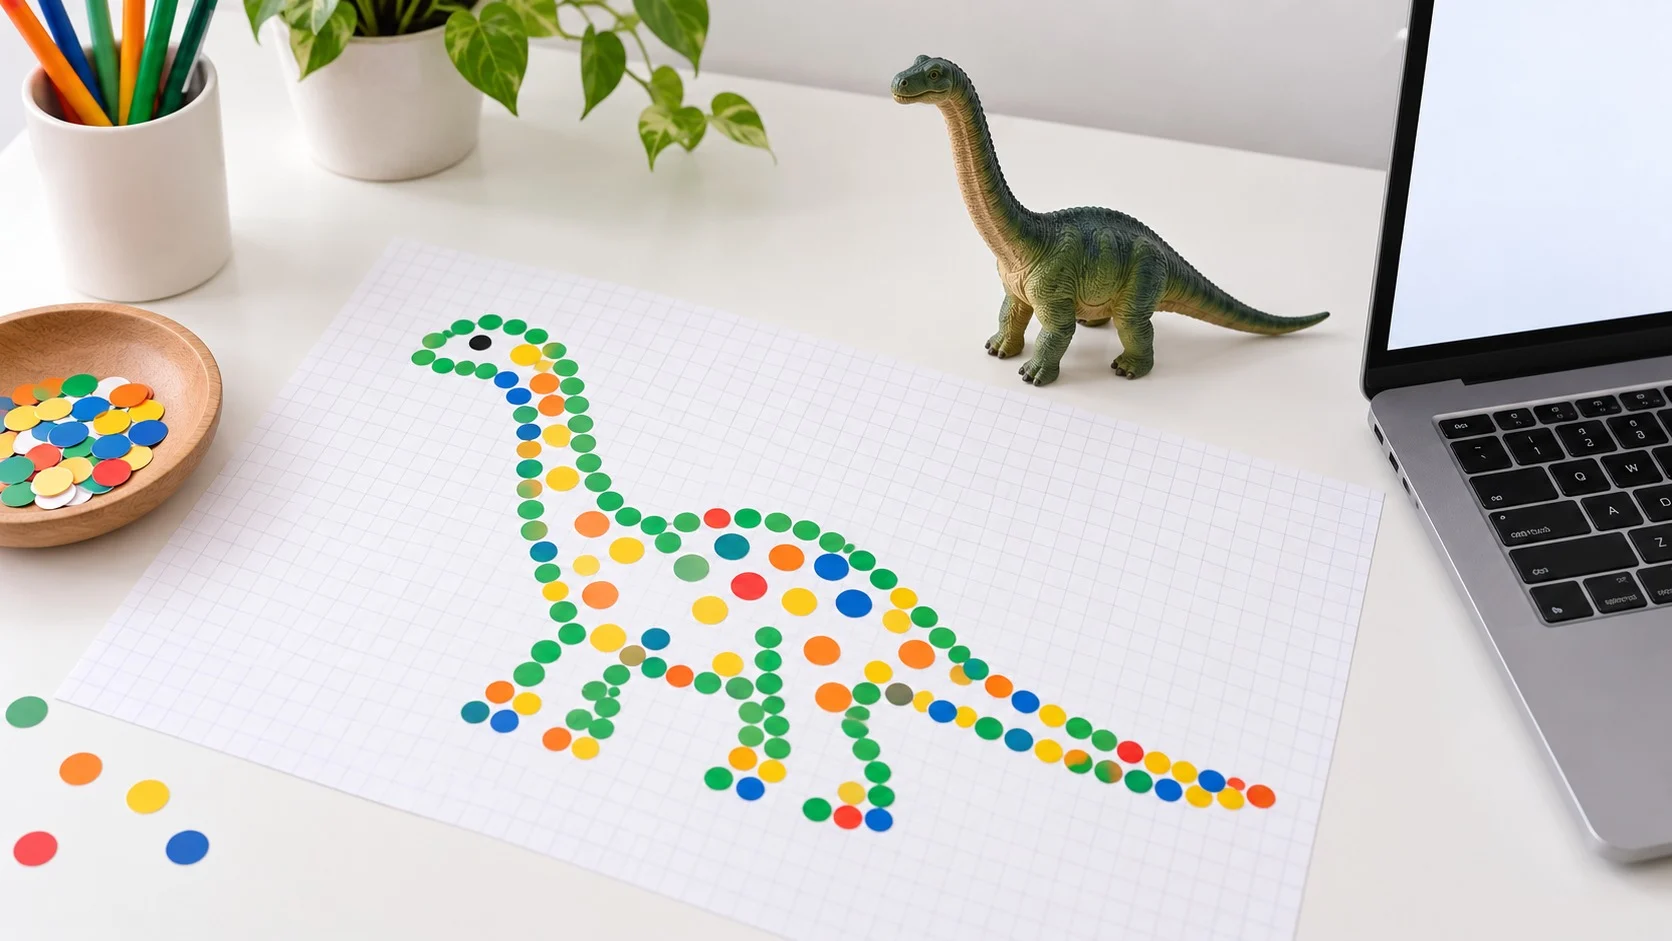
Không ai biết Anscombe đã tạo ra những con số này như thế nào. Sau đó, các nhà nghiên cứu bắt đầu tìm cách chủ động tạo ra những bộ dữ liệu có cùng thống kê tóm tắt nhưng khác hình dạng.
[Ví dụ 1] Datasaurus
Năm 2016, nhà nghiên cứu trực quan hóa dữ liệu Alberto Cairo đã tạo ra một bộ dữ liệu với các điểm hợp thành hình khủng long và gọi nó là “Datasaurus”. Đây là một lời cảnh báo dí dỏm rằng phía sau những thống kê tóm tắt bình thường cũng có thể ẩn giấu một con khủng long.
[Ví dụ 2] Datasaurus Dozen
Năm 2017, Justin Matejka và George Fitzmaurice tại phòng nghiên cứu Autodesk đã dựa trên bộ dữ liệu khủng long này để đưa ra phương pháp dịch chuyển các điểm từng chút một, đồng thời giữ nguyên các thống kê tóm tắt đến chữ số thứ hai sau dấu thập phân. Kết quả là “Datasaurus Dozen” ra đời, gồm 13 hình khác nhau như khủng long, ngôi sao, các đường tròn đồng tâm và các sọc, nhưng đều có cùng các thống kê.
Cách đọc dữ liệu đúng đắn
Ngày nay, Bộ tứ Anscombe vẫn thường xuất hiện trong buổi học đầu tiên của các lớp thống kê và phân tích dữ liệu, đồng thời cũng được giới thiệu trong cuốn “Trình bày trực quan thông tin định lượng (The Visual Display of Quantitative Information)” của Edward Tufte. Những bài học mà ví dụ này để lại như sau.
(1) Vẽ trước khi tính toán
Trước khi bắt đầu phân tích, hãy kiểm tra hình dạng dữ liệu bằng biểu đồ phân tán hoặc biểu đồ tần suất. Chỉ khi nhìn vào hình vẽ, chúng ta mới biết mối quan hệ có dạng đường cong hay không, dữ liệu có dồn về một phía hay có điểm nào nằm tách khỏi nhóm hay không.
(2) Xem xét riêng những điểm khác biệt
Chỉ một vài điểm ngoại lai và điểm đơn độc cũng có thể làm thay đổi mạnh kết quả. Cần xác định điểm đó là lỗi nhập liệu hay thực sự là một trường hợp đặc biệt, rồi mới quyết định phương pháp phân tích.
(3) Không kết luận từ một con số duy nhất
Hệ số tương quan cao chỉ có nghĩa là các điểm nằm gần một đường thẳng, chứ không cho biết hình dạng hay nguyên nhân của mối quan hệ.
Bộ tứ Anscombe cho thấy các thống kê tóm tắt chỉ là cái bóng cô đọng của dữ liệu. Cũng như nhiều vật thể khác nhau có thể đổ cùng một cái bóng, những hình dạng hoàn toàn khác nhau cũng có thể ẩn sau cùng những con số.
Trước khi tin vào các con số, hãy tự vẽ đồ thị của dữ liệu đã tạo ra chúng; đó chính là bước đầu tiên của tư duy thống kê giúp chúng ta đọc dữ liệu đúng đắn.