在搜索框里输入关键词、扫一眼结果时,我们通常只看排在最前面的几条。可那几条究竟是真正需要的资料,还是只是挂了一堆相似标题,并不容易判断。在评价信息检索的领域里,人们把这种“对上的和漏掉的”拆成两个数字。那就是精确率与召回率(Precision and Recall)。
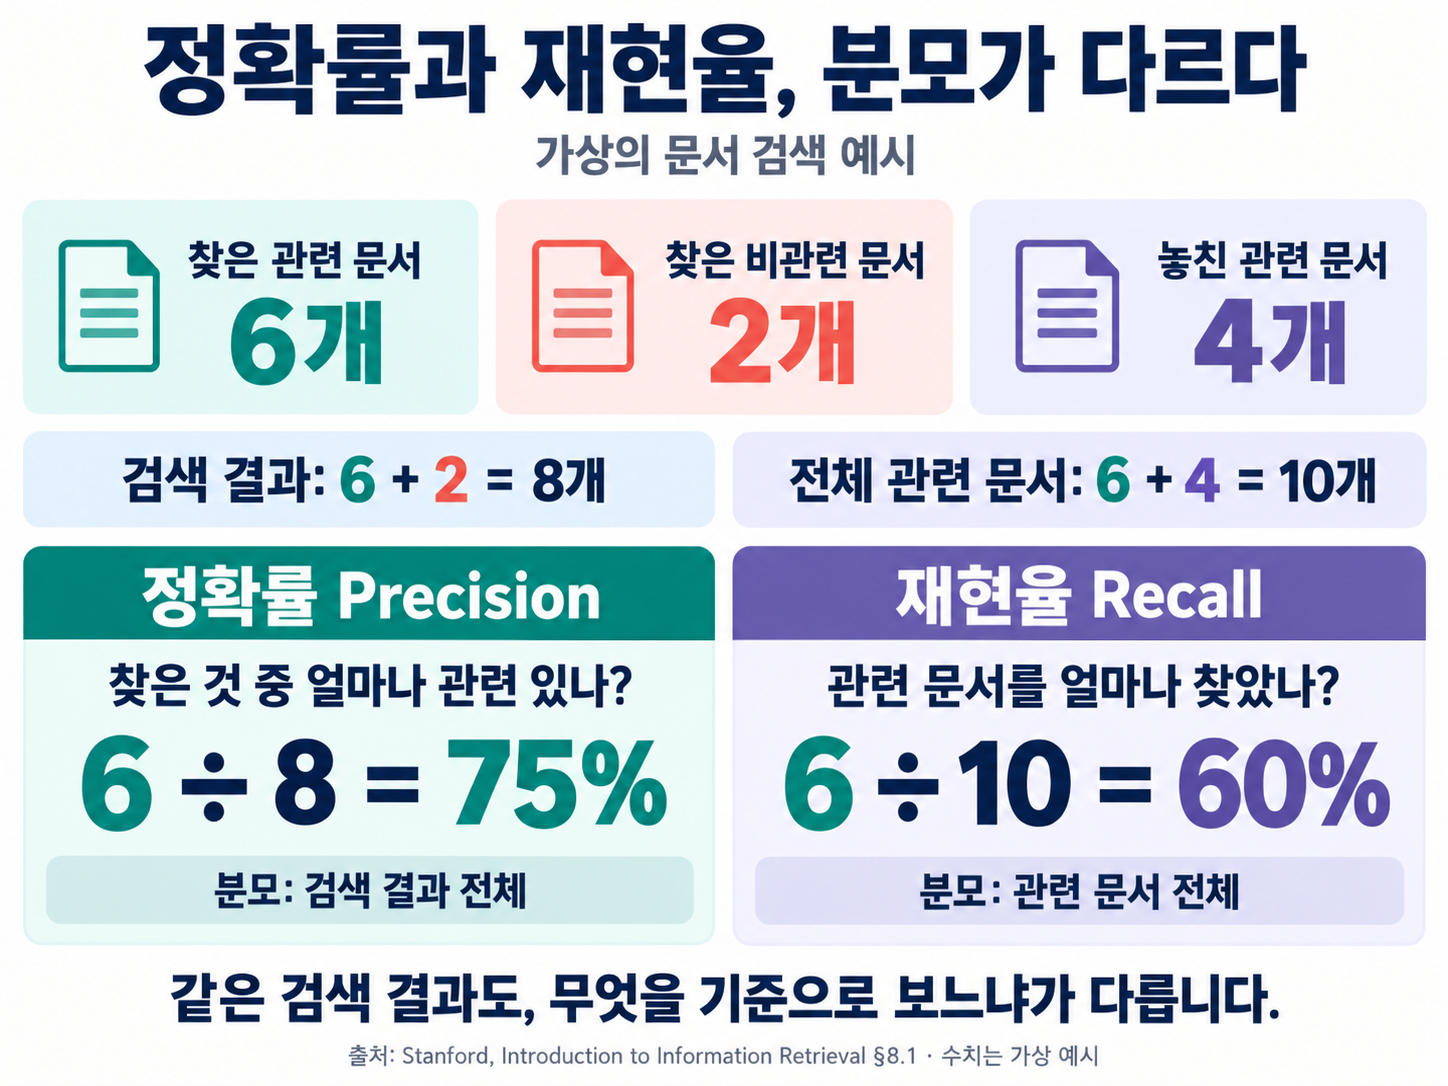
简单来说,精确率是“检索回来的文档中,真正相关的所占比例”,召回率是“全部相关文档中,实际找出来的所占比例”。两者提出的问题并不一样。一个问“带回来的结果有多合适”,另一个问“该找的东西漏掉了多少”。这与日常所说的“准确”略有不同:这里的精确率指结果列表的纯度,召回率则指网收得有多宽。
本文将依次介绍精确率与召回率的定义、二者之间的权衡关系、把两者一并看待的F1值,以及经典检索评价为何使用这些指标。
衡量检索结果的两个尺度:精确率与召回率
精确率与召回率各自在问什么
信息检索中的评价通常这样开始:针对某个查询,事先划定“相关文档”和“不相关文档”,再与系统给出的结果集合对照。此时的核心是两个比例。
- 精确率(Precision):在检索带回的文档中,真正相关的文档所占的比例。
- 召回率(Recall):在全部相关文档中,检索实际找到的相关文档所占的比例。
打个简单的比方,就像在图书馆里挑作业要用的书。从书架上拿了十本,其中九本都合题,精确率就高;图书馆里相关的书有二十本,你只拿了两本,召回率就低。同是“找”,看的基准不同,分数也就不同。用户感觉“搜索好不好用”,其实常常是这两根轴混在一起。
抬高一边,另一边就晃:权衡关系

若只想抬高精确率,系统会尽量只留下非常有把握的文档。结果显得干净,但落在边界附近的相关文档可能被滤掉。反过来,若只想抬高召回率,就会把可能相关的文档尽量往宽里捞。漏掉的资料少了,不相关的也更容易混进来。这种关系,也像在搜索框里拧紧或松开过滤器。
(1)高精确率更重要的时候
像网页搜索那样,用户只看首页上的几条,就会希望那几条是对的。一旦夹进离谱结果,很容易立刻放弃搜索。
(2)高召回率更重要的时候
在法律、医学、专利这类必须尽量收齐相关资料的专业检索里,哪怕有一点噪声,也宁可不要漏掉文档,这样更稳妥。
因此,只看一边就说系统“好”,并不容易。什么都捞回来,召回率可以接近1,精确率却可能掉到谷底;几乎什么都不带回来,精确率看起来很高,召回率却可能空空如也。好的检索,更接近按目的为两根轴分配分量。
把两者收成一行的F1值
即使分别看了精确率和召回率,有时仍需要一个概括分数。那时常用的是F测度,其中尤以兼顾两边的F1为典型。F1是精确率与召回率的调和平均:两者之中有一个明显偏低,分数也会跟着下来。可以把它理解成比算术平均更敏感地响应较低的一侧。
例如精确率很高、召回率很低时,F1不会跟着高的一边走,而是被拉向低的一边。反过来,只有两者都达到一定高度,F1才会稳稳上升。不过F1高,并不等于适合所有使用情境。正如前面所说,有的任务更看重精确率,有的更看重召回率。F1是“用一个数字快速比较”的工具,并不能代替目的本身。即便分数相同,也有必要再沿两根轴读一遍:为什么会出现这个分数。
经典检索评价为何使用这些指标
精确率与召回率,与信息检索评价的经典框架很合拍。被称为克兰菲尔德范式(Cranfield paradigm)的做法,是以固定的文档集合与查询,以及人工评估者给出的相关性判断为基准,来比较系统。后来TREC这类大规模评价,也是把同一思路加以拓展:以相关与不相关为基准,用精确率和召回率衡量系统带回了什么。
当然,现实中的检索更复杂。相关性因人而略有不同,事先知道全部相关文档也很困难。在有排序的结果里,还要反映用户往往只看前几条的习惯。即便是同一查询,为作业查资料和晚上扫新闻,所要的平衡也不一样。即便如此,这两个指标能长期留下来,理由很清楚:它们把“带回来的东西的质量”和“没有漏掉的范围”分开来展示。无论用搜索引擎还是图书馆目录,我们看着结果列表时,其实已经在心里抛出这两个问题。指标的名字或许陌生,那种感觉却早已熟悉。
精确率告诉我们找到的结果有多合适,召回率告诉我们该找的东西收齐了多少。只抬高一边,另一边就容易晃;F1则把这种张力收成一行。与其死记数字,不如先察觉此刻自己的搜索正把分量放在哪一边,往往更有用。
看检索结果时,同时问“是不是只挑对了的”和“有没有漏掉的”——这就是理解信息检索的第一步。