Khi nhập từ khóa vào ô tìm kiếm rồi lướt qua kết quả, chúng ta thường chỉ xem vài kết quả xuất hiện đầu tiên. Nhưng không dễ xác định vài kết quả ấy có thực sự là tài liệu cần tìm hay chỉ là hàng loạt tài liệu có tiêu đề tương tự. Trong lĩnh vực đánh giá truy hồi thông tin, những gì “tìm đúng và bỏ sót” này được thể hiện bằng hai con số. Đó chính là độ chính xác và độ bao phủ (Precision and Recall).
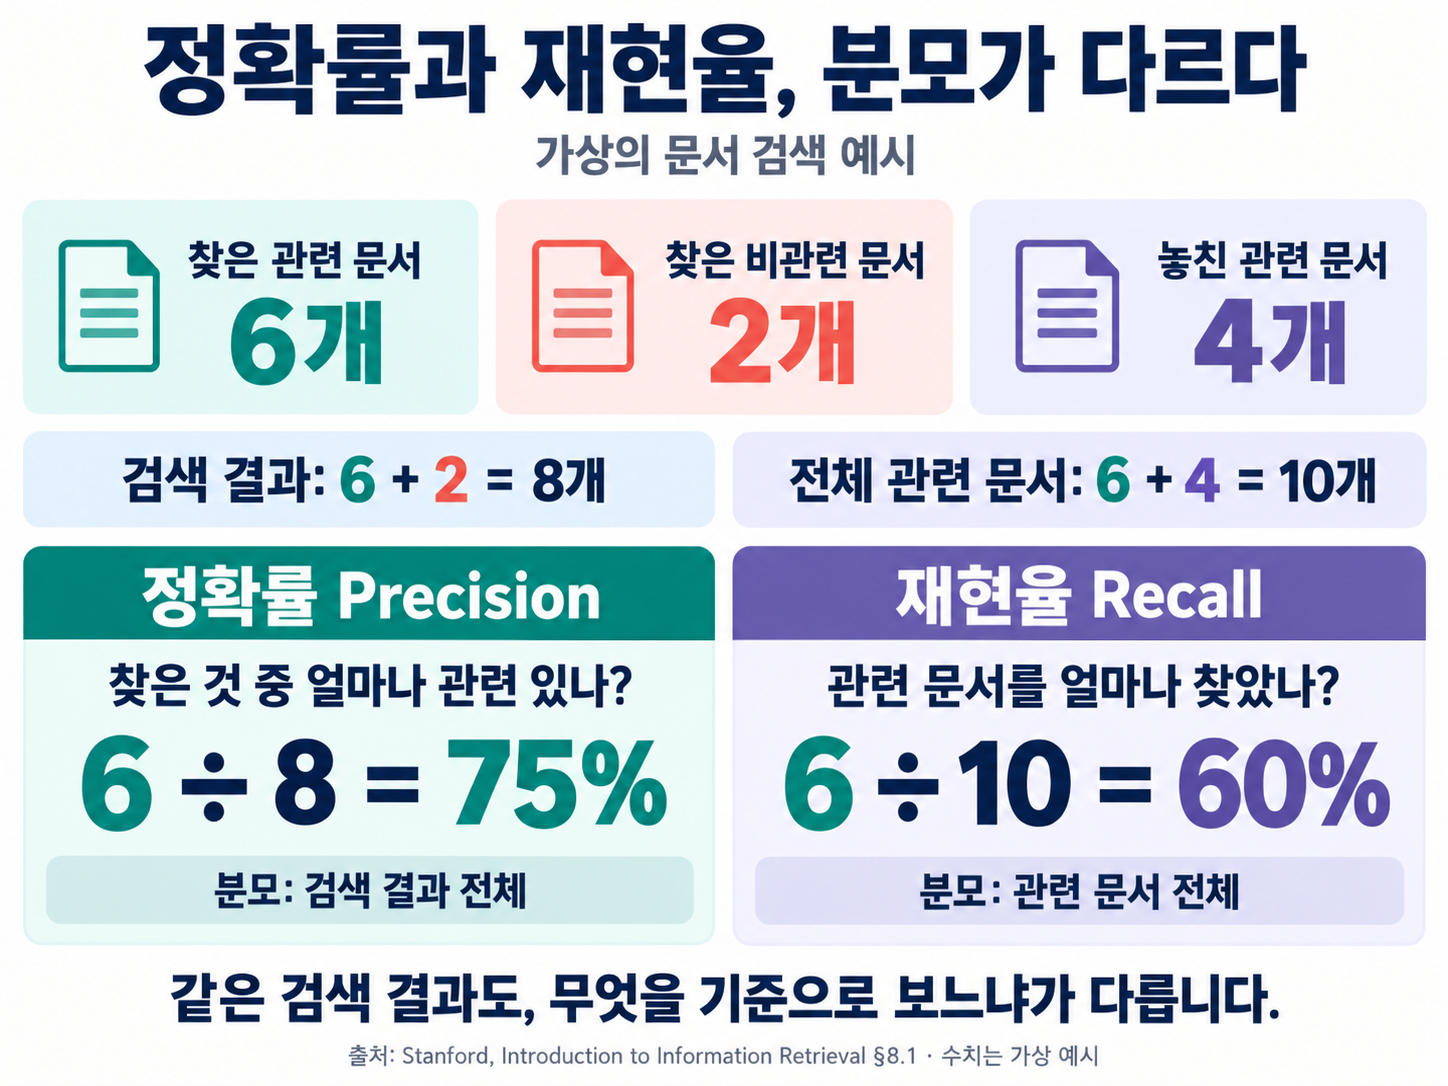
Nói đơn giản, độ chính xác là “tỷ lệ tài liệu thực sự liên quan trong số các tài liệu được truy hồi”, còn độ bao phủ là “tỷ lệ tài liệu thực sự tìm được trong toàn bộ tài liệu liên quan”. Hai chỉ số đặt ra hai câu hỏi khác nhau. Một câu là “Các kết quả trả về phù hợp đến mức nào”, câu còn lại là “Đã tìm được bao nhiêu trong số những gì cần tìm mà không bỏ sót”. Ý nghĩa này hơi khác với từ “chính xác” dùng hằng ngày. Ở đây, độ chính xác chỉ mức độ thuần nhất của danh sách kết quả, còn độ bao phủ chỉ phạm vi rộng đến đâu mà tấm lưới thu được.
Trong tài liệu này, chúng ta sẽ lần lượt tìm hiểu định nghĩa của độ chính xác và độ bao phủ, sự đánh đổi giữa hai chỉ số, điểm F1 dùng để xem xét đồng thời cả hai, và lý do các phương pháp đánh giá truy hồi truyền thống sử dụng những chỉ số này.
Hai thước đo kết quả tìm kiếm: độ chính xác và độ bao phủ
Những câu hỏi khác nhau mà độ chính xác và độ bao phủ đặt ra
Trong truy hồi thông tin, việc đánh giá thường bắt đầu như sau. Với một truy vấn nhất định, người ta xác định trước “tài liệu liên quan” và “tài liệu không liên quan”, rồi so sánh chúng với tập kết quả mà hệ thống trả về. Hai tỷ lệ sau là trọng tâm của việc đánh giá này.
- Độ chính xác (Precision): Tỷ lệ tài liệu thực sự liên quan trong tổng số tài liệu được truy hồi.
- Độ bao phủ (Recall): Tỷ lệ tài liệu liên quan mà quá trình tìm kiếm thực sự tìm được trong tổng số tài liệu liên quan.
Một ví dụ dễ hiểu là việc chọn sách trong thư viện để làm bài tập. Nếu lấy mười cuốn trên giá và chín cuốn trong số đó phù hợp với chủ đề thì độ chính xác cao. Ngược lại, nếu thư viện có hai mươi cuốn sách liên quan nhưng chỉ lấy được hai cuốn thì độ bao phủ thấp. Cùng là “tìm kiếm”, nhưng điểm số sẽ khác nhau tùy theo tiêu chí đánh giá. Trên thực tế, cảm nhận của người dùng rằng “tìm kiếm hiệu quả” cũng thường là sự kết hợp của hai phương diện này.
Sự đánh đổi khi nâng một chỉ số khiến chỉ số kia dao động

Nếu chỉ cố nâng độ chính xác, hệ thống sẽ có xu hướng chỉ giữ lại những tài liệu chắc chắn liên quan. Kết quả trở nên ít nhiễu hơn, nhưng những tài liệu liên quan nằm ở ranh giới có thể bị lọc bỏ. Ngược lại, nếu chỉ cố nâng độ bao phủ, hệ thống sẽ thu thập rộng rãi những tài liệu có khả năng liên quan. Số tài liệu bị bỏ sót giảm đi, nhưng tài liệu không liên quan cũng dễ lẫn vào. Mối quan hệ này giống như việc siết chặt hoặc nới lỏng bộ lọc trong ô tìm kiếm.
(1) Khi độ chính xác cao là điều quan trọng
Những người dùng chỉ xem vài kết quả trên màn hình đầu tiên, như khi tìm kiếm trên web, mong muốn những kết quả ấy phải phù hợp. Nếu có kết quả không liên quan xen vào, họ dễ lập tức từ bỏ việc tìm kiếm.
(2) Khi độ bao phủ cao là điều quan trọng
Trong tìm kiếm chuyên môn như pháp luật, y học và bằng sáng chế, nơi cần thu thập đầy đủ tài liệu liên quan, không bỏ sót tài liệu nào sẽ an toàn hơn, dù kết quả có đôi chút nhiễu.
Vì vậy, khó có thể gọi một hệ thống là “tốt” nếu chỉ nhìn vào một phía. Nếu lấy tất cả tài liệu, độ bao phủ sẽ tiến gần đến 1 nhưng độ chính xác có thể giảm xuống mức rất thấp; còn nếu gần như không lấy tài liệu nào, độ chính xác có vẻ cao nhưng độ bao phủ có thể gần như bằng không. Tìm kiếm tốt gần với việc lựa chọn trọng số cho hai phương diện sao cho phù hợp với mục đích.
Điểm F1 gói gọn cả hai trong một con số
Ngay cả khi đã xem riêng độ chính xác và độ bao phủ, đôi khi chúng ta vẫn cần một điểm số tổng hợp. Khi đó, thước đo F thường được sử dụng, đặc biệt là F1 với trọng số cân bằng. F1 là trung bình điều hòa của độ chính xác và độ bao phủ; nếu một trong hai chỉ số rất thấp, điểm số cũng giảm theo. Có thể hiểu rằng nó nhạy hơn với giá trị thấp so với trung bình cộng.
Ví dụ, nếu độ chính xác rất cao còn độ bao phủ rất thấp, F1 sẽ không đi theo giá trị cao mà bị kéo về phía giá trị thấp. Ngược lại, chỉ khi cả hai đều tương đối cao thì F1 mới tăng một cách ổn định. Tuy nhiên, F1 cao không có nghĩa là phù hợp với mọi tình huống sử dụng. Như đã thấy ở trên, có nhiệm vụ coi trọng độ chính xác hơn, có nhiệm vụ lại coi trọng độ bao phủ hơn. F1 là công cụ để “so sánh nhanh bằng một con số”, chứ không thay thế được mục đích tìm kiếm. Ngay cả khi điểm số giống nhau, chúng ta vẫn cần có thói quen xem lại cả hai phương diện để hiểu vì sao có điểm số ấy.
Vì sao đánh giá truy hồi truyền thống sử dụng những chỉ số này
Độ chính xác và độ bao phủ rất phù hợp với khuôn khổ truyền thống của việc đánh giá truy hồi thông tin. Phương pháp được gọi là mô hình Cranfield so sánh các hệ thống dựa trên một tập tài liệu và các truy vấn cố định, cùng những đánh giá về mức độ liên quan do con người đưa ra. Những hoạt động đánh giá quy mô lớn xuất hiện sau đó như TREC cũng mở rộng cùng ý tưởng này. Cụ thể, lấy sự phân biệt giữa liên quan và không liên quan làm cơ sở, rồi dùng độ chính xác và độ bao phủ để đo lường những gì hệ thống truy hồi được.
Dĩ nhiên, tìm kiếm trong thực tế phức tạp hơn. Mức độ liên quan có thể khác đôi chút giữa mỗi người, và cũng khó biết trước toàn bộ tài liệu liên quan. Với kết quả được xếp hạng, còn phải phản ánh hành vi người dùng chỉ xem vài kết quả đầu tiên. Ngay cả với cùng một truy vấn, việc tìm tài liệu cho bài tập và lướt tin tức buổi tối cũng đòi hỏi sự cân bằng khác nhau. Dù vậy, lý do hai chỉ số này tồn tại lâu dài rất rõ ràng. Chúng cho thấy riêng biệt “chất lượng của những gì được truy hồi” và “phạm vi đã tìm được mà không bỏ sót”. Dù sử dụng công cụ tìm kiếm hay mục lục thư viện, khi nhìn danh sách kết quả, chúng ta vốn đã tự đặt ra hai câu hỏi này trong đầu. Tên chỉ số có thể xa lạ, nhưng cảm nhận mà chúng thể hiện thì đã quen thuộc.
Độ chính xác cho biết các kết quả tìm được phù hợp đến mức nào, còn độ bao phủ cho biết đã thu thập được bao nhiêu trong số những gì cần tìm. Nếu chỉ nâng một phía, phía còn lại dễ dao động, và F1 tóm lược sự giằng co đó trong một con số. Thay vì ghi nhớ các con số, nhận ra việc tìm kiếm hiện tại của mình đang đặt trọng tâm vào phía nào sẽ hữu ích hơn.
Khi xem kết quả tìm kiếm, đồng thời tự hỏi “Đã chỉ chọn những gì phù hợp chưa” và “Có bỏ sót gì không” chính là bước đầu để hiểu về truy hồi thông tin.