读论文时,常会看到文末参考文献列表中熟悉的名字并排出现。如果一位研究者在同一篇文章中同时引用了两篇论文,那么这两篇论文很可能在讲某种相似的内容。如果这样的共同引用在许多文章中反复出现,就更难说是偶然了。
把这个简单的想法发展成绘制学术地图的方法的,正是“共被引分析(Co-citation Analysis)”。共被引分析是指统计两篇文献被其他文献共同引用的次数,次数越多,就判断两篇文献的主题越接近的一种引文分析方法。
本文将依次介绍共被引分析的诞生背景和基本原理、与类似方法文献耦合的区别、在作者分析和邻近分析方面的扩展应用,以及解读时需要注意的地方。
一起被提及的论文所揭示的学术结构
共被引分析的诞生
通过引用来解读文献之间关系的尝试,从1960年代开始正式展开。这得益于引文索引的建立,使人们能够大规模查看谁引用了谁。
(1) 凯斯勒的文献耦合
1963年,美国麻省理工学院的凯斯勒(M. M. Kessler)提出了文献耦合的概念,认为如果两篇论文共同参考了同一篇文献,它们就彼此相关。这是用引用计算文献相似度的早期方法之一,创建引文索引的尤金·加菲尔德(Eugene Garfield)也积极采纳了这一概念。
(2) 1973年,两人的相同发现
1973年,美国的亨利·斯莫尔(Henry Small)在一篇期刊论文中提出把共被引作为衡量两篇文献关系的新尺度。同一年,苏联的伊琳娜·马尔沙科娃(Irina Marshakova)也独立发表了相同的想法,但由于以俄语发表,相对鲜为人知。
共被引强度的计算方法
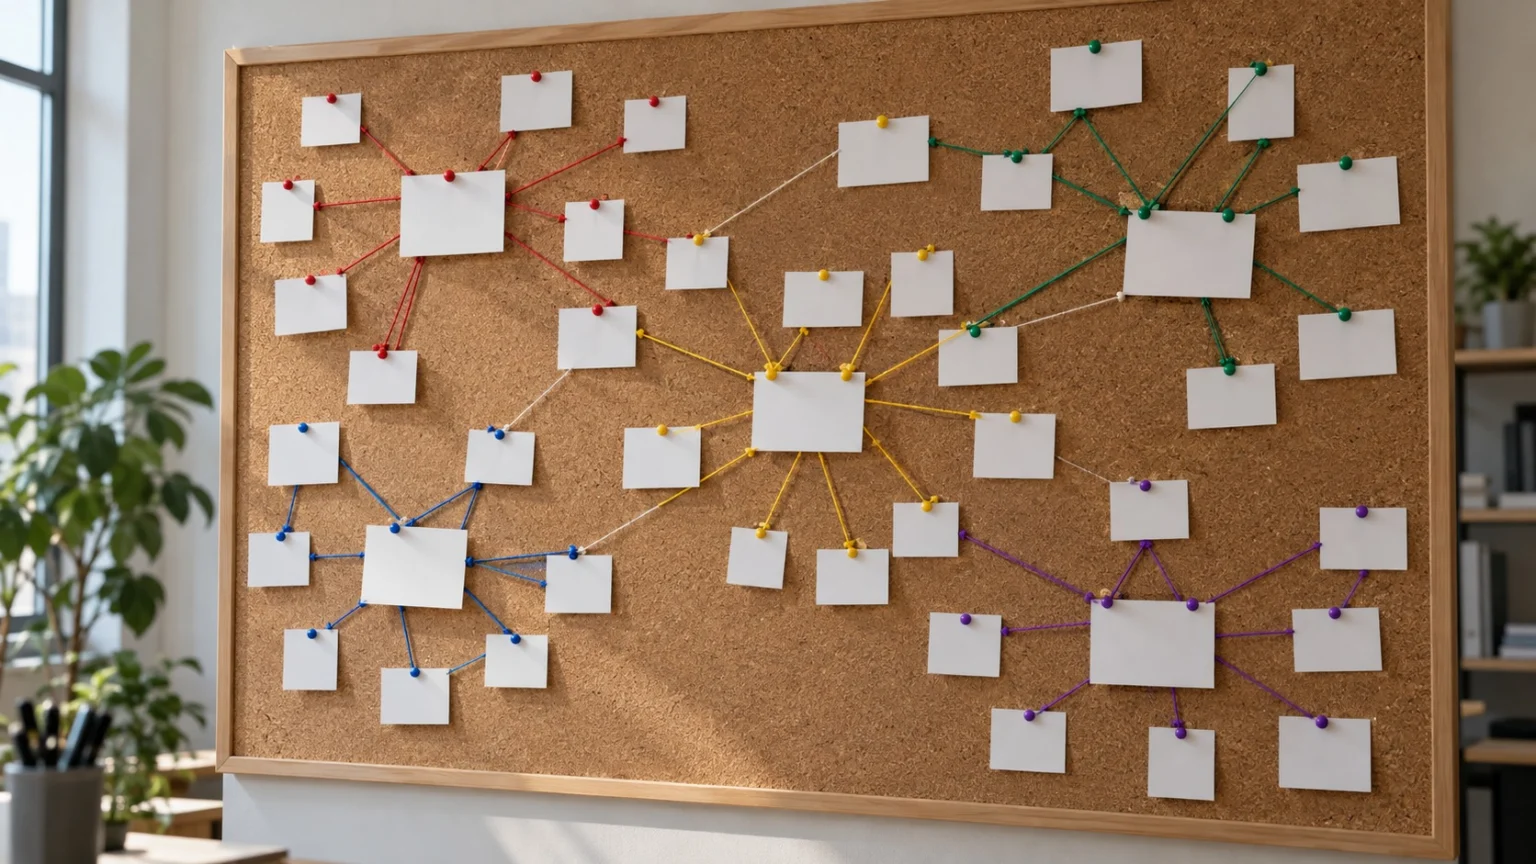
共被引分析的原理出乎意料地简单。拿出文献A和B,只要数一数同时引用了两者的其他文献有几篇即可。
- 共被引(Co-citation):一篇以上的其他文献同时引用A和B的关系。
- 共被引强度(Co-citation Strength):同时引用A和B的文献数量。如果文献C、D、E都引用了A和B,强度就是3。
- 聚类(Cluster):把共被引强度高的文献归在一起形成的群组,显示出一个研究主题或专业领域。
把这样归在一起的文献用点和线连起来画出来,就成了一张能一眼看出哪些研究构成同一个“街区”的知识地图。1974年,斯莫尔与贝尔弗·格里菲斯(Belver Griffith)一起发表了用这种方法找出科学的专业领域并以图形呈现的研究。
同样的原理也被用于文献检索。研究者找到一篇满意的论文时,如果接着展示经常与该论文一起被引用的文献,就能发现仅靠检索词容易遗漏的相关研究。
与文献耦合有什么不同
共被引分析和文献耦合都是用引用来衡量文献的相似程度,但观察的方向恰好相反。
(1) 回看过去的文献耦合
文献耦合比较的是两篇文献所写的参考文献列表。论文一经发表,参考文献就不会再改变,因此耦合强度也是固定的。
(2) 面向未来开放的共被引
共被引是由之后引用这两篇文献的其他研究形成的。随着学术发展,新论文不断出现,因此强度也会随时间变化,分类也可能随着领域的发展而改变。
(3) 众人判断的累积结果
共被引汇集了阅读这些文献的众多作者的判断,因此被认为更能体现主题的相似性。其想法是,比起一个人挑选的参考文献,许多人反复归在一起的关系更加可靠。
(4) 结合两者的方法
也有研究者像得克萨斯大学的罗伯特·安斯勒(Robert Amsler)那样,提出同时使用文献耦合和共被引来判断两篇文献主题相似性的尺度。两种方法与其说是竞争关系,不如说更像是互补的搭档。
不断扩展的应用与解读的陷阱
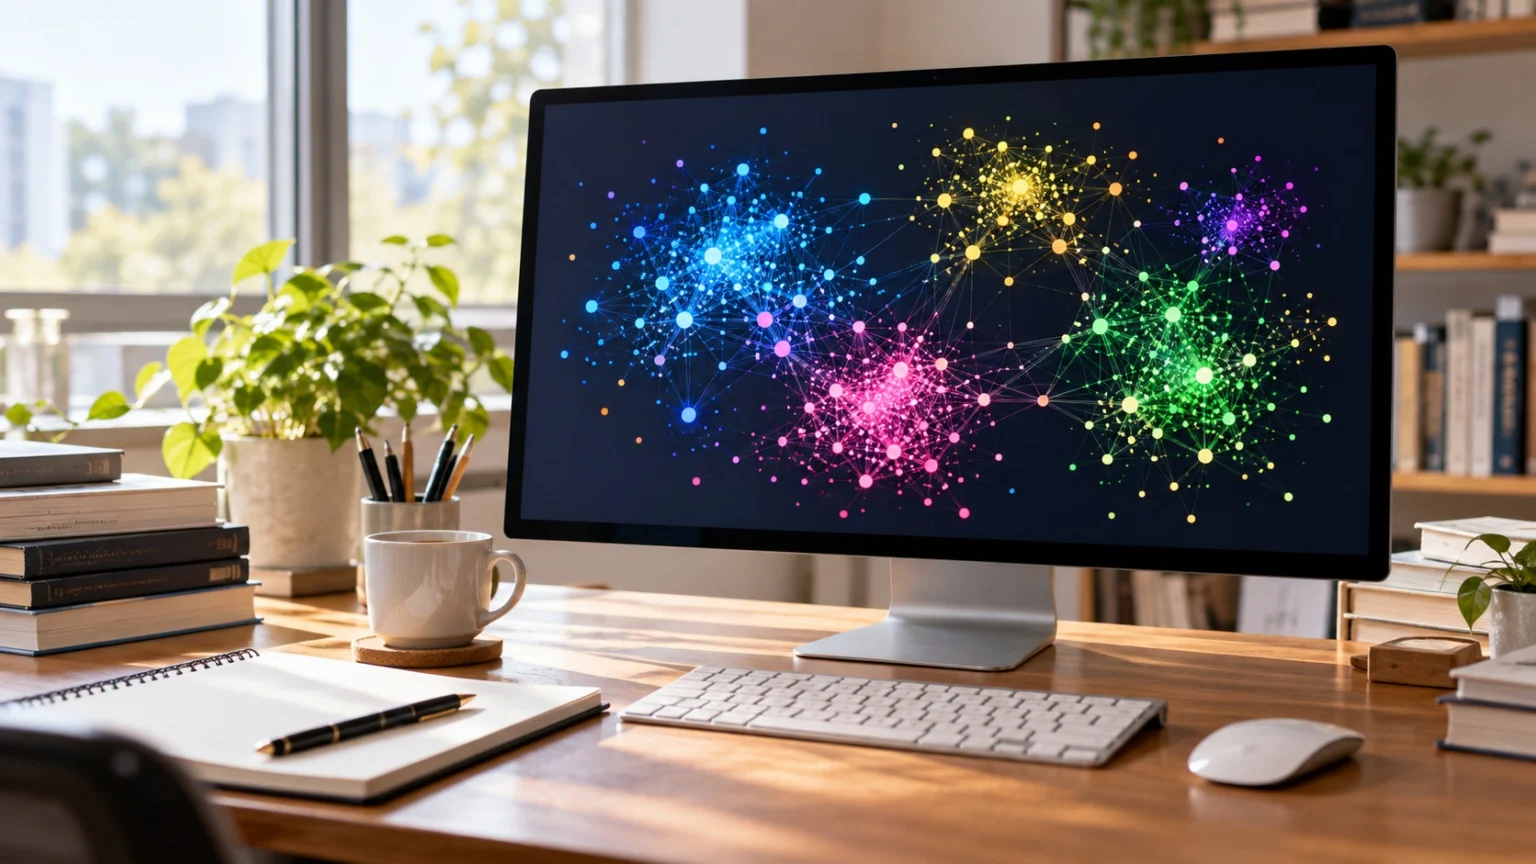
共被引分析已经超越文献本身,扩展为理解研究者和学科领域的工具。不过,在直接相信数字之前,也有一些需要推敲的地方。
(1) 作者共被引分析
1981年,霍华德·怀特(Howard White)和格里菲斯介绍了以作者而非论文为单位统计共被引的作者共被引分析。它作为展示哪些学者像一个学派一样聚在一起的方法而被广泛使用。
(2) 引文邻近分析
2009年,吉普(Bela Gipp)和比尔(Joeran Beel)提出了引文邻近分析,还把两个引用在正文中靠得多近也考虑在内。例如,在同一句话中被一起引用的文献被视为关系更近。
(3) 引用动机的差异
研究者有时会更频繁地引用关系亲近的同事的论文,也会出现已经有名的论文获得更多引用的马太效应。此外,引用不仅是为了称赞,也可能是为了反驳,所以被一起引用并不总意味着站在同一边。因此,共被引的结果应当与直接阅读内容的审查结合起来解读。
共被引分析汇集研究者留下的参考文献这一细小痕迹,揭示出学术的宏观结构。观察哪篇论文与哪篇论文一起被提及,甚至能读出新领域诞生并彼此交汇的脉络。
汇集被一起引用的痕迹来测量知识之间的距离,这正是绘制学术地图的文献计量学的第一步。