खोज बॉक्स में कोई कीवर्ड डालकर परिणामों पर नज़र दौड़ाते समय हम आम तौर पर सबसे ऊपर दिखने वाले कुछ ही परिणाम देखते हैं। लेकिन यह समझना आसान नहीं होता कि वे कुछ परिणाम वास्तव में हमारी ज़रूरत की सामग्री हैं या केवल मिलते-जुलते शीर्षकों का ढेर। सूचना पुनर्प्राप्ति का मूल्यांकन करने वाले क्षेत्र में इन ‘सही मिले और छूट गए परिणामों’ को दो संख्याओं के माध्यम से देखा जाता है। यही परिशुद्धता और पुनर्प्राप्ति दर (Precision and Recall) हैं।
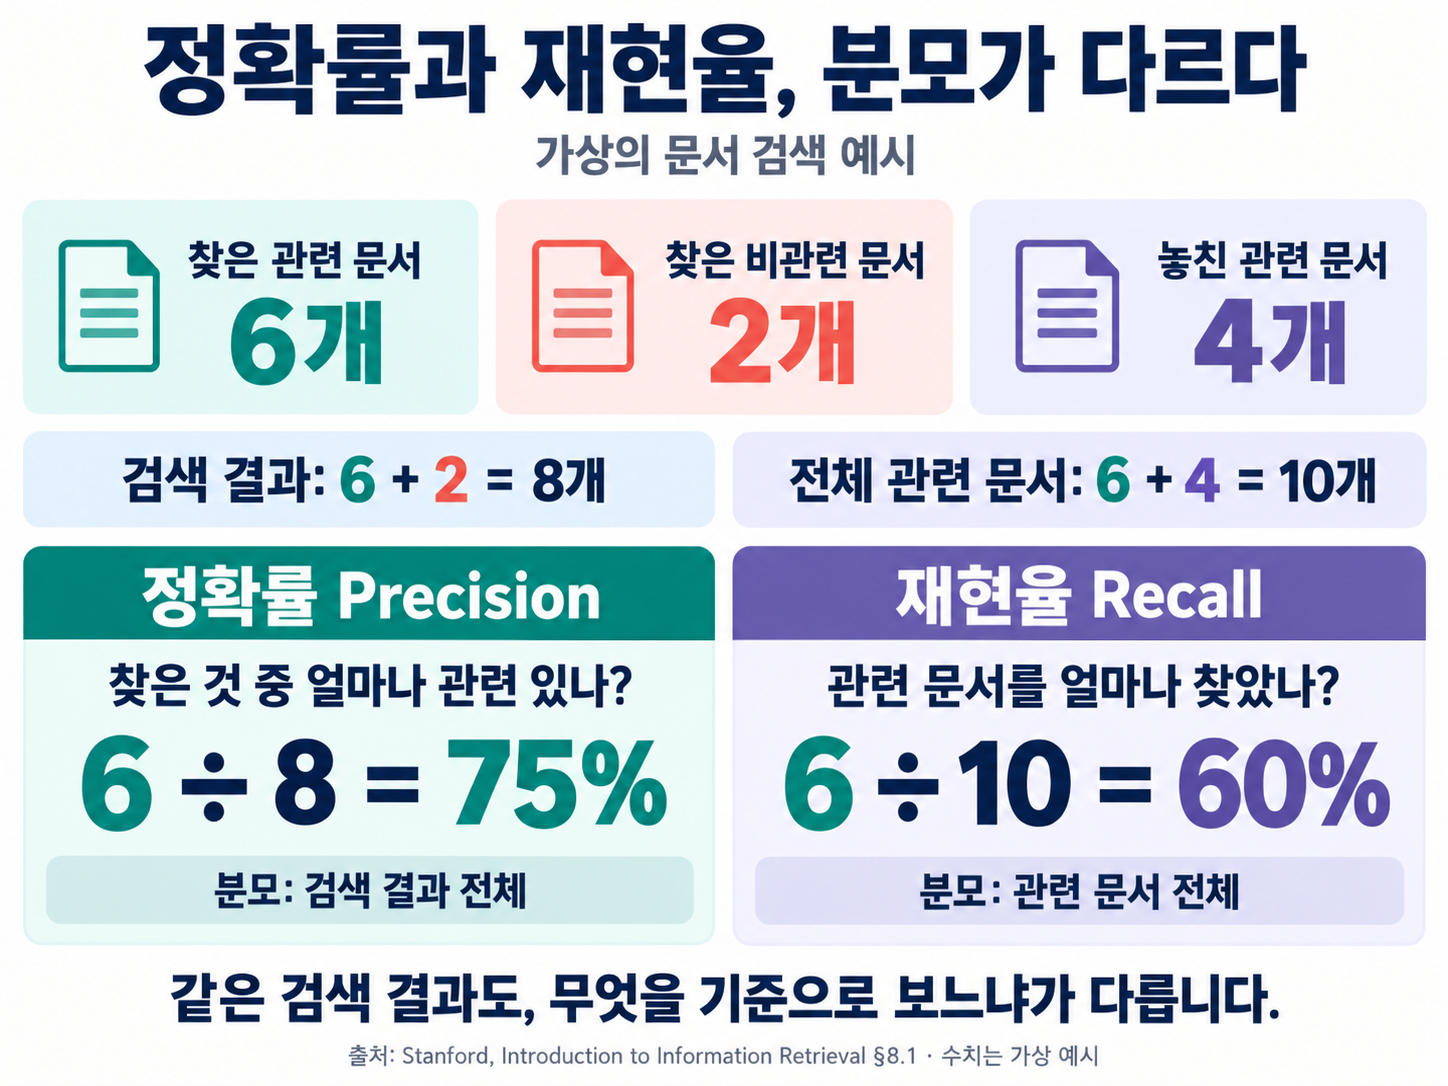
सरल शब्दों में, परिशुद्धता का अर्थ है ‘खोजकर प्राप्त किए गए दस्तावेज़ों में वास्तव में प्रासंगिक दस्तावेज़ों का अनुपात’, जबकि पुनर्प्राप्ति दर का अर्थ है ‘सभी प्रासंगिक दस्तावेज़ों में वास्तव में खोजे जा सके दस्तावेज़ों का अनुपात’। दोनों अलग-अलग सवाल पूछते हैं। एक सवाल है, “प्राप्त परिणाम कितने उपयुक्त हैं”, और दूसरा है, “जिन चीज़ों को खोजना था, उनमें से कितनी छूटने से बचीं”। इसका अर्थ रोज़मर्रा में इस्तेमाल होने वाले ‘सटीक’ शब्द से थोड़ा अलग है। यहाँ परिशुद्धता परिणामों की सूची की शुद्धता दर्शाती है, जबकि पुनर्प्राप्ति दर बताती है कि खोज का जाल कितने व्यापक दायरे की सामग्री समेट पाया।
इस सामग्री में हम क्रम से परिशुद्धता और पुनर्प्राप्ति दर की परिभाषाएँ, उनके बीच का समझौता, दोनों को एक साथ देखने वाला F1 मान और पारंपरिक खोज मूल्यांकन में इन मापकों के उपयोग के कारणों पर विचार करेंगे।
खोज परिणामों को मापने के दो पैमाने: परिशुद्धता और पुनर्प्राप्ति दर
परिशुद्धता और पुनर्प्राप्ति दर के अलग-अलग सवाल

सूचना पुनर्प्राप्ति में मूल्यांकन आम तौर पर इस तरह शुरू होता है। किसी क्वेरी के लिए पहले से तय किया जाता है कि कौन-से दस्तावेज़ ‘प्रासंगिक’ और कौन-से ‘अप्रासंगिक’ हैं, फिर उनकी तुलना प्रणाली द्वारा दिए गए परिणामों के समूह से की जाती है। यहाँ दो अनुपात सबसे अहम हैं।
- परिशुद्धता (Precision): खोज से प्राप्त कुल दस्तावेज़ों में वास्तव में प्रासंगिक दस्तावेज़ों का अनुपात।
- पुनर्प्राप्ति दर (Recall): सभी प्रासंगिक दस्तावेज़ों में उन प्रासंगिक दस्तावेज़ों का अनुपात जिन्हें खोज वास्तव में ढूँढ़ पाई।
इसे एक आसान उदाहरण से समझें तो यह पुस्तकालय में किसी असाइनमेंट के लिए किताबें चुनने जैसा है। यदि आपने अलमारी से दस किताबें उठाईं और उनमें से नौ विषय के अनुरूप हैं, तो परिशुद्धता ऊँची है। दूसरी ओर, यदि पुस्तकालय में बीस प्रासंगिक किताबें हैं और आपने उनमें से केवल दो उठाईं, तो पुनर्प्राप्ति दर कम है। ‘खोजने’ का काम एक ही होने पर भी उसका मूल्यांकन इस आधार पर बदल जाता है कि आप किस कसौटी से उसे देखते हैं। उपयोगकर्ता को होने वाला यह एहसास कि ‘खोज अच्छी तरह काम करती है’, अक्सर इन्हीं दोनों पहलुओं का मिला-जुला परिणाम होता है।
एक को बढ़ाने पर दूसरे का संतुलन बिगड़ने का समझौता

यदि केवल परिशुद्धता बढ़ाने की कोशिश की जाए, तो प्रणाली सिर्फ उन्हीं दस्तावेज़ों को रखने का प्रयास करती है जिनकी प्रासंगिकता पर उसे बहुत भरोसा हो। परिणाम साफ़-सुथरे हो जाते हैं, लेकिन प्रासंगिकता की सीमा पर मौजूद दस्तावेज़ छँटकर बाहर हो सकते हैं। इसके उलट, यदि केवल पुनर्प्राप्ति दर बढ़ाने की कोशिश की जाए, तो प्रणाली ऐसे दस्तावेज़ों को भी व्यापक रूप से समेटती है जिनके प्रासंगिक होने की संभावना है। छूटने वाली सामग्री कम हो जाती है, लेकिन साथ में अप्रासंगिक दस्तावेज़ भी आसानी से मिल सकते हैं। यह संबंध खोज बॉक्स के फ़िल्टर को कड़ा या ढीला करने जैसा भी है।
(1) जब ऊँची परिशुद्धता महत्वपूर्ण हो
वेब खोज की तरह केवल पहली स्क्रीन पर दिखने वाले कुछ परिणाम देखने वाले उपयोगकर्ता चाहते हैं कि वे कुछ परिणाम सही हों। यदि उनमें बेमेल परिणाम शामिल हो जाएँ, तो वे तुरंत खोज छोड़ सकते हैं।
(2) जब ऊँची पुनर्प्राप्ति दर महत्वपूर्ण हो
कानून, चिकित्सा और पेटेंट जैसी विशिष्ट खोजों में, जहाँ प्रासंगिक सामग्री को बिना कुछ छोड़े इकट्ठा करना ज़रूरी होता है, कुछ अप्रासंगिक सामग्री शामिल होने पर भी किसी दस्तावेज़ का न छूटना अधिक सुरक्षित होता है।
इसलिए केवल एक पहलू देखकर किसी प्रणाली को ‘अच्छा’ कहना मुश्किल है। सब कुछ प्राप्त कर लेने पर पुनर्प्राप्ति दर 1 के करीब पहुँच जाती है, लेकिन परिशुद्धता बहुत नीचे गिर सकती है। वहीं लगभग कुछ भी प्राप्त न करने पर परिशुद्धता ऊँची दिख सकती है, लेकिन पुनर्प्राप्ति दर लगभग शून्य हो सकती है। अच्छी खोज का अर्थ अपने उद्देश्य के अनुसार इन दोनों पहलुओं को उचित महत्व देना है।
दोनों को एक मान में समेटने वाला F1 मान

परिशुद्धता और पुनर्प्राप्ति दर को अलग-अलग देखने के बाद भी कभी-कभी एक समेकित स्कोर की ज़रूरत होती है। तब अक्सर F माप का उपयोग किया जाता है, विशेष रूप से दोनों को समान महत्व देने वाले F1 का। F1 परिशुद्धता और पुनर्प्राप्ति दर का हरात्मक माध्य है, इसलिए दोनों में से कोई एक बहुत कम हो, तो स्कोर भी घट जाता है। इसे ऐसे समझ सकते हैं कि यह अंकगणितीय माध्य की तुलना में कम मान के प्रति अधिक संवेदनशील होता है।
उदाहरण के लिए, यदि परिशुद्धता बहुत ऊँची और पुनर्प्राप्ति दर बहुत कम हो, तो F1 ऊँचे मान के साथ नहीं जाता, बल्कि कम मान की ओर खिंचता है। इसके विपरीत, दोनों के कुछ हद तक ऊँचे होने पर ही F1 भी स्थिर रूप से बढ़ता है। हालाँकि, F1 ऊँचा होने का अर्थ यह नहीं कि प्रणाली उपयोग की हर परिस्थिति के लिए उपयुक्त है। जैसा कि पहले देखा, कुछ कार्य परिशुद्धता को अधिक महत्व देते हैं और कुछ पुनर्प्राप्ति दर को। F1 ‘एक संख्या से जल्दी तुलना करने’ का साधन है; यह स्वयं उद्देश्य की जगह नहीं लेता। स्कोर समान होने पर भी यह समझने की आदत ज़रूरी है कि वह स्कोर क्यों आया, और इसके लिए दोनों पहलुओं को फिर से देखना चाहिए।
पारंपरिक खोज मूल्यांकन में इन मापकों का उपयोग क्यों होता है

परिशुद्धता और पुनर्प्राप्ति दर सूचना पुनर्प्राप्ति के मूल्यांकन के पारंपरिक ढाँचे में अच्छी तरह फिट बैठती हैं। क्रैनफ़ील्ड प्रतिमान कहलाने वाली पद्धति में दस्तावेज़ों के एक निश्चित संग्रह, क्वेरी और मानव मूल्यांकनकर्ताओं द्वारा दिए गए प्रासंगिकता संबंधी निर्णयों के आधार पर प्रणालियों की तुलना की जाती है। बाद में आए TREC जैसे बड़े पैमाने के मूल्यांकन भी इसी विचार का विस्तार हैं। प्रासंगिक और अप्रासंगिक होने को आधार बनाकर, परिशुद्धता और पुनर्प्राप्ति दर से मापा जाता है कि प्रणाली ने क्या प्राप्त किया।
बेशक, वास्तविक खोज अधिक जटिल होती है। प्रासंगिकता की समझ हर व्यक्ति में थोड़ी अलग होती है और सभी प्रासंगिक दस्तावेज़ों का पहले से पता होना भी मुश्किल है। क्रमबद्ध परिणामों में केवल ऊपर के कुछ परिणाम देखने वाले उपयोगकर्ताओं के व्यवहार को भी ध्यान में रखना पड़ता है। एक ही क्वेरी होने पर भी असाइनमेंट के लिए सामग्री जुटाने और शाम की ख़बरों पर नज़र दौड़ाने के लिए अलग-अलग संतुलन चाहिए। फिर भी इन दोनों मापकों के लंबे समय तक बने रहने का कारण स्पष्ट है। वे ‘प्राप्त सामग्री की गुणवत्ता’ और ‘बिना छोड़े समेटे गए दायरे’ को अलग-अलग दिखाते हैं। चाहे हम खोज इंजन इस्तेमाल करें या पुस्तकालय की सूची, परिणाम देखते समय अपने मन में पहले से ही ये दोनों सवाल पूछ रहे होते हैं। मापकों के नाम अपरिचित हो सकते हैं, लेकिन उनसे जुड़ा अनुभव पहले से परिचित है।
परिशुद्धता दिखाती है कि मिले हुए परिणाम कितने उपयुक्त हैं, जबकि पुनर्प्राप्ति दर बताती है कि खोजी जाने वाली सामग्री में से कितना हिस्सा प्राप्त हुआ। केवल एक को बढ़ाने पर दूसरे का संतुलन आसानी से बिगड़ सकता है, और F1 इस तनाव को एक मान में समेट देता है। संख्याएँ याद करने की तुलना में यह पहचानना अधिक उपयोगी है कि इस समय आपकी खोज किस पहलू को अधिक महत्व दे रही है।
खोज परिणाम देखते समय एक साथ यह पूछना कि ‘क्या केवल सही चीज़ें चुनी गई हैं’ और ‘क्या कुछ छूट तो नहीं गया’, सूचना पुनर्प्राप्ति को समझने का पहला कदम है।