
미지의 공간을 스스로 그리다, 동시적 위치추정 및 지도작성(Simultaneous Localization and Mapping)
돌아오는 길도 물류다, 역물류(Reverse Logistics)
검색창에 키워드를 넣고 결과를 훑을 때, 우리는 대개 맨 위에 뜬 몇 건만 확인합니다. 그런데 그 몇 건이 정말 필요한 자료인지, 아니면 비슷한 제목만 잔뜩 걸린 건지 가늠하기는 쉽지 않습니다. 정보 검색을 평가하는 분야에서는 이 ‘맞은 것과 놓친 것’을 두 숫자로 나눕니다. 그것이 바로 정확률과 재현율(Precision and Recall)입니다.
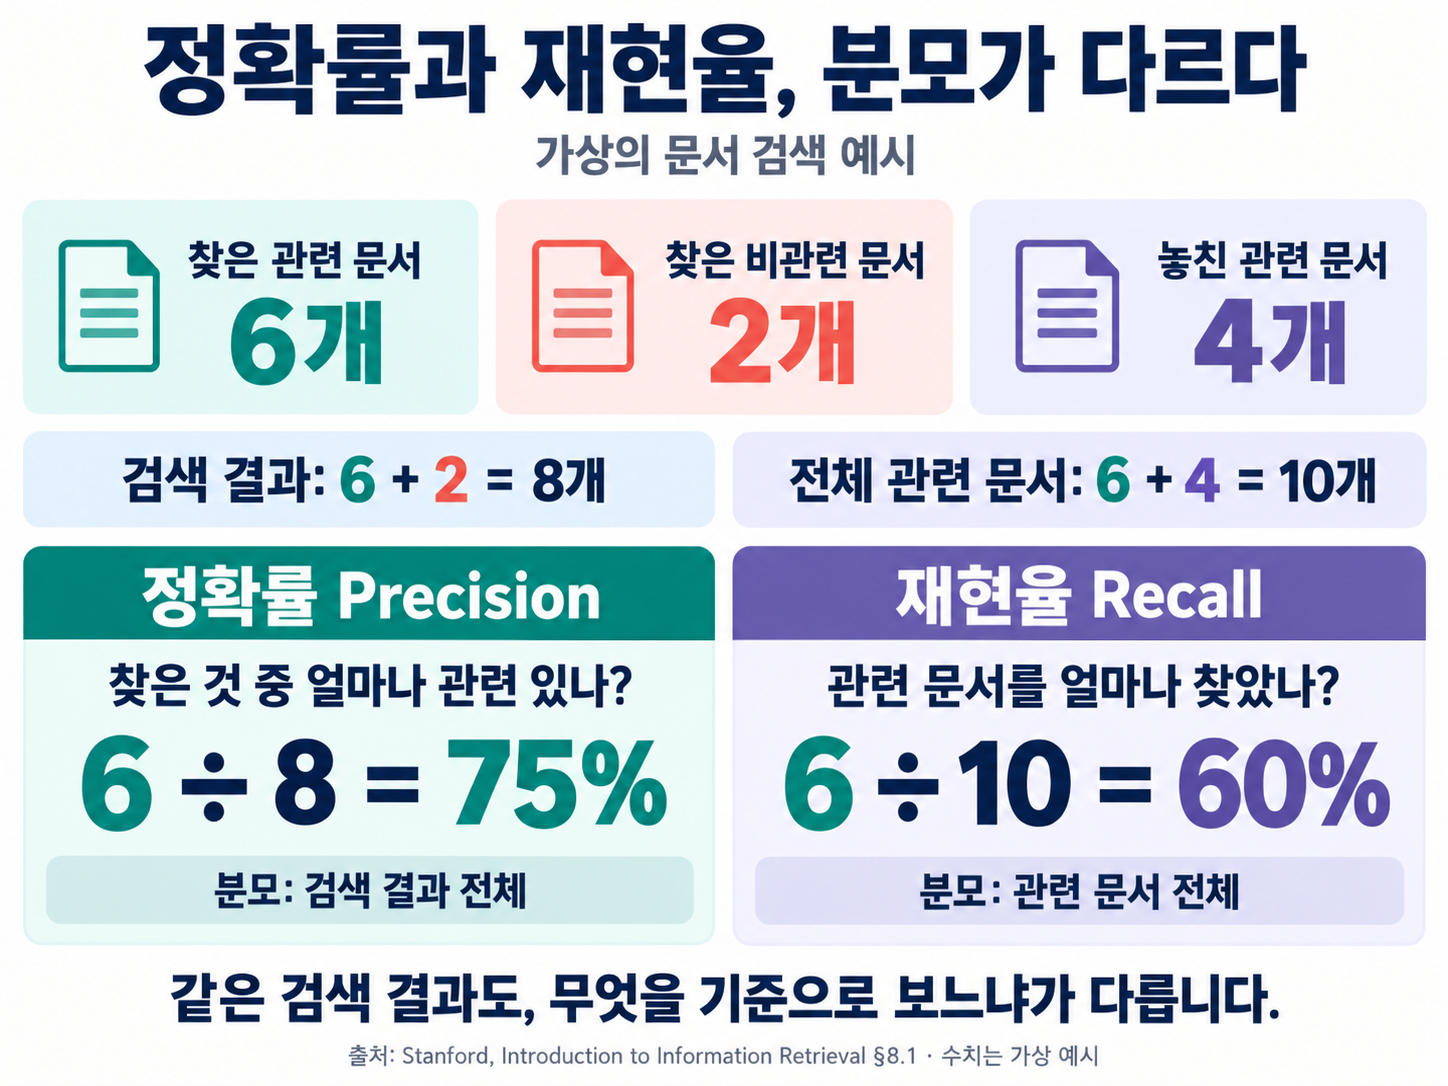
정확률이란 쉽게 말해 ‘검색해서 가져온 문서 가운데 실제로 관련 있는 것의 비율’이고, 재현율은 ‘관련 있는 문서 전체 가운데 실제로 찾아낸 것의 비율’을 의미합니다. 둘은 서로 다른 질문을 던집니다. 하나는 “가져온 결과가 얼마나 알맞은가”, 다른 하나는 “찾아야 할 것을 얼마나 놓치지 않았는가”입니다. 일상에서 쓰는 ‘정확하다’와는 결이 조금 다릅니다. 여기서의 정확률은 결과 목록의 순도를, 재현율은 그물이 거둔 범위의 넓이를 가리킵니다.
본 자료에서는 정확률과 재현율의 정의부터 둘 사이의 상충 관계, 둘을 한꺼번에 보는 F1 값, 그리고 고전적인 검색 평가가 이런 지표를 쓰는 까닭까지 차례로 살펴보겠습니다.
검색 결과를 재는 두 자, 정확률과 재현율
정확률과 재현율이 묻는 서로 다른 질문
정보 검색에서 평가는 대개 이렇게 시작합니다. 어떤 질의에 대해 ‘관련 있는 문서’와 ‘관련 없는 문서’를 미리 정해 두고, 시스템이 내놓은 결과 집합과 비교합니다. 이때 핵심은 두 비율입니다.
- 정확률(Precision): 검색으로 가져온 문서 수 가운데, 실제로 관련 있는 문서가 차지하는 비율입니다.
- 재현율(Recall): 전체 관련 문서 수 가운데, 검색이 실제로 찾아낸 관련 문서가 차지하는 비율입니다.
쉬운 비유로 말하면, 도서관에서 과제에 쓸 책을 고르는 일과 같습니다. 서가에서 열 권을 집었는데 그중 아홉 권이 주제와 맞으면 정확률이 높습니다. 반면 도서관에 관련 책이 스무 권 있는데 그중 두 권만 집었다면 재현율은 낮습니다. 같은 ‘찾기’라도 무엇을 기준으로 보느냐에 따라 점수가 갈립니다. 이용자가 느끼는 ‘검색이 잘된다’는 감각도, 사실 이 두 축이 섞여 있는 경우가 많습니다.
하나를 올리면 다른 쪽이 흔들리는 상충
정확률만 높이려 하면 시스템은 아주 확실한 문서만 남기려 합니다. 결과는 깨끗해지지만, 경계선에 있던 관련 문서는 걸러질 수 있습니다. 반대로 재현율만 높이려 하면 관련 가능성이 있는 문서를 넓게 끌어옵니다. 놓치는 자료는 줄어들지만, 관련 없는 문서도 함께 섞이기 쉽습니다. 이 관계는 검색 창의 필터를 조이거나 푸는 일과도 닮았습니다.
(1) 높은 정확률이 중요한 때
웹 검색처럼 첫 화면에 몇 건만 보는 이용자는, 그 몇 건이 맞기를 바랍니다. 엉뚱한 결과가 섞이면 바로 검색을 포기하기 쉽습니다.
(2) 높은 재현율이 중요한 때
법률·의학·특허처럼 관련 자료를 빠짐없이 모아야 하는 전문 검색에서는, 다소 잡음이 있어도 놓친 문서가 없는 편이 더 안전합니다.
그래서 한쪽만 보고 시스템을 ‘좋다’고 말하기는 어렵습니다. 모두 가져오면 재현율은 1에 가까워지지만 정확률은 바닥으로 떨어질 수 있고, 거의 아무것도 안 가져오면 정확률은 높아 보여도 재현율은 비어 있을 수 있습니다. 좋은 검색이란, 목적에 맞게 두 축의 무게를 고르는 일에 가깝습니다.
둘을 한 줄로 묶는 F1 값
정확률과 재현율을 각각 보고도, 때로는 하나의 요약 점수가 필요합니다. 그때 자주 쓰는 것이 F 측정값, 그중에서도 균형을 맞춘 F1입니다. F1은 정확률과 재현율의 조화 평균으로, 둘 중 하나가 크게 낮으면 점수도 함께 내려갑니다. 산술 평균보다 낮은 쪽에 더 민감하게 반응한다고 이해하면 됩니다.
예를 들어 정확률이 매우 높고 재현율이 매우 낮다면, F1은 높은 쪽을 따라가지 않고 낮은 쪽에 끌립니다. 반대로 둘 다 어느 정도 높을 때라야 F1도 안정적으로 올라갑니다. 다만 F1이 높다고 해서 모든 이용 상황에 맞는 것은 아닙니다. 앞서 본 것처럼 어떤 과제는 정확률을, 어떤 과제는 재현율을 더 중시합니다. F1은 ‘한 숫자로 빠르게 비교할 때’의 도구이지, 목적 자체를 대신하지는 않습니다. 같은 점수라도 왜 그 점수가 나왔는지를 두 축으로 다시 읽어 보는 습관이 필요합니다.
고전 검색 평가가 이 지표를 쓰는 까닭
정확률과 재현율은 정보 검색 평가의 고전적인 틀과 잘 맞습니다. 크랜필드 패러다임으로 불리는 방식은, 고정된 문서 모음과 질의, 그리고 사람 평가자가 매긴 관련성 판단을 바탕으로 시스템을 비교합니다. 뒤에 이어진 TREC 같은 대규모 평가도 같은 생각을 넓힌 것입니다. 관련·비관련을 기준으로 두고, 시스템이 무엇을 가져왔는지를 정확률과 재현율로 재는 것입니다.
물론 현실의 검색은 더 복잡합니다. 관련성은 사람마다 조금씩 다르고, 모든 관련 문서를 미리 알기도 어렵습니다. 순위가 있는 결과에서는 상위 몇 건만 보는 이용 행태도 반영해야 합니다. 같은 질의라도 과제용 자료 조사와 저녁 뉴스 훑기는 요구하는 균형이 다릅니다. 그럼에도 이 두 지표가 오래 살아남은 이유는 분명합니다. ‘가져온 것의 질’과 ‘놓치지 않은 범위’를 분리해 보여 주기 때문입니다. 검색 엔진을 쓰든 도서관 목록을 쓰든, 결과 목록을 볼 때 우리는 이미 이 두 질문을 머릿속에서 던지고 있습니다. 지표 이름은 낯설어도, 감각은 이미 익숙한 셈입니다.
정확률은 찾은 결과가 얼마나 알맞은지를, 재현율은 찾아야 할 것을 얼마나 거두었는지를 보여 줍니다. 한쪽만 높이면 다른 쪽이 흔들리기 쉽고, F1은 그 긴장을 한 줄로 요약해 줍니다. 숫자를 외우기보다, 지금 내 검색이 어느 쪽에 무게를 두고 있는지를 알아차리는 편이 더 쓸모 있습니다.
검색 결과를 볼 때 ‘맞는 것만 골랐는가’와 ‘빼먹은 것은 없는가’를 함께 묻는 것, 그것이 정보 검색 이해의 첫걸음입니다.