
쉬운 일이 가장 어렵다, 모라벡의 역설(Moravec’s Paradox)
문 앞까지가 가장 어렵다, 라스트 마일 배송(Last-Mile Delivery)
책 한 권을 펼쳐 단어를 하나하나 세어 보면 이상한 쏠림이 나타납니다. ‘그리고’, ‘있다’, ‘것’ 같은 몇몇 단어는 페이지마다 쉴 새 없이 등장하지만, 대부분의 단어는 책 전체에서 한두 번 나오고 사라집니다. 그런데 이 쏠림은 제멋대로가 아니라 놀라울 만큼 일정한 비율을 따릅니다. 이 규칙을 가리키는 말이 바로 ‘지프의 법칙(Zipf’s Law)’입니다.
지프의 법칙이란 쉽게 말해 ‘단어를 많이 쓰이는 순서대로 줄 세우면, 각 단어가 쓰이는 횟수는 순위에 반비례한다’는 경험 법칙을 의미합니다. 브래드퍼드의 법칙, 로트카의 법칙과 함께 계량서지학의 3대 법칙으로 꼽히며, 오늘날 검색 엔진과 색인 기술의 바탕에도 깔려 있습니다.
본 자료에서는 지프의 법칙이 어떻게 알려졌는지, 법칙의 내용과 그 원인에 대한 설명, 그리고 도서관과 정보 검색에서의 쓰임과 한계까지 차례로 살펴보겠습니다.
지프의 법칙으로 읽는 단어의 질서
지프의 법칙이란 무엇인가?
이 법칙의 이름은 미국의 언어학자 조지 킹즐리 지프(George Kingsley Zipf)에게서 왔습니다. 하버드 대학교에서 독일어를 가르치던 그는 1930년대에 여러 언어의 글에서 단어가 나오는 횟수를 세어, 순위와 빈도 사이의 단순한 관계를 정리했습니다.
다만 지프가 이 관계를 처음 발견한 것은 아닙니다. 프랑스의 속기사 장바티스트 에스투(Jean-Baptiste Estoup)가 1916년에 이미 같은 현상을 기록했고, 지프 자신도 이를 인정했습니다. 그럼에도 이 규칙을 여러 언어와 분야로 넓혀 알린 사람이 지프였기에, 오늘날까지 그의 이름으로 불립니다.
지프는 1949년 『인간 행동과 최소 노력의 원칙(Human Behavior and the Principle of Least Effort)』이라는 책에서 이 생각을 사람의 행동 전반으로 확장했습니다.
이 규칙은 단어에만 머물지 않습니다. 1913년 독일의 물리학자 펠릭스 아우어바흐(Felix Auerbach)는 도시를 인구 순으로 세우면 인구가 순위에 반비례한다는 점을 먼저 관찰했고, 뒷날 기업의 크기와 음악의 음표 빈도 같은 여러 자료에서도 비슷한 모양이 확인되었습니다.
순위와 빈도의 반비례
지프의 법칙은 아주 간단한 비율로 나타낼 수 있습니다. 가장 많이 쓰이는 단어의 횟수를 기준으로 삼으면, 나머지 단어의 횟수는 순위의 숫자로 나눈 값과 비슷해집니다.
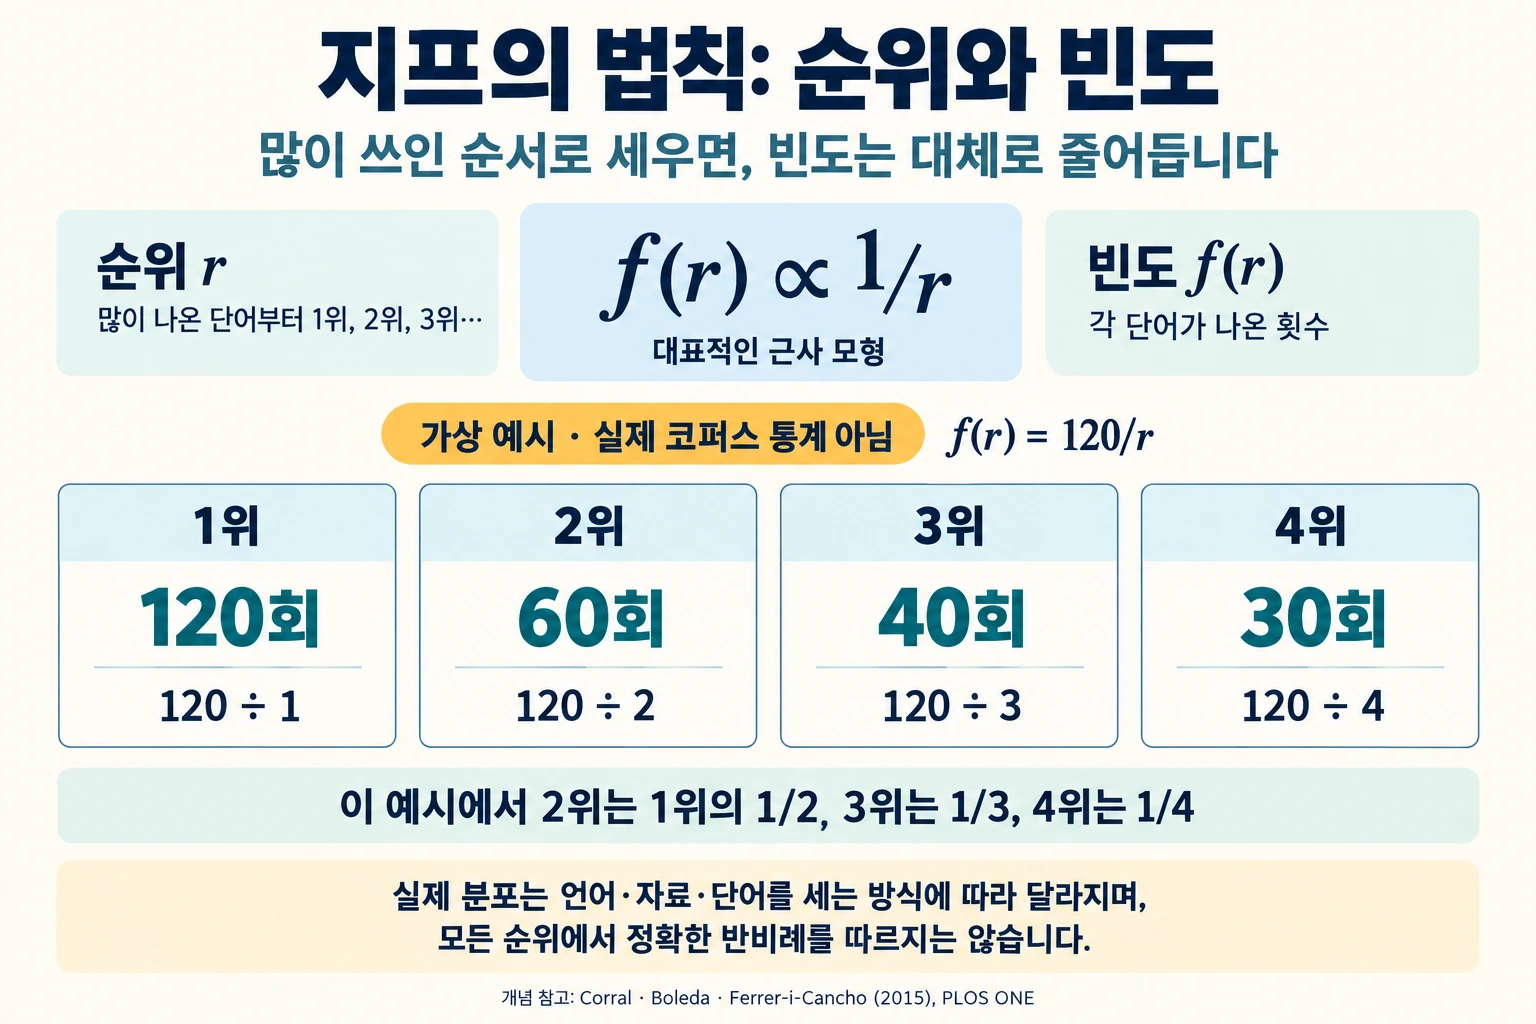
(1) 1위 단어
가장 흔한 단어가 기준이 됩니다. 약 100만 단어로 이루어진 미국 영어 자료 모음인 브라운 코퍼스(Brown Corpus)에서는 ‘the’가 6만 9,971번 나와 전체의 7% 가까이를 차지합니다.
(2) 2위 단어
1위의 절반쯤 쓰입니다. 브라운 코퍼스의 2위인 ‘of’는 3만 6,411번으로 전체의 3.5%를 조금 넘습니다.
(3) 3위 이하의 단어
3위는 1위의 3분의 1, 10위는 10분의 1 정도로 줄어듭니다. 이렇게 앞쪽에 쏠린 결과, 이 자료에서는 단 135개의 단어가 전체 단어 사용량의 절반을 차지합니다.
가로축과 세로축을 모두 로그 눈금으로 바꾸어 그래프를 그리면, 이 관계는 오른쪽 아래로 내려가는 거의 곧은 직선으로 나타납니다.
지프는 이 현상을 최소 노력의 원칙으로 설명했습니다. 말하는 사람은 적은 수의 단어로 많은 뜻을 전하려 하고, 듣는 사람은 뜻이 분명한 다양한 단어를 원하는데, 두 힘이 균형을 이루면서 이런 분포가 생긴다는 것입니다.
도서관과 정보 검색에서의 쓰임
지프의 법칙은 글 속의 어떤 단어가 내용을 잘 드러내는지 가려내는 데 쓰입니다. 너무 흔한 단어는 어느 글에나 나오고, 너무 드문 단어는 우연히 끼어든 경우가 많기 때문입니다.
- 불용어 목록(Stop Word List): 조사나 관사처럼 빈도가 가장 높은 단어를 색인에서 미리 빼, 저장 공간과 검색 시간을 줄입니다.
- 핵심어 추출(Keyword Extraction): 1958년 IBM의 한스 페터 룬(Hans Peter Luhn)은 너무 흔한 단어와 너무 드문 단어를 잘라 내고 가운데 빈도의 단어를 핵심어로 골라, 컴퓨터로 논문 요약문을 만드는 실험을 했습니다.
- 저자 판별(Authorship Attribution): 사람마다 단어를 쓰는 빈도의 모양이 비교적 일정해, 글쓴이가 누구인지 가려내는 근거로 쓰입니다.
- 장서와 색인 계획(Collection and Index Planning): 소수의 자료와 용어에 이용이 몰린다는 점을 알면, 자주 찾는 것부터 갖추고 정리하는 기준을 세울 수 있습니다.
저자마다 논문 수가 쏠리는 로트카의 법칙은 수학적으로 지프의 법칙과 같은 집안의 분포로 설명되고, 소수의 학술지에 논문이 몰리는 브래드퍼드의 법칙도 비슷한 쏠림을 보여 줍니다. 계량서지학의 세 법칙이 함께 묶이는 까닭이 여기에 있습니다.
지프의 법칙을 읽을 때의 주의점
지프의 법칙은 놀라울 만큼 자주 들어맞지만, 정확한 자연법칙이라기보다 경험에서 얻은 근사치입니다. 그래서 쓰는 사람이 몇 가지 한계를 함께 알아 두어야 합니다.
자주 지적되는 한계
- 양 끝의 어긋남(Deviation at the Extremes): 순위가 가장 높은 단어들과 가장 낮은 단어들에서는 실제 빈도가 이상적인 비율과 꽤 다르게 나옵니다.
- 언어별 차이(Language Differences): 중국어나 베트남어처럼 한 음절이 하나의 의미 단위가 되는 언어는 법칙에서 크게 벗어나기도 합니다.
- 원인에 대한 논쟁(Debate over Causes): 글자를 무작위로 찍어 만든 엉터리 글에서도 비슷한 분포가 나와, 최소 노력의 원칙만으로는 설명이 부족하다는 지적이 있습니다.
실제로 영어 글 3만 편을 분석한 연구에서는 법칙을 어떻게 정의하느냐에 따라 잘 들어맞는 글의 비율이 약 15%에서 40%까지 달라졌습니다. 누적 분포를 기준으로 삼으면 약 40%였지만, 그래도 절반에는 미치지 못했습니다. 법칙은 방향을 알려 주는 지도일 뿐, 모든 글의 정답은 아닌 셈입니다.
지프의 법칙은 우리가 쓰는 말이 소수의 단어에 크게 기대고 있다는 사실을 단순한 비율로 보여 줍니다. 약 90년 전 손으로 단어를 세어 얻은 이 규칙은 지금도 불용어 처리와 핵심어 추출처럼 정보를 다루는 기술 곳곳에 살아 있습니다.
흔한 단어와 드문 단어 사이에서 정말 의미 있는 말을 가려내는 것, 그것이 정보 검색의 첫걸음입니다.