
지구 반대편에 드리운 지진의 그늘, 지진파 암영대(Seismic Shadow Zone)
설문지에 ‘지난 1년 동안 세금을 덜 낸 적이 있습니까?’라는 질문이 있다면 몇 명이나 솔직하게 ‘예’라고 적을까요? 민감한 질문 앞에서 사람들은 거짓으로 답하거나 아예 답을 피하기 쉽고, 그 결과 조사 수치는 실제보다 낮게 나오기 마련입니다. 통계학은 이 문제를 동전 하나로 풀어내는 방법을 찾아냈는데, 이를 ‘무작위 응답 기법(Randomized Response Technique)’이라고 부릅니다.
무작위 응답 기법이란 쉽게 말해 ‘응답자가 우연 장치의 결과에 따라 답하게 해서 한 사람의 진짜 답은 숨기고 집단 전체의 비율만 계산해 내는 설문 방법’을 의미합니다. 1965년 미국의 통계학자 스탠리 L. 워너(Stanley L. Warner)가 『미국통계학회지(Journal of the American Statistical Association)』에 발표한 논문 「무작위 응답: 회피성 응답 편향을 없애는 조사 기법」에서 처음 제안했습니다.
본 자료에서는 민감한 질문이 조사를 흔드는 이유, 동전 하나로 답을 숨기는 원리, 흩어진 답에서 진짜 비율을 계산하는 방법, 그리고 오늘날 개인 정보 보호 기술로 이어진 쓰임새까지 차례로 살펴보겠습니다.
숨긴 답에서 진실을 찾는 설문, 무작위 응답 기법
1. 민감한 질문이 조사를 흔드는 이유
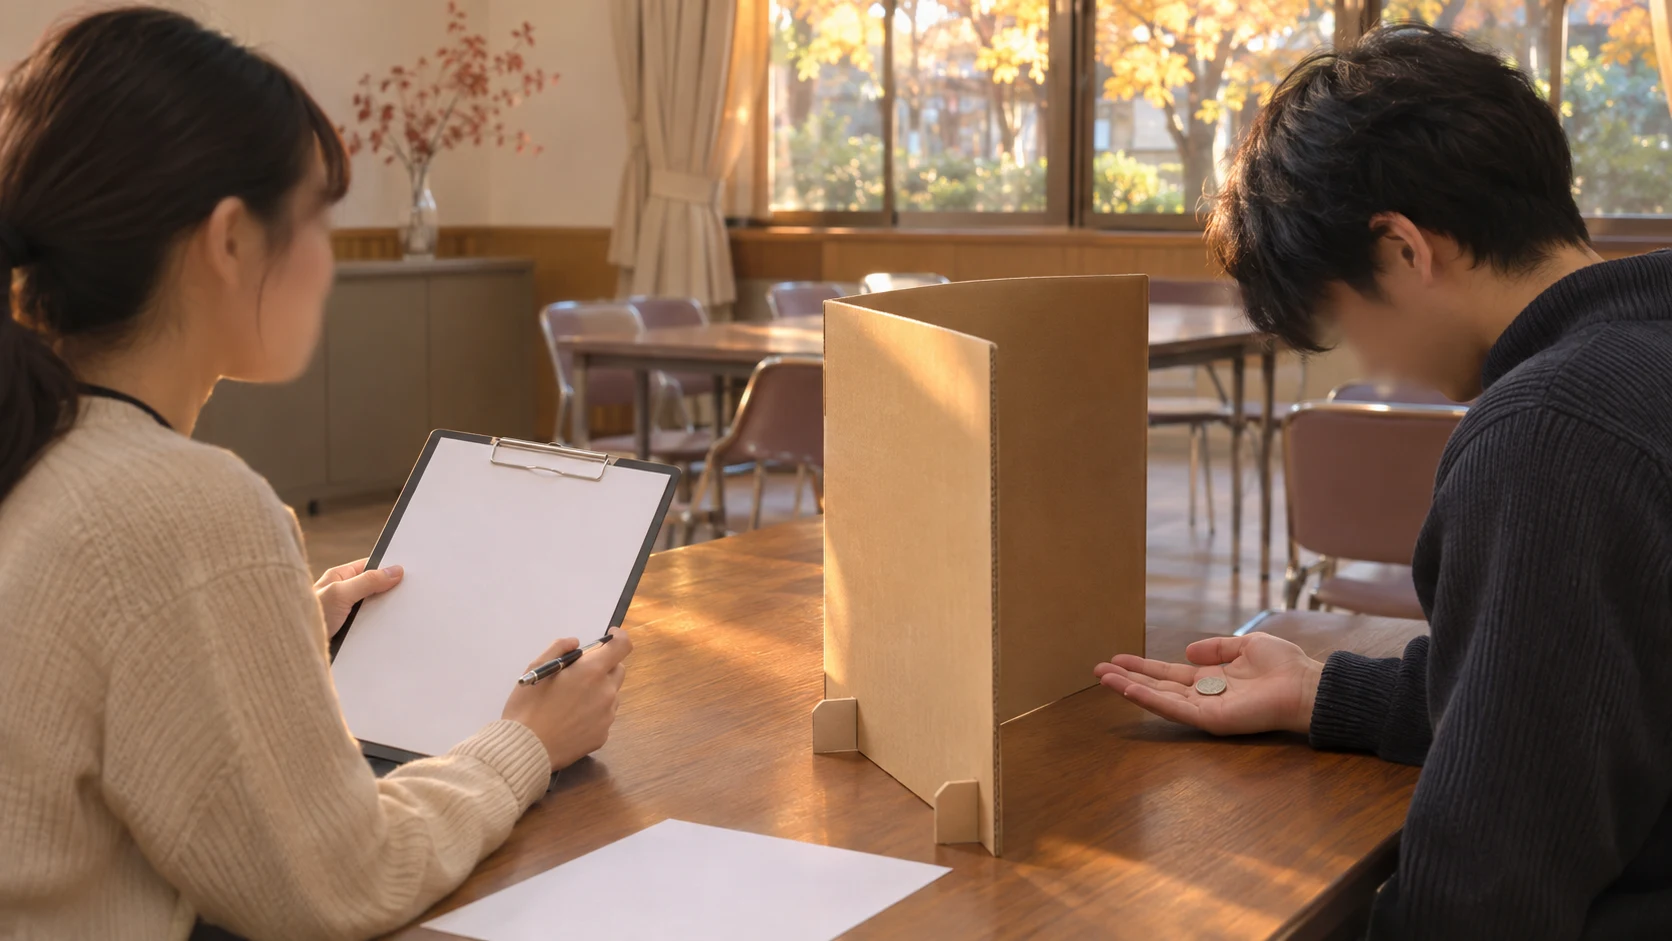
설문 조사는 사람들이 사실대로 답한다는 믿음 위에 서 있습니다. 하지만 불법 행위, 건강 문제, 소득처럼 남에게 알리고 싶지 않은 주제에서는 이 믿음이 쉽게 무너집니다.
(1) 사회적 바람직성 편향
사회적 바람직성 편향(Social Desirability Bias)은 응답자가 실제 모습보다 남들이 좋게 볼 만한 쪽으로 답하는 경향입니다. 바람직하지 않은 행동은 줄여 말하고, 칭찬받을 만한 행동은 부풀려 말하게 됩니다.
(2) 응답 거부
아예 답하지 않는 무응답도 문제입니다. 민감한 행동을 한 사람일수록 답을 피할 가능성이 높아서, 남은 응답만으로 계산하면 결과가 한쪽으로 치우칩니다.
(3) 익명만으로는 부족한 이유
이름을 쓰지 않는 익명 설문이라도 응답자는 조사자가 자신의 답을 알아볼 수 있다고 느낄 수 있습니다. 워너는 답 자체가 한 사람에 대해 아무것도 증명하지 못하게 만들어야 솔직한 답을 얻을 수 있다고 보았습니다.
2. 동전 하나로 답을 숨기는 원리
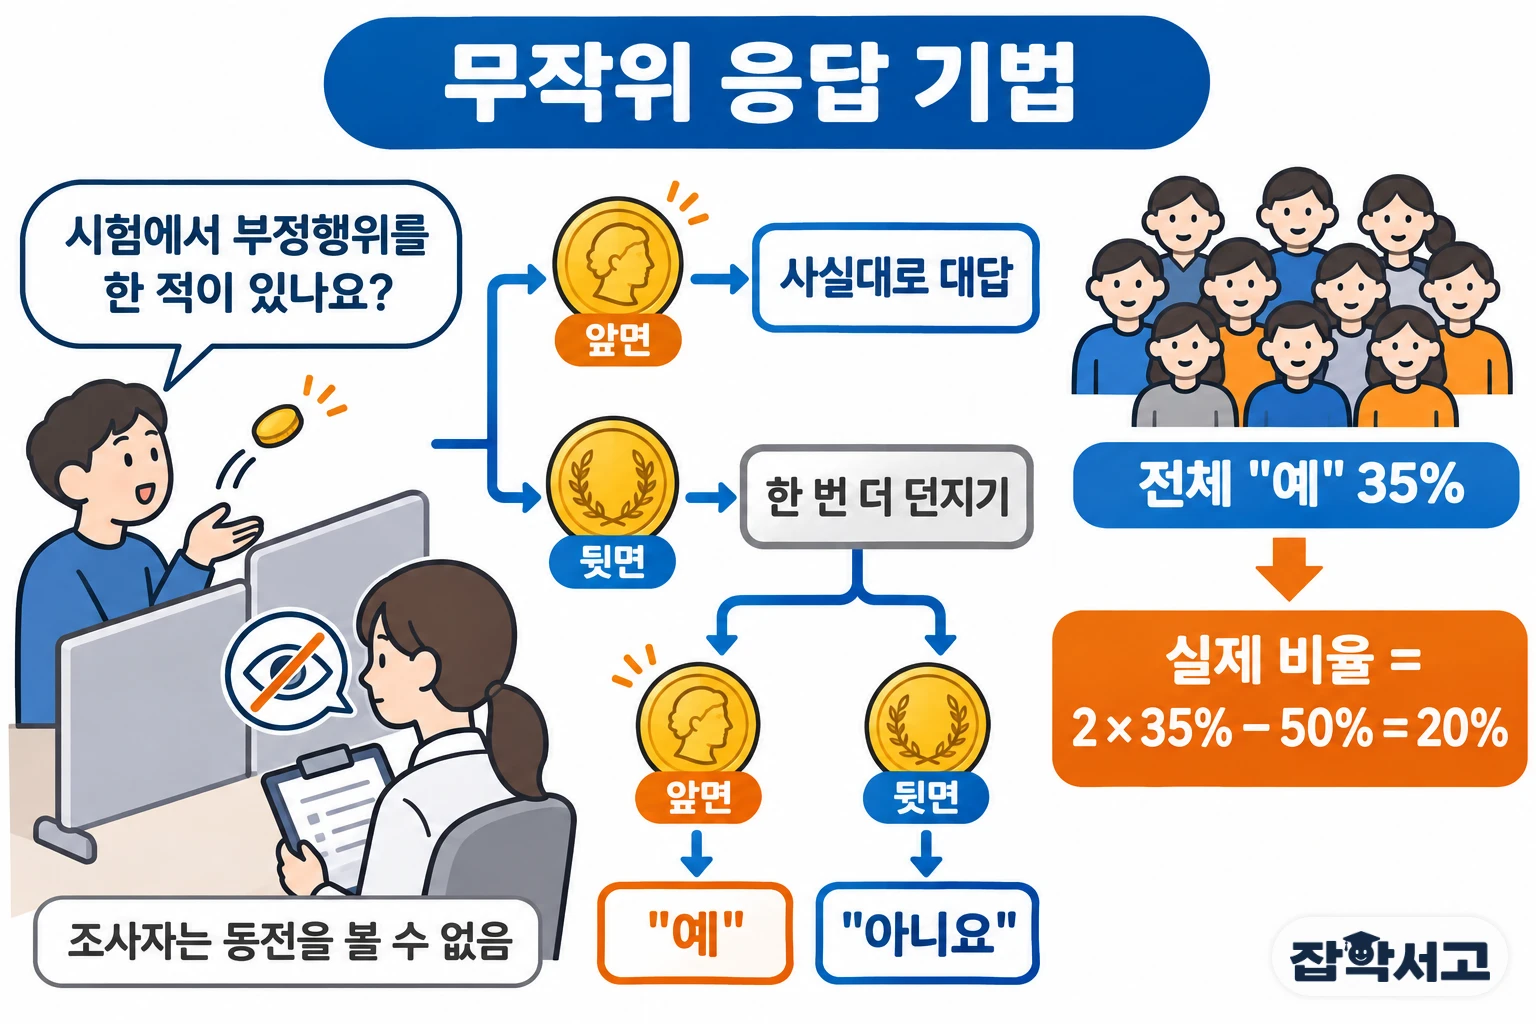
무작위 응답 기법의 핵심은 응답자만 아는 우연의 결과를 질문과 답 사이에 끼워 넣는 것입니다. 가장 널리 알려진 방식은 동전을 한 번 또는 두 번 던지는 강제 응답 방식입니다.
- 강제 응답 방식(Forced Response Design): 우연 장치의 결과에 따라 사실대로 답하거나 정해진 답을 말하게 하는 방식
- 워너 방식(Warner’s Model): 우연 장치에 따라 ‘A 집단에 속합니까?’와 ‘A 집단에 속하지 않습니까?’ 중 하나에 답하게 하는 처음 방식
- 무관한 질문 방식(Unrelated Question Design): 우연 장치에 따라 민감한 질문 대신 ‘생일이 짝수 달입니까?’처럼 관계없는 질문에 답하게 하는 방식
(1) 동전은 응답자만 본다
응답자는 가림막 뒤에서 동전을 던지고 결과를 아무에게도 보여 주지 않습니다. 첫 번째 동전이 앞면이면 질문에 사실대로 답합니다.
(2) 뒷면이면 정해진 답
첫 번째 동전이 뒷면이면 한 번 더 던져 앞면이면 ‘예’, 뒷면이면 ‘아니요’라고 답합니다. 이때의 답은 질문 내용과 아무 관계가 없습니다.
(3) ‘예’라고 해도 증거가 되지 않는다
조사자는 어떤 사람의 ‘예’가 진짜 고백인지 동전이 시킨 답인지 알 수 없습니다. 응답자도 이 사실을 알기 때문에 부담을 덜고 사실대로 답할 수 있습니다.
3. 흩어진 답에서 진짜 비율을 계산하는 법
한 사람의 답은 흐려졌지만 동전이 앞면과 뒷면을 낼 확률은 정확히 알려져 있습니다. 이 확률을 이용하면 집단 전체의 진짜 비율을 거꾸로 계산할 수 있습니다.
(1) 확률로 세우는 식
실제로 그 행동을 한 사람의 비율을 π라고 하면, ‘예’가 나올 확률은 사실대로 답하는 경우의 1/2 × π에 동전이 ‘예’를 시키는 경우의 1/4을 더한 값입니다. 따라서 전체 ‘예’ 비율은 π/2 + 1/4이 됩니다.
(2) 거꾸로 풀기
식을 정리하면 π = 2 × (전체 ‘예’ 비율) − 1/2입니다. 1,000명 가운데 350명, 즉 35%가 ‘예’라고 답했다면 실제 비율은 2 × 35% − 50% = 20%로 추정됩니다.
(3) 치러야 할 대가
답에 일부러 잡음을 섞은 만큼 추정값의 오차는 커집니다. 직접 묻는 조사와 같은 정확도를 얻으려면 훨씬 많은 사람에게 물어야 하고, 응답자가 규칙을 이해하지 못하거나 지키지 않으면 결과가 다시 흔들립니다.
4. 개인 정보 보호 기술로 이어진 무작위 응답
한 사람의 답은 숨기면서 집단의 모습만 정확히 알아낸다는 생각은 설문 조사를 넘어 디지털 시대의 개인 정보 보호 기술로 이어졌습니다.
(1) 민감한 주제의 조사
무작위 응답 기법은 약물 사용, 시험 부정행위, 탈세처럼 직접 묻기 어려운 주제를 조사할 때 쓰여 왔습니다. 연구자들은 같은 주제를 직접 질문한 결과와 비교해 응답 편향이 얼마나 큰지 살피기도 합니다.
(2) 차등 프라이버시
차등 프라이버시(Differential Privacy)는 계산된 잡음을 더해 특정 개인의 데이터가 포함되었는지가 결과에 거의 영향을 주지 않도록 하는 개인 정보 보호 개념입니다. 사용자가 자기 데이터에 직접 잡음을 섞어 보내는 방식은 무작위 응답 기법과 같은 원리를 따릅니다.
(3) 구글의 RAPPOR
2014년 구글은 크롬 브라우저의 사용 통계를 모으는 기술 RAPPOR를 공개했습니다. 각 사용자의 기기가 보고 내용을 무작위로 바꿔 보내기 때문에 한 사람의 설정은 알 수 없지만, 많은 보고를 모으면 전체 경향은 파악할 수 있습니다.
무작위 응답 기법은 개인의 비밀을 지키는 일과 사회 전체의 진실을 아는 일이 서로 부딪히지 않을 수 있음을 보여 줍니다. 한 사람의 답은 몰라도 많은 사람의 답이 모이면 진실이 드러난다는 단순한 생각, 그것이 무작위 응답 기법 이해의 첫걸음입니다.
이 글 PDF 구매
1,000원한국어 PDF · 같은 계정으로 다시 다운로드할 수 있어요.
PDF 구매 옵션 보기
함께 읽을 책
이 자료의 핵심 키워드와 연결된 책입니다.