
망치를 들면 모든 것이 못으로 보인다, 도구의 법칙(Law of the Instrument)
지구 반대편에 드리운 지진의 그늘, 지진파 암영대(Seismic Shadow Zone)
편지 한 장을 두 사람이 받았는데 한 사람은 왼쪽부터, 다른 사람은 오른쪽부터 읽는다면 어떻게 될까요? 컴퓨터 세계에서는 실제로 이런 일이 벌어집니다. 여러 바이트로 된 숫자를 메모리에 어떤 순서로 놓을지가 컴퓨터마다 다르기 때문인데, 이 순서를 가리키는 말이 바로 ‘엔디언(Endianness)’입니다.
엔디언이란 쉽게 말해 ‘여러 바이트로 이루어진 값을 메모리에 저장하거나 전송할 때 어느 쪽 바이트부터 놓을지 정한 순서’를 의미합니다. 이 이름은 1726년 조너선 스위프트(Jonathan Swift)의 소설 『걸리버 여행기(Gulliver’s Travels)』에서 왔습니다. 소설 속 릴리퍼트와 블레퍼스큐 사람들은 삶은 달걀을 큰 쪽(big end)부터 깰지 작은 쪽(little end)부터 깰지를 두고 전쟁까지 벌입니다. 1980년 컴퓨터 과학자 대니 코언(Danny Cohen)은 글 「성전에 대하여, 그리고 평화를 위한 호소(On Holy Wars and a Plea for Peace)」에서 바이트 순서 논쟁을 이 달걀 전쟁에 빗대며 빅 엔디언·리틀 엔디언이라는 말을 퍼뜨렸습니다.
본 자료에서는 엔디언이 생겨난 이유, 빅 엔디언과 리틀 엔디언의 차이, 엔디언이 다른 컴퓨터가 만날 때 생기는 문제, 그리고 오늘날 엔디언을 다루는 방법까지 차례로 살펴보겠습니다.
달걀을 어느 쪽부터 깰 것인가, 엔디언
1. 엔디언은 왜 생겨났을까
컴퓨터 메모리는 바이트(8비트) 단위로 주소가 붙어 있습니다. 그런데 정수 하나는 보통 2바이트, 4바이트, 8바이트처럼 여러 바이트를 차지합니다. 그래서 한 값을 여러 칸에 나눠 담을 때 어느 바이트를 먼저 둘지 정해야 하는 문제가 생깁니다.
(1) 바이트 단위 주소
메모리의 각 칸에는 0, 1, 2…처럼 주소가 하나씩 붙고, 한 칸에는 1바이트만 들어갑니다. 4바이트 정수 하나를 저장하려면 이어진 네 칸이 필요합니다.
(2) 큰 자리와 작은 자리
16진수 0x12345678에서 12는 가장 큰 자리를 맡은 최상위 바이트이고, 78은 가장 작은 자리를 맡은 최하위 바이트입니다. 이 네 바이트를 낮은 주소부터 어떤 순서로 놓을지가 바로 엔디언입니다.
(3) 정답이 없는 선택
어느 순서든 한 컴퓨터 안에서 일관되게 쓰기만 하면 계산 결과는 같습니다. 그래서 초기 컴퓨터 회사들은 각자 설계에 유리한 쪽을 골랐고, 이 차이가 오늘날까지 이어지고 있습니다.
2. 빅 엔디언과 리틀 엔디언의 차이
0x12345678을 주소 100번부터 네 칸에 저장한다고 해 보겠습니다. 빅 엔디언 방식은 100번부터 12, 34, 56, 78 순서로 놓고, 리틀 엔디언 방식은 거꾸로 78, 56, 34, 12 순서로 놓습니다.
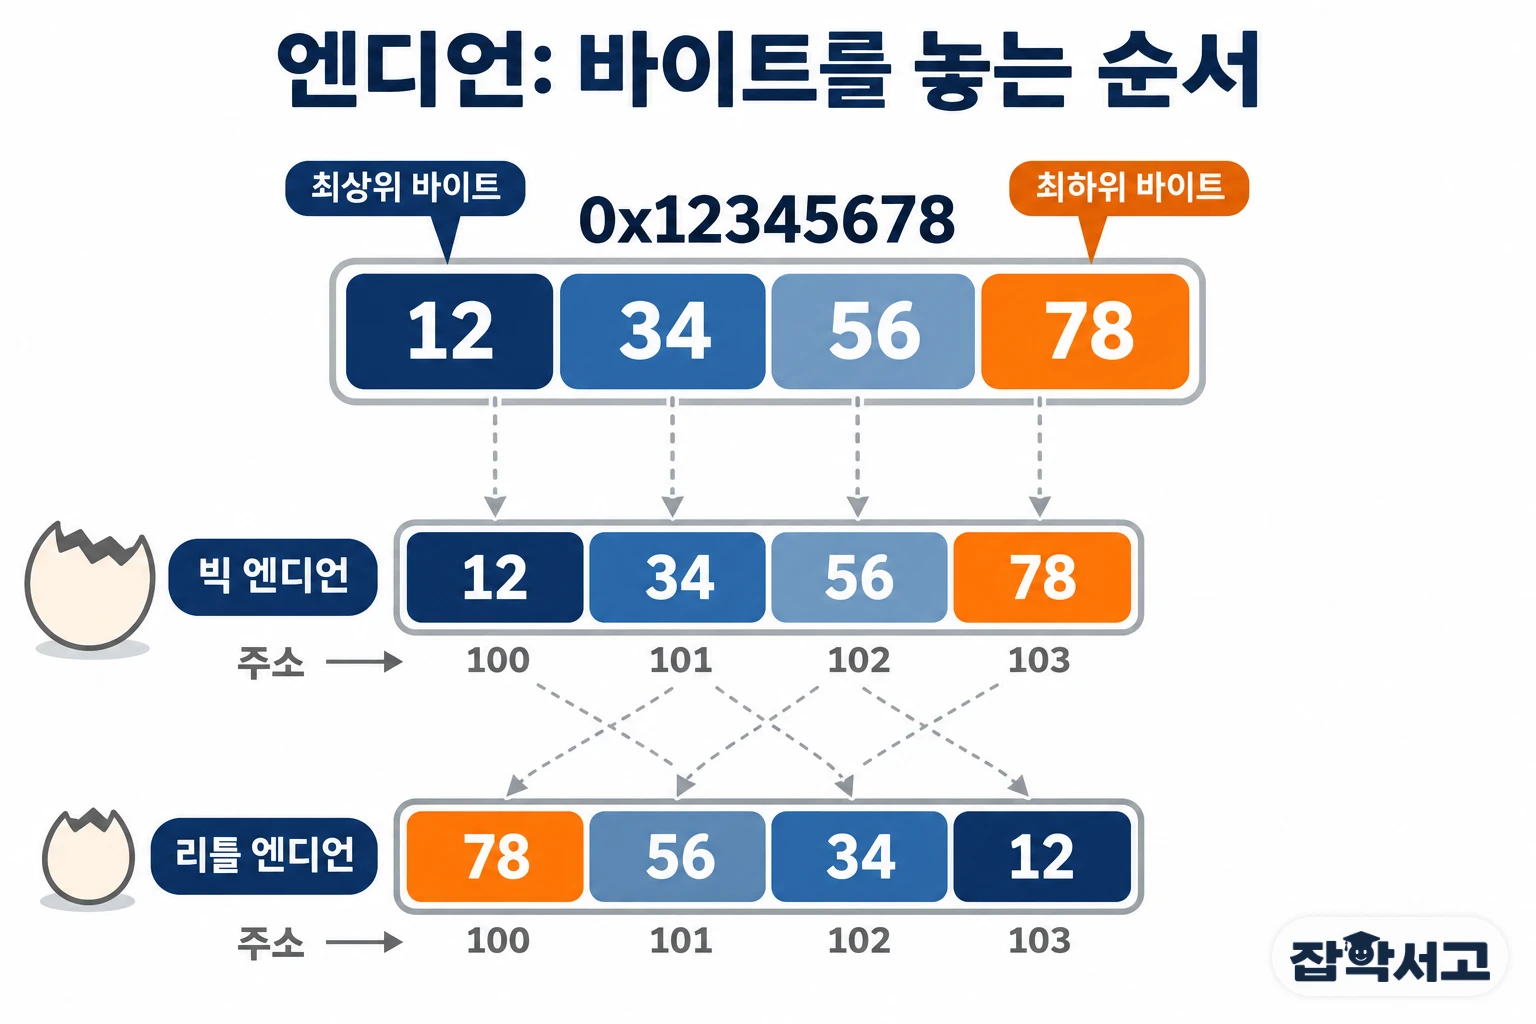
- 빅 엔디언(Big-endian): 최상위 바이트를 가장 낮은 주소에 두는 방식으로, 사람이 숫자를 쓰는 순서와 같습니다.
- 리틀 엔디언(Little-endian): 최하위 바이트를 가장 낮은 주소에 두는 방식으로, 인텔 x86 계열 프로세서가 사용합니다.
- 바이 엔디언(Bi-endian): 두 방식을 모두 지원하는 설계로, ARM과 파워PC(PowerPC) 등이 해당합니다.
- 최상위 바이트(Most Significant Byte): 값에서 가장 큰 자리를 맡은 바이트로, 줄여서 MSB라고도 씁니다.
(1) 빅 엔디언의 장점
메모리 내용을 앞에서부터 그대로 보면 숫자가 쓰는 순서대로 읽혀 사람이 확인하기 쉽습니다. IBM 메인프레임과 모토로라 68000 같은 프로세서가 이 방식을 썼습니다.
(2) 리틀 엔디언의 장점
낮은 주소에 작은 자리가 있어서 같은 주소에서 1바이트, 2바이트, 4바이트로 읽어도 값의 아래쪽 부분이 그대로 맞습니다. 작은 자리부터 올림을 계산하는 덧셈에도 자연스럽습니다.
(3) 비트 순서와는 별개
엔디언은 보통 바이트를 놓는 순서를 말합니다. 한 바이트 안의 비트 순서는 프로세서가 바이트를 한 덩어리로 다루기 때문에 프로그램에서 신경 쓸 일이 거의 없습니다.
3. 엔디언이 다른 컴퓨터가 만나면
한 컴퓨터 안에서는 엔디언이 거의 드러나지 않습니다. 문제는 데이터를 파일이나 네트워크로 엔디언이 다른 컴퓨터에 넘길 때 생깁니다.
(1) 뒤집혀 읽히는 숫자
리틀 엔디언 컴퓨터가 정수 1을 4바이트로 저장하면 01 00 00 00이 됩니다. 이 바이트를 빅 엔디언 컴퓨터가 그대로 읽으면 0x01000000, 즉 16,777,216이라는 엉뚱한 값이 됩니다.
(2) NUXI 문제
16비트 단위로 리틀 엔디언을 쓰던 PDP-11의 데이터를 다른 방식의 기계로 옮기면 ‘UNIX’라는 글자가 ‘NUXI’로 읽히는 일이 있었습니다. 두 바이트씩 짝이 뒤바뀐 것으로, 이 이름은 바이트 순서 문제를 가리키는 별명이 되었습니다.
(3) 찾기 어려운 버그
같은 기종끼리 시험할 때는 멀쩡하다가 다른 기종과 연결할 때만 값이 틀어지기 때문에, 원인을 찾는 데 오랜 시간이 걸리곤 합니다.
4. 오늘날 엔디언을 다루는 방법
엔디언의 차이를 없앨 수는 없기에, 개발자들은 데이터를 주고받을 때의 순서를 미리 약속하는 방식으로 문제를 풉니다.
(1) 네트워크 바이트 순서
인터넷 프로토콜(TCP/IP)은 빅 엔디언을 표준 순서로 정했습니다. 그래서 C 언어 등에서는 htonl(host to network long), ntohl 같은 함수로 보내기 전과 받은 뒤에 순서를 바꿉니다.
(2) 형식이 정한 순서
자바(Java) 클래스 파일은 빅 엔디언으로 정해져 있고, 문자 인코딩 UTF-16은 맨 앞에 바이트 순서 표시(BOM)를 붙여 FE FF면 빅 엔디언, FF FE면 리틀 엔디언임을 알립니다.
(3) 리틀 엔디언의 우세
x86과 대부분의 ARM 기기가 리틀 엔디언으로 동작하면서 오늘날 개인용 컴퓨터와 스마트폰은 사실상 리틀 엔디언이 주류가 되었습니다. 그래도 네트워크와 여러 파일 형식에는 빅 엔디언이 남아 있어 변환은 여전히 필요합니다.
달걀을 어느 쪽부터 깨든 달걀 맛은 같듯이, 엔디언도 어느 쪽이 옳은가의 문제가 아니라 서로 약속을 맞추는 문제입니다. 데이터를 넘기기 전에 순서부터 정해 두자는 단순한 생각, 그것이 엔디언 이해의 첫걸음입니다.
이 글 PDF 구매
1,000원한국어 PDF · 같은 계정으로 다시 다운로드할 수 있어요.