Nếu hai người cùng nhận một lá thư, một người đọc từ trái sang phải còn người kia đọc từ phải sang trái thì chuyện gì sẽ xảy ra? Trong thế giới máy tính, điều tương tự thực sự xảy ra. Đó là vì mỗi loại máy tính đặt các byte của một con số nhiều byte vào bộ nhớ theo thứ tự khác nhau, và từ dùng để chỉ thứ tự này chính là “thứ tự byte (Endianness)”.
Thứ tự byte, nói một cách đơn giản, là “thứ tự quy định byte ở đầu nào được đặt trước khi một giá trị gồm nhiều byte được lưu vào bộ nhớ hoặc truyền đi”. Cái tên này bắt nguồn từ tiểu thuyết Gulliver’s Travels (Gulliver du ký) năm 1726 của Jonathan Swift. Trong truyện, người Lilliput và người Blefuscu gây chiến chỉ vì tranh cãi nên đập quả trứng luộc từ đầu to (big end) hay đầu nhỏ (little end). Năm 1980, nhà khoa học máy tính Danny Cohen trong bài viết “On Holy Wars and a Plea for Peace” (Bàn về những cuộc thánh chiến và lời kêu gọi hòa bình) đã ví cuộc tranh luận về thứ tự byte với cuộc chiến quả trứng này, qua đó phổ biến hai thuật ngữ big-endian và little-endian.
Bài viết này sẽ lần lượt tìm hiểu lý do thứ tự byte ra đời, sự khác nhau giữa big-endian và little-endian, những vấn đề nảy sinh khi các máy tính có thứ tự byte khác nhau gặp nhau, và cách xử lý thứ tự byte ngày nay.
Đập quả trứng từ đầu nào trước: thứ tự byte
1. Vì sao thứ tự byte ra đời
Bộ nhớ máy tính được đánh địa chỉ theo đơn vị byte (8 bit). Thế nhưng một số nguyên thường chiếm nhiều byte, chẳng hạn 2 byte, 4 byte hoặc 8 byte. Vì vậy, khi chia một giá trị vào nhiều ô, cần phải quyết định byte nào được đặt trước.
(1) Địa chỉ theo đơn vị byte
Mỗi ô nhớ có một địa chỉ như 0, 1, 2…, và mỗi ô chỉ chứa được 1 byte. Muốn lưu một số nguyên 4 byte thì cần bốn ô liền nhau.
(2) Hàng cao và hàng thấp
Trong số thập lục phân 0x12345678, 12 là byte cao nhất giữ hàng lớn nhất, còn 78 là byte thấp nhất giữ hàng nhỏ nhất. Việc đặt bốn byte này theo thứ tự nào kể từ địa chỉ thấp chính là thứ tự byte.
(3) Lựa chọn không có đáp án đúng
Dù chọn thứ tự nào, chỉ cần dùng nhất quán bên trong một máy tính thì kết quả tính toán vẫn như nhau. Vì thế các hãng máy tính thời đầu đã tự chọn cách có lợi cho thiết kế của mình, và sự khác biệt đó kéo dài đến tận hôm nay.
2. Sự khác nhau giữa big-endian và little-endian
Giả sử lưu 0x12345678 vào bốn ô bắt đầu từ địa chỉ 100. Cách big-endian đặt từ ô 100 theo thứ tự 12, 34, 56, 78, còn cách little-endian đặt ngược lại theo thứ tự 78, 56, 34, 12.
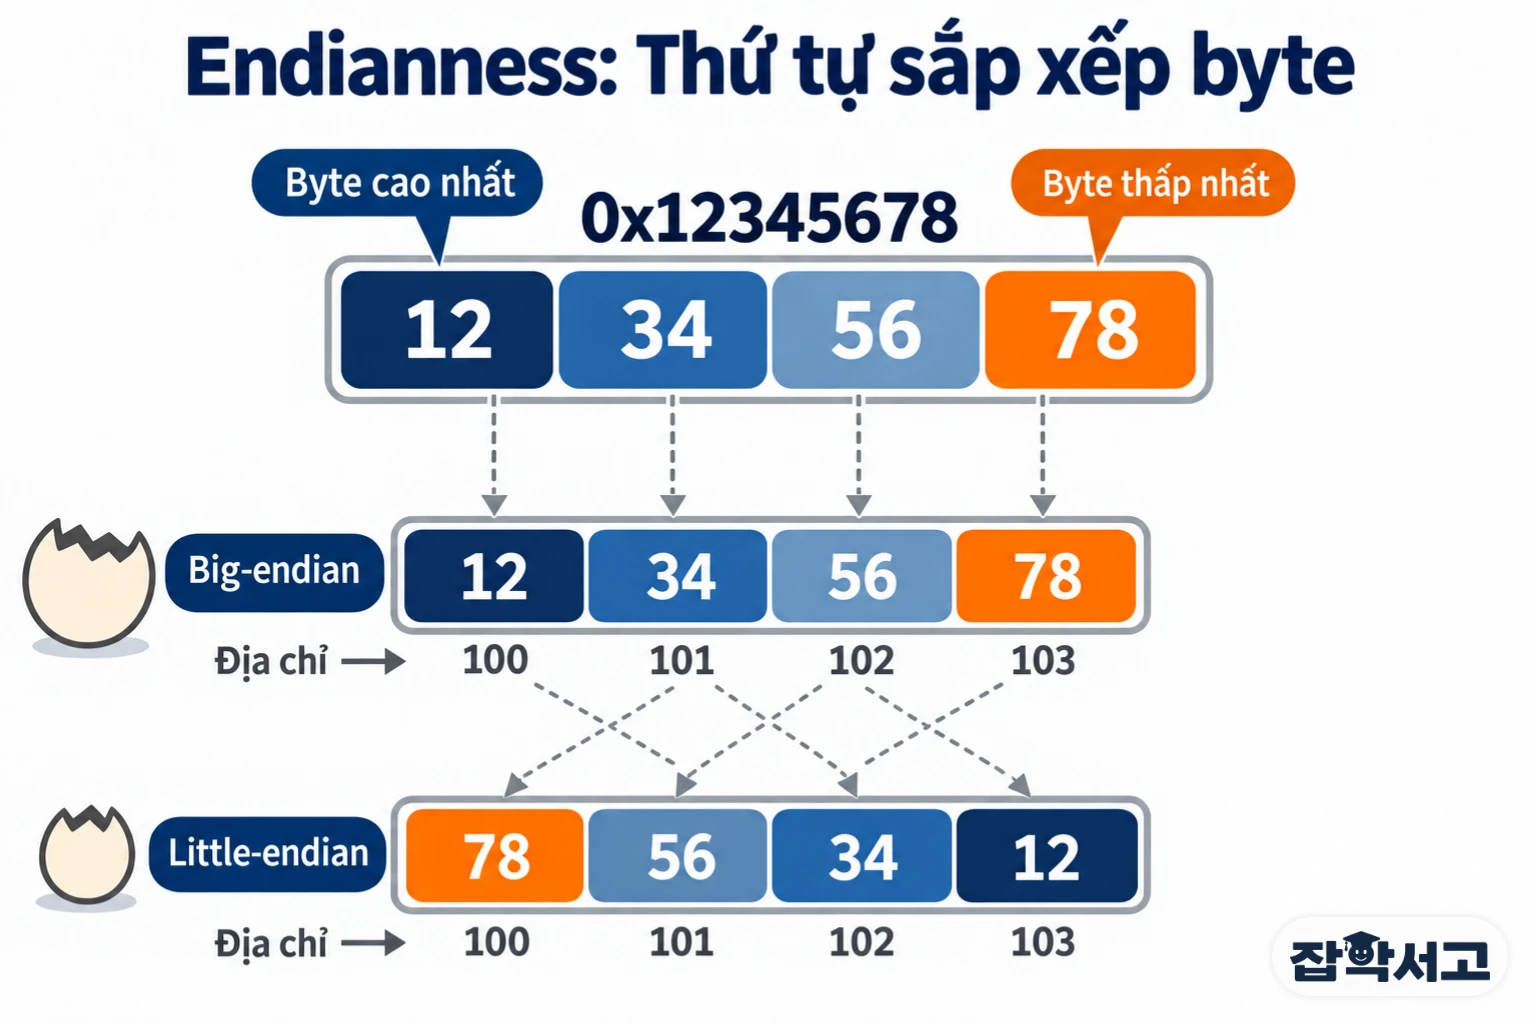
- Big-endian (Big-endian): cách đặt byte cao nhất ở địa chỉ thấp nhất, giống với thứ tự con người viết số.
- Little-endian (Little-endian): cách đặt byte thấp nhất ở địa chỉ thấp nhất, được các bộ xử lý dòng Intel x86 sử dụng.
- Bi-endian (Bi-endian): thiết kế hỗ trợ cả hai cách, chẳng hạn ARM và PowerPC.
- Byte cao nhất (Most Significant Byte): byte giữ hàng lớn nhất trong một giá trị, thường viết tắt là MSB.
(1) Ưu điểm của big-endian
Khi xem nội dung bộ nhớ từ đầu, con số hiện ra đúng theo thứ tự viết nên con người dễ kiểm tra. Các bộ xử lý như máy tính lớn IBM và Motorola 68000 đã dùng cách này.
(2) Ưu điểm của little-endian
Vì hàng nhỏ nằm ở địa chỉ thấp, đọc 1 byte, 2 byte hay 4 byte từ cùng một địa chỉ thì phần thấp của giá trị vẫn khớp. Cách này cũng tự nhiên với phép cộng, vốn tính phần nhớ bắt đầu từ hàng nhỏ.
(3) Khác với thứ tự bit
Thứ tự byte thường chỉ thứ tự đặt các byte. Thứ tự bit bên trong một byte hầu như không cần bận tâm trong chương trình, vì bộ xử lý xử lý mỗi byte như một khối.
3. Khi các máy tính có thứ tự byte khác nhau gặp nhau
Bên trong một máy tính, thứ tự byte gần như không lộ ra. Vấn đề xuất hiện khi dữ liệu được chuyển qua tệp hoặc mạng sang một máy tính có thứ tự byte khác.
(1) Con số bị đọc ngược
Khi một máy tính little-endian lưu số nguyên 1 bằng 4 byte, kết quả là 01 00 00 00. Nếu một máy tính big-endian đọc nguyên trạng các byte này, nó sẽ nhận được 0x01000000, tức giá trị vô lý 16.777.216.
(2) Vấn đề NUXI
Khi chuyển dữ liệu của PDP-11, máy dùng little-endian theo đơn vị 16 bit, sang một máy dùng cách khác, chữ “UNIX” từng bị đọc thành “NUXI”. Đó là do từng cặp hai byte bị đảo chỗ, và cái tên này trở thành biệt danh cho các vấn đề về thứ tự byte.
(3) Lỗi khó tìm
Khi thử giữa các máy cùng loại thì mọi thứ bình thường, chỉ khi kết nối với loại máy khác thì giá trị mới bị sai, nên việc tìm ra nguyên nhân thường mất rất nhiều thời gian.
4. Cách xử lý thứ tự byte ngày nay
Vì không thể xóa bỏ sự khác biệt về thứ tự byte, các nhà phát triển giải quyết vấn đề bằng cách thống nhất trước thứ tự khi trao đổi dữ liệu.
(1) Thứ tự byte mạng
Các giao thức Internet (TCP/IP) chọn big-endian làm thứ tự chuẩn. Vì vậy trong ngôn ngữ C và các môi trường khác, người ta dùng các hàm như htonl (host to network long) và ntohl để đổi thứ tự trước khi gửi và sau khi nhận.
(2) Thứ tự do định dạng quy định
Tệp lớp Java được quy định dùng big-endian, còn bảng mã ký tự UTF-16 gắn dấu thứ tự byte (BOM) ở ngay đầu: FE FF là big-endian, FF FE là little-endian.
(3) Little-endian chiếm ưu thế
Khi x86 và phần lớn thiết bị ARM chạy ở chế độ little-endian, máy tính cá nhân và điện thoại thông minh ngày nay trên thực tế lấy little-endian làm chủ đạo. Dù vậy, big-endian vẫn còn trong mạng và nhiều định dạng tệp, nên việc chuyển đổi vẫn cần thiết.
Cũng như quả trứng đập từ đầu nào thì vị vẫn thế, thứ tự byte không phải chuyện bên nào đúng mà là chuyện thống nhất quy ước với nhau. Ý nghĩ đơn giản rằng hãy định sẵn thứ tự trước khi trao dữ liệu đi, đó chính là bước đầu tiên để hiểu thứ tự byte.