Muchas de las tecnologías de IA con las que interactuamos hoy funcionan gracias al aprendizaje profundo (Deep Learning). El aprendizaje profundo siempre está detrás de los cambios más innovadores de las tecnologías de la información (TI) modernas, como el reconocimiento facial en los teléfonos inteligentes, los servicios de IA generativa, los automóviles autónomos y los traductores en tiempo real.
Sin embargo, cuando nos preguntan «¿Qué es exactamente el aprendizaje profundo?», a menudo nos cuesta explicarlo de inmediato. En este artículo presentamos de forma accesible los conceptos básicos del aprendizaje profundo, sus diferencias con el aprendizaje automático, cómo funciona y algunos ejemplos de aplicaciones reales.
El aprendizaje profundo como tecnología que imita al cerebro humano

El aprendizaje profundo es una rama del aprendizaje automático (Machine Learning), que a su vez forma parte del campo más amplio de la inteligencia artificial (IA).
En el cerebro humano, decenas de miles de millones de células nerviosas (neuronas) forman una compleja red de conexiones que le permite recibir estímulos externos y tomar decisiones. El aprendizaje profundo se basa en redes neuronales artificiales (Artificial Neural Network), que imitan mediante modelos matemáticos la estructura de la red neuronal del cerebro humano.
Se usa el término «profundo» (Deep) porque las capas (Layer) de la red neuronal artificial que procesan los datos de entrada se apilan en sucesivas etapas hasta formar una estructura de gran profundidad (Multi-layered).
La diferencia clave entre el aprendizaje automático y el aprendizaje profundo

Muchas personas usan indistintamente los términos «aprendizaje automático» y «aprendizaje profundo», aunque existe una diferencia clave entre ambas tecnologías. El aprendizaje profundo es una rama del aprendizaje automático que utiliza redes neuronales de varias capas para aprender representaciones de características. Los métodos tradicionales suelen utilizar características diseñadas por personas, aunque también pueden aprender características.
- En un ejemplo de aprendizaje automático tradicional, una persona diseña las características de las imágenes y el modelo aprende las reglas de clasificación a partir de esas características y de los datos de entrenamiento.
- En el aprendizaje profundo basta con proporcionar a la computadora decenas de miles de fotos de gatos y perros. El algoritmo de aprendizaje profundo analiza las imágenes por sí mismo, identifica los patrones y las características distintivas de los gatos y los aprende.
[Una analogía sencilla para comparar la programación tradicional y el aprendizaje profundo]
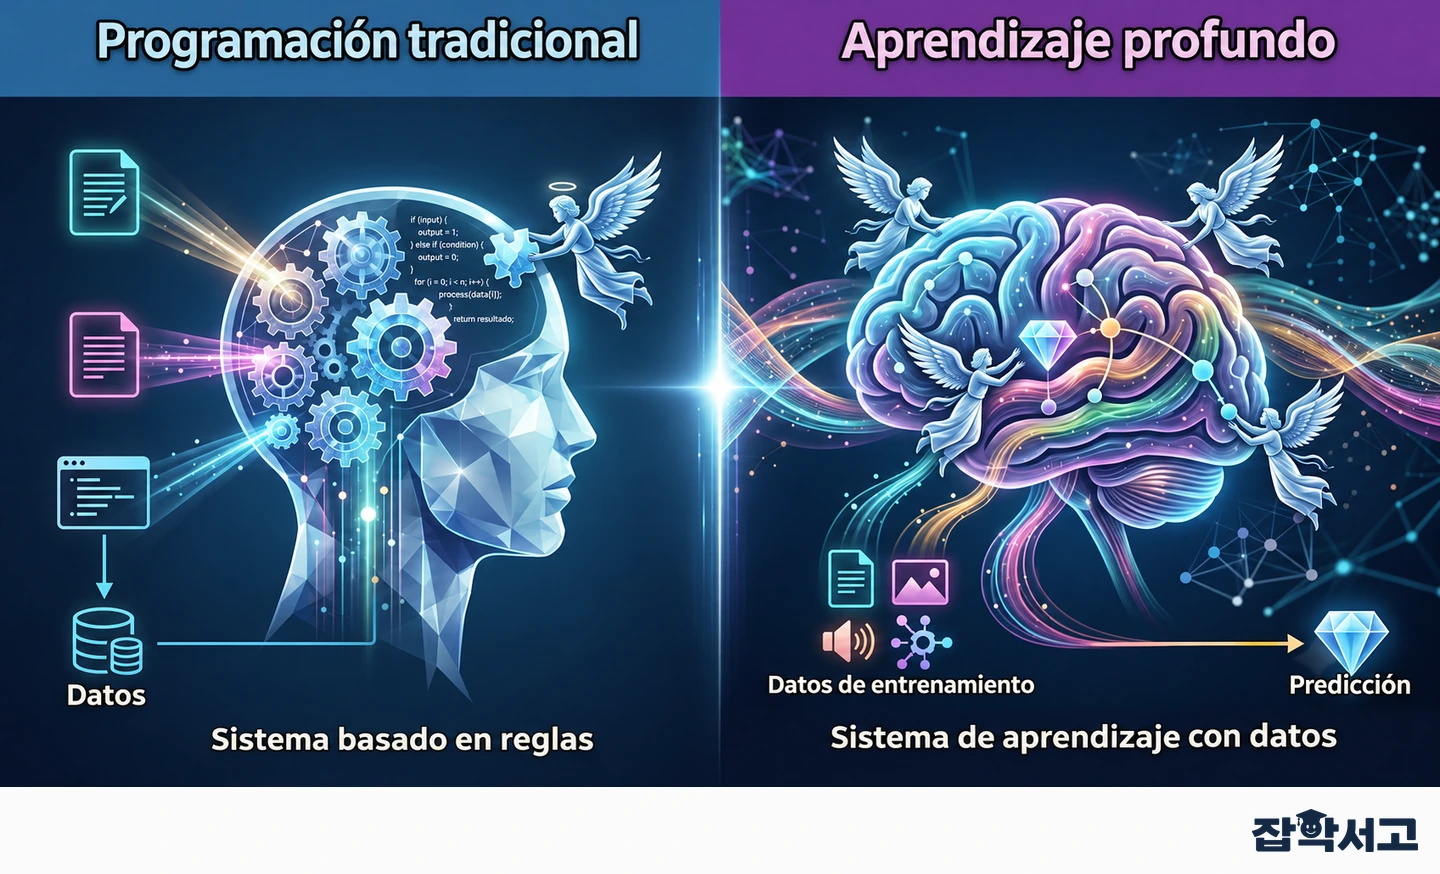
- La programación tradicional ejecuta las reglas que una persona ha especificado, del mismo modo que alguien cocina siguiendo una receta de un libro de cocina.
- El aprendizaje profundo se asemeja a un experto que, tras probar cientos de platos, descubre por sí mismo cómo combinar los ingredientes y regular el fuego, y crea platos nuevos.
¿Cómo aprende un modelo de aprendizaje profundo? (Funcionamiento y ejemplos)
La estructura interna de un modelo de aprendizaje profundo se divide en 3 tipos principales de capas.
a) Capa de entrada (Input Layer). Recibe los datos originales, como imágenes, audio o texto.
b) Capa oculta (Hidden Layer). Extrae las características de los datos y realiza cálculos por etapas. Hay varias capas de este tipo.
c) Capa de salida (Output Layer). Emite la decisión o la predicción final.
[Proceso de aprendizaje paso a paso para reconocer fotos de gatos mediante aprendizaje profundo]
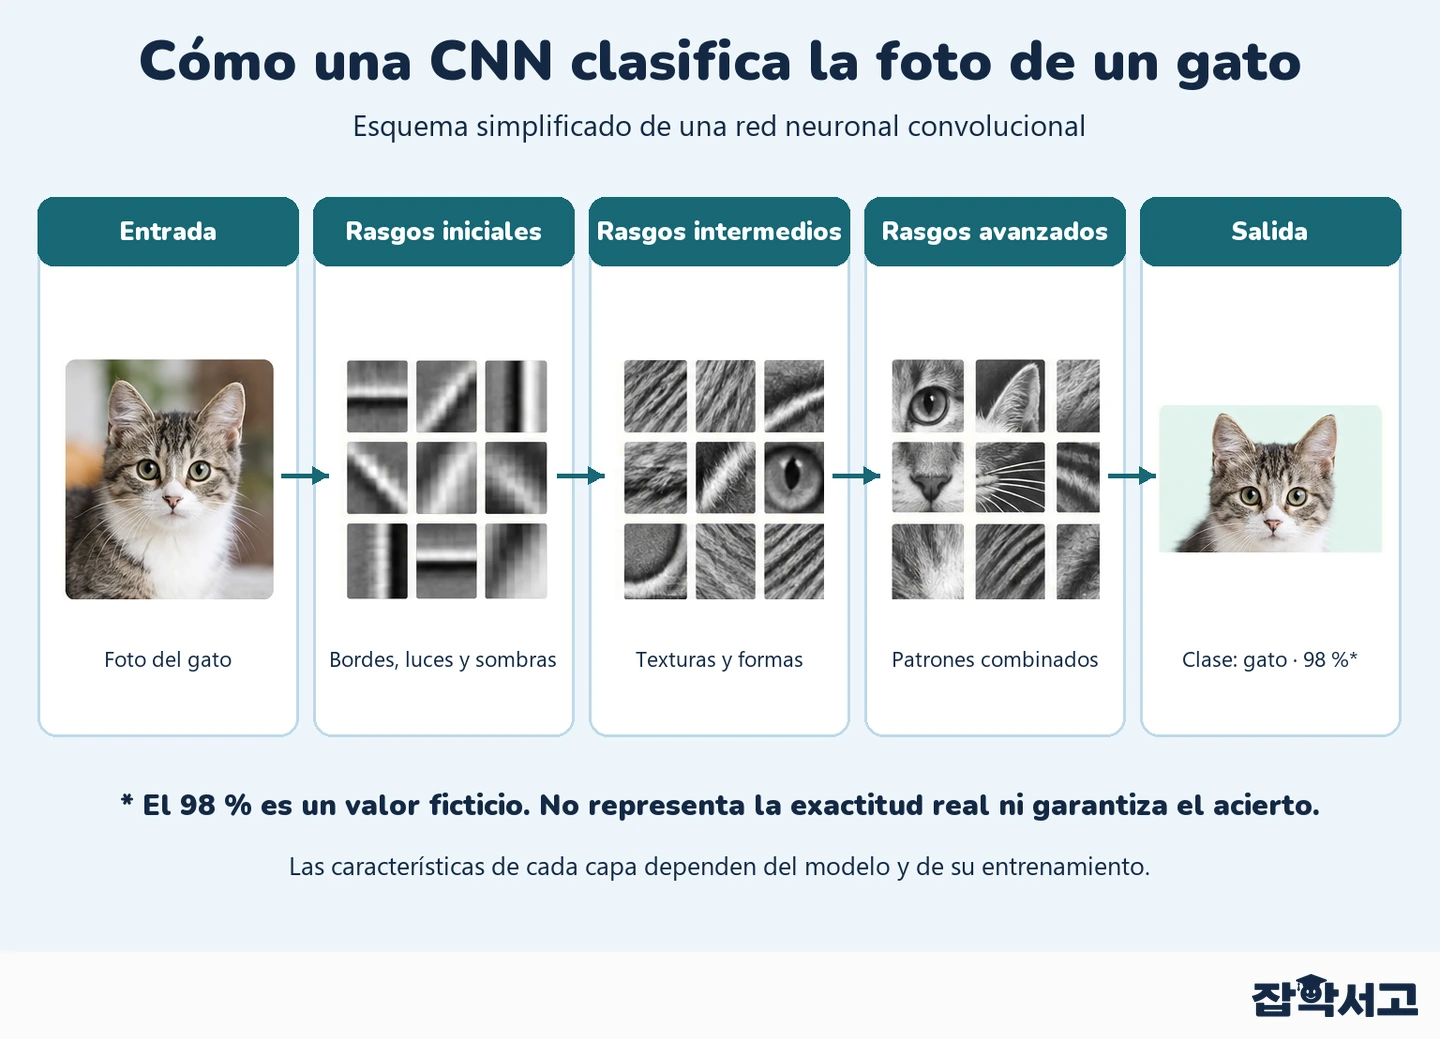
Cuando la computadora recibe una foto de un gato, en las capas ocultas sucede lo siguiente.
- Capas ocultas iniciales. Detectan los elementos más simples de la imagen, como las líneas, los contrastes de luminosidad y los bordes (Edge).
- Capas ocultas intermedias. Combinan las líneas extraídas para formar texturas, curvas y formas simples, como la de las orejas o la de las pupilas.
- Capas ocultas de nivel superior. Integran las formas para construir una estructura compleja que representa la forma completa de la cara del gato.
- Capa de salida. Concluye que «hay una probabilidad del 98 % de que esta foto muestre un gato».
Al principio del entrenamiento, la computadora hace muchas predicciones erróneas. Después calcula la diferencia entre la predicción y la respuesta correcta, y recorre la red desde las últimas capas hacia las primeras para ajustar la intensidad de las conexiones (los pesos, Weight) de modo que el error disminuya. Este algoritmo se llama retropropagación (Backpropagation). Al repetir el proceso millones de veces, la inteligencia artificial aprende gradualmente a emitir juicios precisos.
Principales ámbitos de aplicación del aprendizaje profundo
El aprendizaje profundo ha evolucionado hacia modelos optimizados para distintos tipos de datos.

Limitaciones y retos del aprendizaje profundo

El aprendizaje profundo ofrece un alto rendimiento, aunque todavía presenta retos concretos que se deben superar.
El problema de la caja negra (Explainability)
Como el aprendizaje profundo utiliza cientos de millones de pesos para llegar a una conclusión, a las personas les resulta difícil reconstruir el proceso y explicar por qué se llegó a ella. Esto supone un obstáculo importante en ámbitos como la medicina, las finanzas y el derecho, donde es fundamental poder justificar las decisiones.
Grandes volúmenes de datos y consumo de recursos
Entrenar modelos de aprendizaje profundo de alto rendimiento requiere abundantes recursos de cómputo (GPU/NPU), consume enormes cantidades de electricidad y exige conjuntos de datos de alta calidad.
Un motor clave para el futuro de las tecnologías de la información
Además de impulsar el avance de la informática, el aprendizaje profundo está cambiando de raíz la forma en que las personas analizan el mundo y resuelven problemas. Sus aplicaciones van más allá de la automatización de tareas simples y repetitivas, y se ha consolidado como una herramienta clave para abordar problemas complejos que afronta la humanidad, con usos como los servicios hiperpersonalizados, el desarrollo de nuevos medicamentos y la predicción del cambio climático.
Comprender el aprendizaje profundo desde la perspectiva de las tecnologías de la información permite ir más allá de conocer las últimas tendencias y constituye un primer paso para entender cómo funcionará la futura sociedad basada en datos.