アドレスバーに入力したサイトが危険かどうかを、ブラウザが毎回インターネット全体の危険リストをダウンロードして照合するとしたら、遅すぎて重すぎるでしょう。かといって、数百万件のアドレスをすべて端末に持たせるのも負担です。そんなとき、ごくわずかなメモリだけで「これは確実にリストにない」を素早く見分ける道具が使われます。
この道具をブルームフィルタ(Bloom Filter)と呼びます。ある値が集合に入っているかをごく小さな容量で調べる確率的データ構造で、1970年にバートン・ハワード・ブルーム(Burton Howard Bloom)が提案しました。その代わり、「ない」という答えは常に正しく、「ある」という答えはたまに間違うことがあるという独特の約束を抱えています。
この記事では、ブルームフィルタがどんな問題から生まれたのか、値を入れて確認する過程はどう進むのか、誤りの可能性をどう抑えるのか、そして実際のサービスでの使いどころと限界を順に見ていきます。
小さなビット配列で「ない」を見分ける技術
メモリを節約するために、正確さを少しだけ手放す
ブルームは、辞書に載った50万語のハイフン処理の問題を例に挙げました。単語の90パーセントは簡単な規則で区切れますが、残りの10パーセントはディスクから別にパターンを読み込む必要がありました。どの単語がその例外なのかを正確に覚えておくには、多くのメモリが要ります。
(1) 正確なハッシュの負担
例外の単語を一分の誤りもなく覚える表を作ろうとすると、それだけ大きなメモリが必要です。
(2) 誤りを許す発想
ときどき不要なディスク参照が起きてもかまわないと考えれば、はるかに小さな表で足ります。
(3) 効果
ブルームの論文によると、理想的な表の18パーセントの大きさだけで、不要なディスクアクセスの87パーセントをなくせます。
要は、誤りを一方向にだけ許すという点です。必要な参照を見逃すことはなく、不要な参照が少し残る側にしか間違えないので、結果は常に安全です。そのためブルームフィルタは、答えを教えてくれる道具というより、高くつく確認を省いてよいかを先に尋ねる門番に近い存在です。
ビット配列とハッシュ関数の働き方
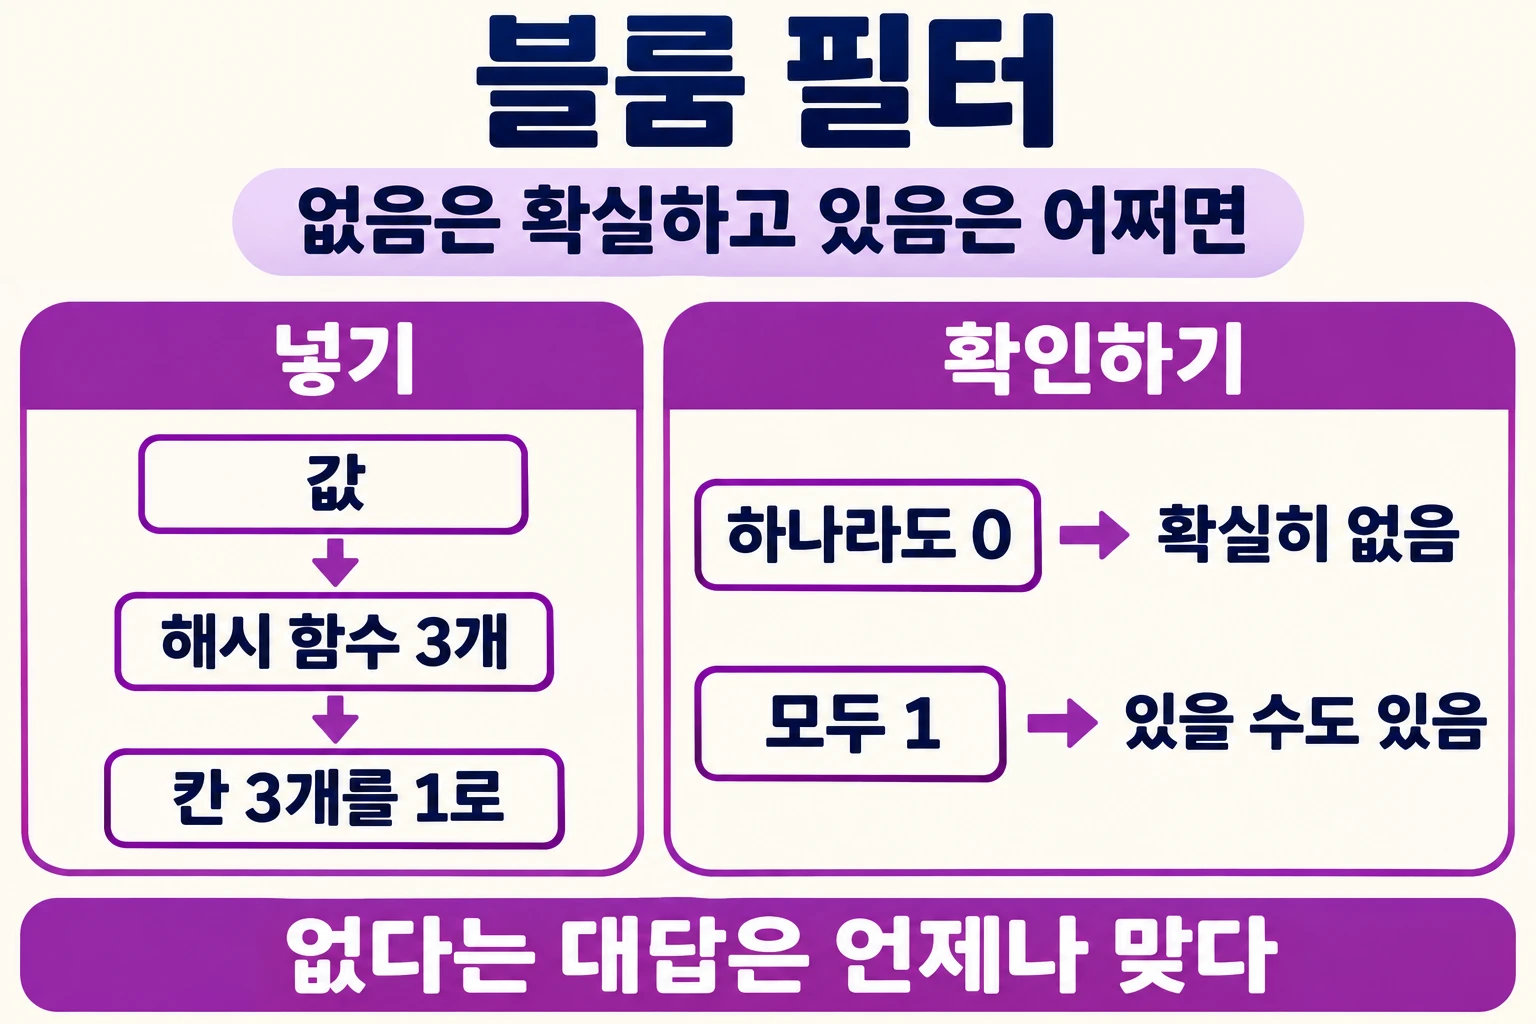
ブルームフィルタの本体は、最初はすべて0で埋められた長いビット配列1つと、それぞれ異なる値を出すk個のハッシュ関数です。
- 追加(Add):値をk個のハッシュ関数に通し、出てきたk個の位置をすべて1に変えます。
- 確認(Query):同じ方法でk個の位置を計算し、1つでも0なら「確実にない」と答えます。
- すべて1のとき(Possibly in Set):本当に入っているのかもしれませんし、ほかの値がたまたま位置を埋めたのかもしれないので、「あるかもしれない」としか答えられません。
- 計算時間(Time):確認にかかる時間はk回の計算だけなので、すでに入っている値がいくつあっても変わりません。
この構造は値そのものを保存しません。そのため、値が長くても短くても使う容量は同じで、同じ値を何度入れても配列はそれ以上変わらず、どんな値が入っていたかをさかのぼることもできません。
小さな例として、ビットが18個でハッシュ関数が3つのフィルタを考えてみましょう。値を3つ入れると、1になる位置は多くても9個です。このとき、新しく来た値が指す3つの位置のうち1つでも0なら、その値は入れたことがないという確かな証拠になります。また、同じ大きさで同じハッシュ関数を使う2つのフィルタは、ビットごとの和集合演算で1つにまとめることもできます。
誤りの確率をどう抑えるか
間違った「ある」、つまり偽陽性(False Positive)は、値をたくさん入れるほど増えます。ビットがだんだん1で埋まり、たまたますべての位置が1になる可能性が高まるからです。配列がどれほど小さくても値を入れること自体は失敗しませんが、際限なく入れ続けるとすべての位置が1になり、どんな問いにも「あるかもしれない」と答えるようになります。
(1) 配列の大きさ
配列が大きいほど偽陽性の確率は下がります。入れる値の数に比例して大きさを決めるのが基本です。
(2) ハッシュ関数の数
少なすぎると見分ける力が落ち、多すぎると位置がすぐ埋まってしまいます。理論上は、配列の大きさを値の数で割った商に自然対数の2を掛けた値の付近が最適です。
(3) 容量の感覚
偽陽性を1パーセントに抑えるには値1つあたり約9.6ビットで足り、さらに約4.8ビット足すと確率が10分の1になります。値の大きさとは関係のない数字です。
(4) 偽陰性はない
値を入れたあとで配列からビットを消さない限り、「入っているのにないと答える」ことは起きません。
サービスでの使いどころと限界
Google Bigtable、Apache HBase、Apache Cassandraなどのデータベースは、存在しない行を探してディスクを読む回数を減らすためにブルームフィルタを使っています。コンテンツ配信会社のAkamaiは、1回しか要求されないウェブオブジェクトがキャッシュ対象の4分の3近くを占めることを確認し、2回目の要求から保存するよう選り分けるのにこの道具を活用しました。Google Chromeも、かつては悪意のあるアドレスをまずこのフィルタでふるいにかけ、引っかかった場合にだけ精密な確認を行っていました。
- 削除できない(No Deletion):基本形は値を取り除けません。1つの位置が複数の値にまたがっているため、消すとほかの値まで消えてしまうおそれがあるからです。
- カウンティング・ブルームフィルタ(Counting Bloom Filter):各位置を1ビットから小さな数に置き換えて削除に対応しますが、3〜4倍の容量が要ります。
- カッコウフィルタ(Cuckoo Filter):値の短いフィンガープリントを保存して削除に対応する代替手段です。
- 満杯になると(Saturation):値を入れすぎると偽陽性が増え、結局フィルタを作り直すことになります。
ビットコインのウォレットが一時、同期を速めるためにこのフィルタを使い、のちにプライバシーの露出問題が明らかになった例のように、合う場面を見極める目も必要です。完璧な答えがいらない場面では、「確実に違う」を素早く見分けるだけで仕事の大半が減ります。すべてを正確に覚えようとする欲を手放し、どこまで間違えてよいかを先に決めること、それがブルームフィルタの第一歩です。