यदि ब्राउज़र हर बार पता पट्टी में दर्ज साइट के खतरनाक होने की जाँच के लिए पूरे इंटरनेट की खतरनाक साइटों की सूची डाउनलोड करके उससे मिलान करे, तो यह बहुत धीमा और संसाधनों पर भारी पड़ेगा। लेकिन लाखों पते डिवाइस में रखना भी बोझिल है। ऐसी स्थिति में एक ऐसा साधन काम आता है जो बहुत कम मेमोरी में तेज़ी से तय कर देता है कि ‘यह निश्चित रूप से सूची में नहीं है’।
इस साधन को ब्लूम फ़िल्टर (Bloom Filter) कहते हैं। यह एक प्रायिकतात्मक डेटा संरचना है, जो बहुत कम जगह में जाँचती है कि कोई मान किसी समुच्चय में है या नहीं। इसे 1970 में बर्टन हावर्ड ब्लूम (Burton Howard Bloom) ने प्रस्तावित किया था। इसके साथ एक अनोखी शर्त जुड़ी है: ‘नहीं है’ का उत्तर हमेशा सही होता है, जबकि ‘है’ का उत्तर कभी-कभी गलत हो सकता है।
इस लेख में हम क्रम से देखेंगे कि ब्लूम फ़िल्टर किस समस्या से शुरू हुआ, इसमें मान जोड़ने और उनकी जाँच करने की प्रक्रिया कैसे चलती है, गलती की संभावना को कैसे नियंत्रित किया जाता है, और वास्तविक सेवाओं में इसके उपयोग तथा सीमाएँ क्या हैं।
छोटे बिट ऐरे से ‘अनुपस्थिति’ पहचानने की तकनीक
मेमोरी बचाने के लिए सटीकता में थोड़ी छूट
ब्लूम ने शब्दकोश के 50 × दस हज़ार शब्दों में हाइफ़न लगाने की समस्या का उदाहरण दिया। इनमें से 90 प्रतिशत शब्दों को सरल नियमों के अनुसार तोड़ा जा सकता था, लेकिन बाकी 10 प्रतिशत के लिए डिस्क से अलग पैटर्न पढ़ने पड़ते थे। कौन-से शब्द इन अपवादों में आते हैं, इसे ठीक-ठीक याद रखने के लिए बहुत मेमोरी चाहिए।
(1) सटीक हैशिंग का बोझ
अपवाद वाले शब्दों को बिना किसी त्रुटि के याद रखने वाली तालिका बनाने के लिए उसी अनुपात में बड़ी मेमोरी चाहिए।
(2) त्रुटि की गुंजाइश रखने का विचार
यदि कभी-कभी डिस्क पर अनावश्यक खोज हो जाना स्वीकार्य हो, तो बहुत छोटी तालिका भी पर्याप्त है।
(3) प्रभाव
ब्लूम के शोधपत्र के अनुसार, आदर्श तालिका के आकार के केवल 18 प्रतिशत से भी डिस्क तक अनावश्यक पहुँच के 87 प्रतिशत मामलों को समाप्त किया जा सकता है।
मुख्य बात यह है कि गलती की गुंजाइश केवल एक दिशा में रखी जाती है। ज़रूरी खोज कभी नहीं छूटती, और गलती केवल कुछ अनावश्यक खोजें बच जाने के रूप में होती है, इसलिए परिणाम हमेशा सुरक्षित रहता है। इसी कारण ब्लूम फ़िल्टर सही उत्तर बताने वाले साधन से अधिक एक ऐसे द्वारपाल जैसा है, जो पहले यह जाँचता है कि महँगी जाँच को छोड़ा जा सकता है या नहीं।
बिट ऐरे और हैश फ़ंक्शन कैसे काम करते हैं
ब्लूम फ़िल्टर की मूल संरचना में एक लंबा बिट ऐरे होता है, जिसके सभी स्थान शुरू में 0 से भरे होते हैं, और अलग-अलग मान देने वाले k हैश फ़ंक्शन होते हैं।
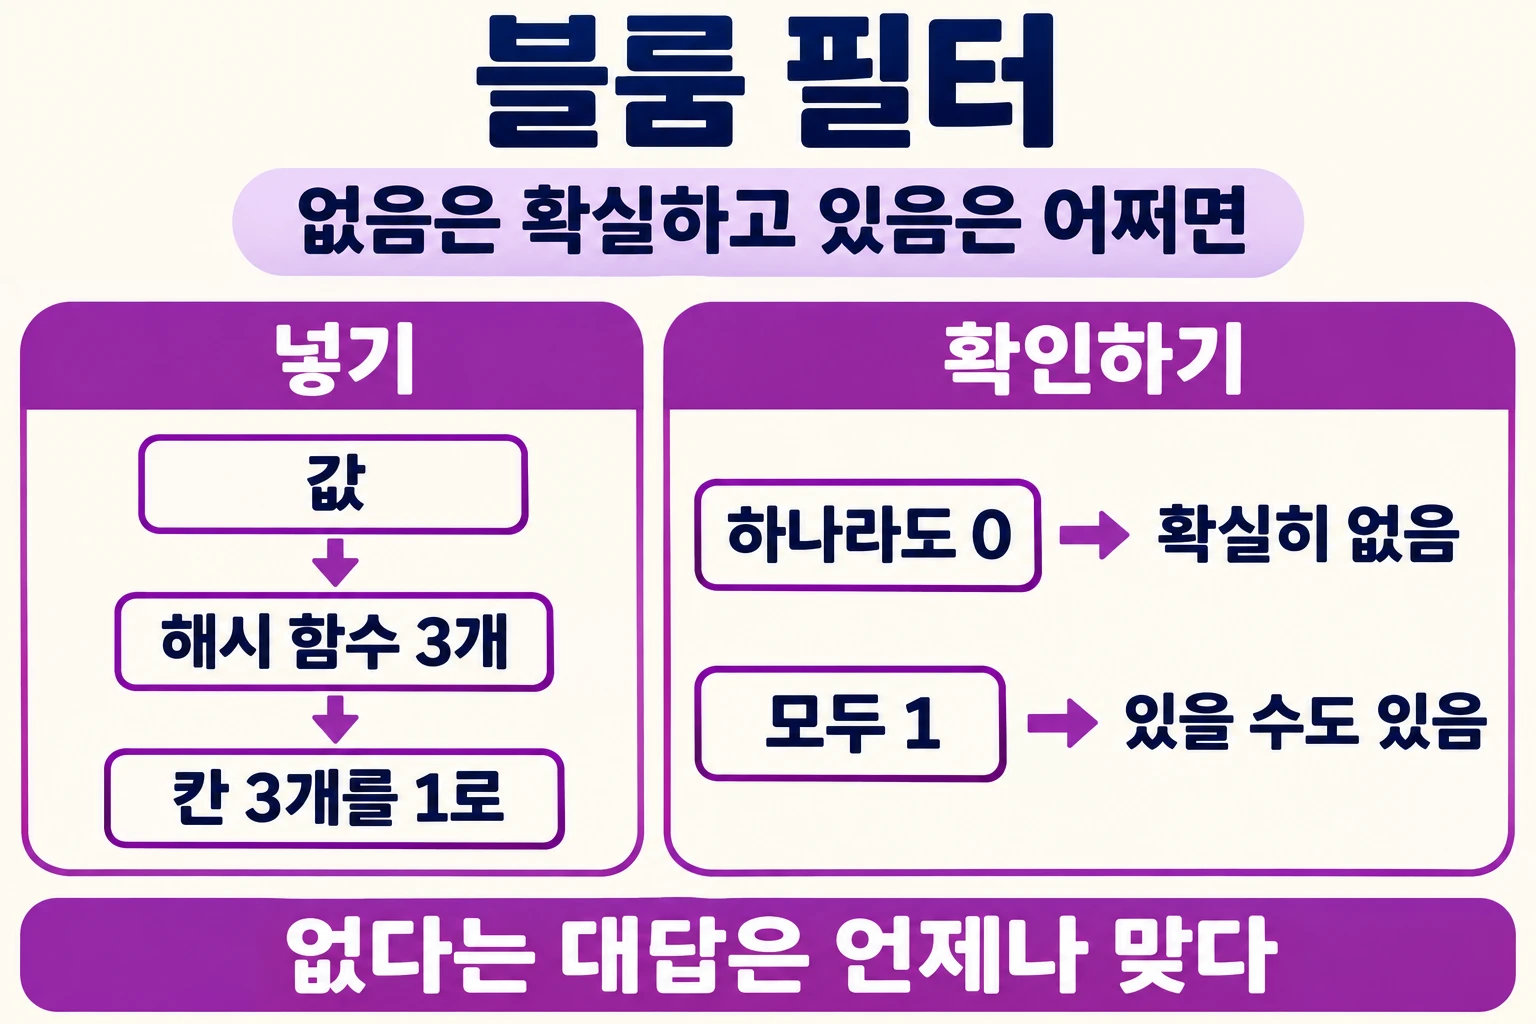
- जोड़ना (Add): मान को k हैश फ़ंक्शन में डालने से मिले सभी k खानों को 1 कर दिया जाता है।
- जाँच करना (Query): उसी तरीके से k खानों की गणना की जाती है। यदि एक भी खाना 0 हो, तो उत्तर मिलता है, ‘निश्चित रूप से अनुपस्थित’।
- जब सभी 1 हों (Possibly in Set): मान वास्तव में मौजूद हो सकता है, या दूसरे मानों ने संयोग से उन खानों को भर दिया हो सकता है। इसलिए केवल ‘मौजूद हो सकता है’ का उत्तर मिलता है।
- गणना का समय (Time): जाँच में केवल k बार गणना करनी पड़ती है, इसलिए पहले से मौजूद मानों की संख्या कितनी भी हो, इसमें लगने वाला समय नहीं बदलता।
यह संरचना स्वयं मानों को संग्रहीत नहीं करती। इसलिए मान लंबा हो या छोटा, वह समान जगह लेता है। एक ही मान को कई बार जोड़ने से ऐरे में और बदलाव नहीं होता, और यह भी पता नहीं लगाया जा सकता कि उसमें कौन-कौन से मान जोड़े गए थे।
एक छोटे उदाहरण के लिए ऐसे फ़िल्टर की कल्पना करें जिसमें 18 बिट खाने और 3 हैश फ़ंक्शन हों। तीन मान जोड़ने पर अधिकतम 9 खाने 1 हो जाएँगे। इस स्थिति में जाँच के लिए आए नए मान द्वारा इंगित तीन खानों में से एक भी 0 हो, तो यह पक्का प्रमाण है कि उस मान को कभी जोड़ा नहीं गया। साथ ही, समान आकार और समान हैश फ़ंक्शन वाले दो फ़िल्टर को बिटवार संघ क्रिया से एक में मिलाया जा सकता है।
गलती की संभावना को कैसे नियंत्रित करें
गलत ‘है’ का उत्तर, यानी मिथ्या सकारात्मक (False Positive), अधिक मान जोड़ने के साथ बढ़ता जाता है। इसका कारण यह है कि बिट धीरे-धीरे 1 से भरते जाते हैं और संयोग से सभी संबंधित खानों के 1 होने की संभावना बढ़ जाती है। ऐरे कितना भी छोटा हो, मान जोड़ना विफल नहीं होता, लेकिन लगातार मान जोड़ते रहने पर सभी खाने 1 हो जाते हैं और हर प्रश्न का उत्तर ‘मौजूद हो सकता है’ मिलने लगता है।
(1) ऐरे का आकार
ऐरे जितना बड़ा होगा, मिथ्या सकारात्मक की संभावना उतनी कम होगी। मूल नियम यह है कि उसका आकार जोड़े जाने वाले मानों की संख्या के अनुपात में रखा जाए।
(2) हैश फ़ंक्शन की संख्या
बहुत कम हैश फ़ंक्शन होने पर भेद करने की क्षमता घटती है और बहुत अधिक होने पर खाने जल्दी भर जाते हैं। सिद्धांत के अनुसार, ऐरे के आकार को मानों की संख्या से भाग देकर प्राप्त भागफल को 2 के प्राकृतिक लघुगणक से गुणा करने पर जो मान मिलता है, उसके आसपास की संख्या सर्वोत्तम होती है।
(3) जगह का अनुमान
मिथ्या सकारात्मक की संभावना को 1 प्रतिशत तक सीमित रखने के लिए हर मान पर लगभग 9.6 बिट पर्याप्त हैं। लगभग 4.8 बिट और जोड़ने से यह संभावना दस गुना कम हो जाती है। इन संख्याओं का मान के आकार से कोई संबंध नहीं है।
(4) मिथ्या नकारात्मक नहीं होते
मान जोड़ने के बाद जब तक ऐरे से बिट मिटाए नहीं जाते, तब तक ऐसा नहीं होता कि ‘मान मौजूद हो, लेकिन उत्तर मिले कि वह नहीं है’।
सेवाओं में उपयोग और सीमाएँ
गूगल बिगटेबल, अपाचे HBase और अपाचे कैसेंड्रा जैसे डेटाबेस अनुपस्थित पंक्तियों की खोज में डिस्क पढ़ने की ज़रूरत कम करने के लिए ब्लूम फ़िल्टर का उपयोग करते हैं। सामग्री वितरण कंपनी अकामाई ने पाया कि कैश में रखे जाने वाले वेब ऑब्जेक्टों में करीब 4 में से 3 ऐसे थे जिनका अनुरोध केवल एक बार होता था। उसने इस साधन का उपयोग छँटाई के लिए किया, ताकि ऑब्जेक्ट दूसरे अनुरोध से ही संग्रहीत किए जाएँ। गूगल क्रोम भी एक समय दुर्भावनापूर्ण पतों को पहले इस फ़िल्टर से जाँचता था और केवल इसमें चिह्नित होने पर ही विस्तृत जाँच करता था।
- हटाना संभव नहीं (No Deletion): मूल संस्करण में मान हटाए नहीं जा सकते। ऐसा इसलिए है कि एक खाना कई मानों से जुड़ा हो सकता है, और उसे मिटाने से दूसरे मान भी गायब हो सकते हैं।
- काउंटिंग ब्लूम फ़िल्टर (Counting Bloom Filter): हर खाने में 1 बिट की जगह एक छोटी संख्या रखकर यह हटाने की सुविधा देता है, लेकिन इसके लिए 3 से 4 गुना जगह चाहिए।
- कुकू फ़िल्टर (Cuckoo Filter): यह एक विकल्प है जो मान का छोटा फ़िंगरप्रिंट संग्रहीत करके हटाने की सुविधा देता है।
- पूरी तरह भर जाना (Saturation): बहुत अधिक मान जोड़ने पर मिथ्या सकारात्मक बढ़ जाते हैं और अंततः फ़िल्टर को नए सिरे से बनाना पड़ता है।
बिटकॉइन वॉलेट ने एक समय समकालिकरण की गति बढ़ाने के लिए इस फ़िल्टर का उपयोग किया था, लेकिन बाद में निजी जानकारी उजागर होने की समस्या सामने आई। ऐसे उदाहरण बताते हैं कि यह पहचानने की समझ भी ज़रूरी है कि इसका उपयोग कहाँ उपयुक्त है। जहाँ पूरी तरह सटीक उत्तर ज़रूरी नहीं होता, वहाँ केवल ‘निश्चित रूप से नहीं’ को तेज़ी से पहचान लेने पर भी अधिकांश काम कम हो जाता है। हर चीज़ को बिल्कुल सही याद रखने की इच्छा छोड़कर पहले यह तय करना कि कितनी गलती स्वीकार्य है—यही ब्लूम फ़िल्टर की ओर पहला कदम है।