
어림으로 답에 다가가는 법, 페르미 추정(Fermi Estimation)
주소창에 입력한 사이트가 위험한 곳인지 브라우저가 매번 인터넷 전체의 위험 목록을 내려받아 대조한다면 너무 느리고 무거울 것입니다. 그렇다고 수백만 개의 주소를 모두 기기에 담아 두기도 부담스럽습니다. 이럴 때 아주 작은 메모리만으로 ‘이건 확실히 목록에 없다’를 빠르게 가려내는 도구가 쓰입니다.
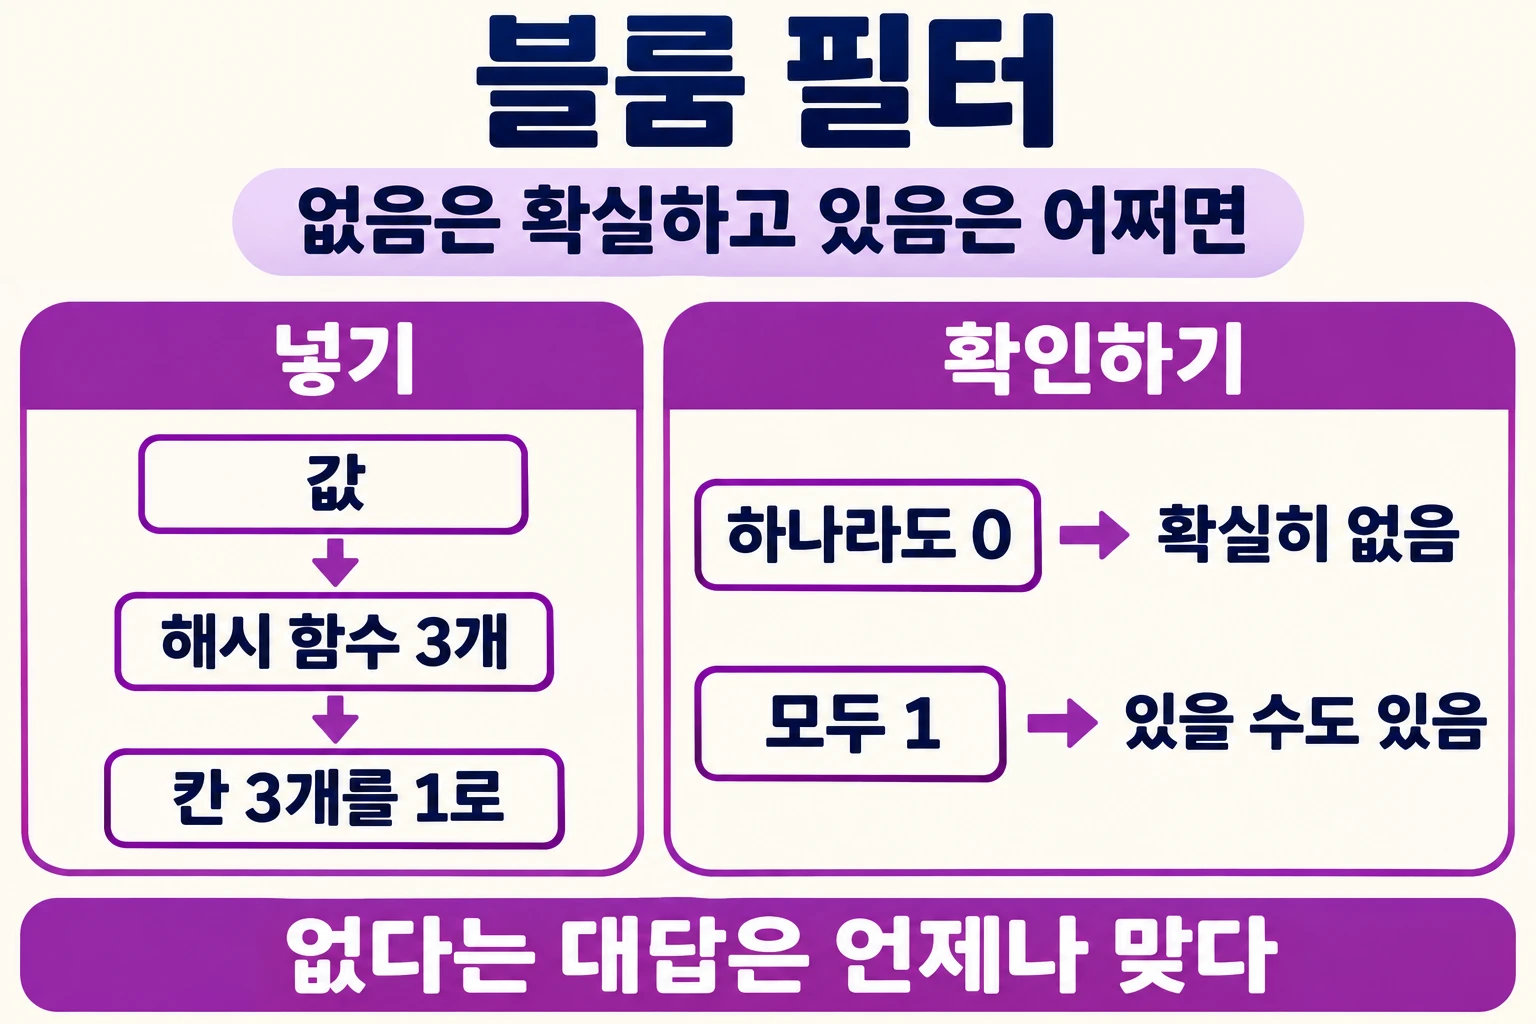
이 도구를 블룸 필터(Bloom Filter)라고 부릅니다. 어떤 값이 집합에 들어 있는지를 아주 적은 공간으로 확인하는 확률적 자료구조로, 1970년 버튼 하워드 블룸(Burton Howard Bloom)이 제안했습니다. 대신 ‘없다’는 대답은 언제나 맞고, ‘있다’는 대답은 가끔 틀릴 수 있다는 독특한 약속을 안고 있습니다.
본 자료에서는 블룸 필터가 어떤 문제에서 출발했는지, 값을 넣고 확인하는 과정은 어떻게 이뤄지는지, 틀릴 가능성은 어떻게 다스리는지, 그리고 실제 서비스에서의 쓰임새와 한계를 차례로 살펴보겠습니다.
작은 비트 배열로 ‘없음’을 가려내는 기술
메모리를 아끼려고 정확함을 조금 내주다

블룸은 사전 속 단어 50만 개의 하이픈 처리 문제를 예로 들었습니다. 단어의 90퍼센트는 간단한 규칙으로 끊을 수 있지만, 나머지 10퍼센트는 디스크에서 따로 패턴을 읽어 와야 했습니다. 어떤 단어가 그 예외인지 정확히 기억하려면 메모리가 많이 듭니다.
(1) 정확한 해시의 부담
예외 단어를 한 치의 오류 없이 기억하는 표를 만들려면 그만큼 큰 메모리가 필요합니다.
(2) 오류를 허용하는 발상
가끔 불필요한 디스크 조회가 생겨도 괜찮다고 보면 훨씬 작은 표로도 충분합니다.
(3) 효과
블룸의 논문에 따르면 이상적인 표의 18퍼센트 크기만으로도 불필요한 디스크 접근의 87퍼센트를 없앨 수 있습니다.
핵심은 틀림을 한쪽 방향으로만 허용한다는 점입니다. 필요한 조회를 놓치는 일은 없고, 불필요한 조회가 조금 남는 쪽으로만 틀리기 때문에 결과는 항상 안전합니다. 이 때문에 블룸 필터는 정답을 알려 주는 도구가 아니라, 값비싼 확인을 건너뛰어도 되는지를 먼저 묻는 문지기에 가깝습니다.
비트 배열과 해시 함수가 일하는 방식
블룸 필터의 몸체는 처음에 모두 0으로 채워진 긴 비트 배열 하나와, 서로 다른 값을 내놓는 k개의 해시 함수입니다.
- 넣기(Add): 값을 k개의 해시 함수에 넣어 나온 k개의 칸을 모두 1로 바꿉니다.
- 확인하기(Query): 같은 방식으로 k개의 칸을 계산해 하나라도 0이면 ‘확실히 없음’이라고 답합니다.
- 모두 1일 때(Possibly in Set): 정말 들어 있을 수도 있고, 다른 값들이 우연히 칸을 채웠을 수도 있어 ‘있을 수도 있음’이라고만 답합니다.
- 계산 시간(Time): 확인에 드는 시간은 k번의 계산뿐이라 이미 들어 있는 값이 몇 개든 달라지지 않습니다.
이 구조는 값 자체를 저장하지 않습니다. 그래서 값이 길든 짧든 차지하는 공간이 같고, 같은 값을 여러 번 넣어도 배열은 더 변하지 않으며, 어떤 값이 들어 있었는지 되짚어 볼 수도 없습니다.
작은 예로 비트가 18칸이고 해시 함수가 3개인 필터를 떠올려 보겠습니다. 값 세 개를 넣으면 많아야 9칸이 1이 됩니다. 이때 새로 들어온 값이 가리키는 세 칸 가운데 하나라도 0이면 이 값은 넣은 적이 없다는 확실한 증거가 됩니다. 또 같은 크기와 같은 해시 함수를 쓰는 두 필터는 비트별 합집합 연산으로 하나로 합칠 수도 있습니다.
틀릴 확률은 어떻게 다스릴까

잘못된 ‘있다’, 곧 거짓 양성(False Positive)은 값을 많이 넣을수록 늘어납니다. 비트가 점점 1로 채워져 우연히 모든 칸이 1일 가능성이 커지기 때문입니다. 배열이 아무리 작아도 값을 넣는 일이 실패하지는 않지만, 끝없이 넣다 보면 모든 칸이 1이 되어 어떤 질문에도 ‘있을 수도 있음’이라고 답하게 됩니다.
(1) 배열 크기
배열이 클수록 거짓 양성 확률이 내려갑니다. 넣을 값의 수에 비례해 크기를 잡는 것이 기본입니다.
(2) 해시 함수의 개수
너무 적으면 구분력이 떨어지고 너무 많으면 칸이 빨리 찹니다. 이론상 배열 크기를 값의 수로 나눈 몫에 자연로그 2를 곱한 값 근처가 가장 좋습니다.
(3) 공간의 감각
거짓 양성을 1퍼센트로 묶으려면 값 하나당 약 9.6비트면 되고, 약 4.8비트를 더하면 확률이 열 배 더 낮아집니다. 값의 크기와는 무관한 숫자입니다.
(4) 거짓 음성은 없다
값을 넣고 나서 배열에서 비트를 지우지 않는 한 ‘있는데 없다고 답하는’ 일은 생기지 않습니다.
서비스 속의 쓰임새와 한계

구글 빅테이블, 아파치 HBase, 아파치 카산드라 같은 데이터베이스는 존재하지 않는 행을 찾느라 디스크를 읽는 일을 줄이려고 블룸 필터를 씁니다. 콘텐츠 전송 업체 아카마이는 한 번만 요청되는 웹 객체가 캐시 대상의 4분의 3 가까이 된다는 점을 확인하고, 두 번째 요청부터 저장하도록 걸러 내는 데 이 도구를 활용했습니다. 구글 크롬도 한때 악성 주소를 먼저 이 필터로 거른 뒤, 걸린 경우에만 정밀 확인을 했습니다.
- 지울 수 없음(No Deletion): 기본형은 값을 뺄 수 없습니다. 칸 하나가 여러 값에 걸쳐 있어 지우면 다른 값까지 사라질 수 있기 때문입니다.
- 카운팅 블룸 필터(Counting Bloom Filter): 칸을 1비트 대신 작은 숫자로 바꿔 삭제를 지원하지만 공간이 3~4배 듭니다.
- 쿠쿠 필터(Cuckoo Filter): 값의 짧은 지문을 저장해 삭제를 지원하는 대안입니다.
- 가득 차면(Saturation): 값이 너무 많이 들어가면 거짓 양성이 늘어 결국 필터를 새로 만들어야 합니다.
비트코인 지갑이 한때 동기화 속도를 높이려고 이 필터를 썼다가 개인 정보 노출 문제가 드러난 사례처럼, 잘 맞는 자리를 가려 쓰는 안목도 필요합니다. 완벽한 대답이 필요 없는 자리에서는 ‘확실히 아니다’만 빨리 가려내도 일의 대부분이 줄어듭니다. 모든 것을 정확히 기억하려는 욕심을 내려놓고 어디까지 틀려도 되는지를 먼저 정하는 것, 그것이 블룸 필터의 첫걸음입니다.
이 글 PDF 구매
1,000원한국어 PDF · 같은 계정으로 다시 다운로드할 수 있어요.
PDF 구매 옵션 보기
함께 읽을 책
이 자료의 핵심 키워드와 연결된 책입니다.