
말랑한 몸으로 움직이는 기계, 소프트 로봇공학(Soft Robotics)
인터넷에서 무언가를 찾을 때 우리는 검색 결과를 훑어보고, 그럴듯한 링크를 누르고, 기대에 못 미치면 금세 뒤로 돌아갑니다. 어떤 사이트에는 오래 머물고 어떤 사이트는 몇 초 만에 떠나는데, 그 판단은 대부분 깊이 생각하지 않고 거의 순식간에 이루어집니다.
1990년대 초 미국 제록스 팔로알토 연구소(PARC)의 피터 피롤리(Peter Pirolli)와 스튜어트 카드(Stuart Card)는 이런 모습이 먹이를 찾아 숲을 돌아다니는 동물과 무척 닮았다는 점에 주목했습니다. 두 사람은 동물의 먹이 찾기를 설명하던 생태학 이론을 사람의 정보 찾기에 옮겨 와 ‘정보 채집 이론(Information Foraging Theory)’을 세웠습니다.
본 자료에서는 정보 채집 이론이 어디에서 왔는지와 핵심 개념인 정보 냄새, 사냥터를 떠나는 시점, 그리고 이 이론이 웹과 도서관 서비스 설계에 주는 교훈까지 차례로 살펴보겠습니다.
냄새를 따라 정보를 찾는다, 정보 채집 이론 이야기
먹이를 찾는 동물에게서 빌려 온 이론
정보 채집 이론의 뿌리는 1970년대 생태학자와 인류학자들이 다듬은 ‘최적 채집 이론(Optimal Foraging Theory)’입니다. 이 이론은 동물이 주어진 시간 안에 얻는 에너지를 최대한 늘리는 방향으로 먹이를 고른다고 봅니다. 어떤 먹이는 쫓을 가치가 있지만, 어떤 먹이는 쫓는 데 드는 힘이 얻는 에너지보다 커서 손해가 됩니다.
피롤리와 카드는 이 생각을 다음과 같이 정보에 옮겨 놓았습니다.
(1) 먹이는 정보
동물이 먹이를 찾듯 사람은 질문에 답해 줄 정보를 찾습니다. 얻는 에너지 대신 얻는 쓸모를 따집니다.
(2) 비용은 시간과 수고
동물이 걷고 쫓는 데 힘을 쓰듯, 사람은 검색하고 클릭하고 읽는 데 시간과 주의를 씁니다.
(3) 목표는 효율
사람도 들인 시간에 비해 쓸모 있는 정보를 가장 많이 얻는 쪽으로 움직이려 한다는 것이 이론의 기본 가정입니다.
이 이론에서는 이렇게 끊임없이 정보를 찾아 먹는 사람을 ‘정보 포식자(Informavore)’라고 부르기도 합니다. 1999년 학술지 『심리학 리뷰(Psychological Review)』에 실린 두 사람의 논문은 이 이론을 대표하는 글로 꼽힙니다.
정보 냄새, 링크가 풍기는 단서
정보 채집 이론에서 가장 중요한 개념은 ‘정보 냄새(Information Scent)’입니다. 동물이 냄새로 근처에 먹이가 있을지 가늠하듯, 사람은 눈앞의 단서를 보고 그 길 끝에 원하는 정보가 있을지 짐작합니다.
- 링크 문구(Link Label): 링크에 적힌 말이 찾는 내용과 맞닿아 있을수록 냄새가 강해집니다. ‘더 보기’처럼 막연한 문구는 냄새가 거의 나지 않습니다.
- 곁들인 설명(Snippet): 검색 결과의 요약문이나 작은 그림도 그 페이지가 무엇을 담았는지 알려 주는 단서가 됩니다.
- 주변 맥락(Context): 같은 단어라도 어떤 사이트, 어떤 메뉴 옆에 놓였느냐에 따라 전혀 다르게 읽힙니다.
- 이전 경험(Prior Knowledge): 믿을 만한 곳이라는 기억이나 다른 사람의 추천도 냄새를 더 짙게 만듭니다.
정보 냄새는 늘 상대적입니다. ‘음식’이라는 링크는 치즈를 찾는 사람에게는 냄새가 강하지만, 세안제를 찾는 사람에게는 거의 아무 냄새도 나지 않습니다.
언제 사냥터를 떠날까
이 이론에서는 웹사이트 하나, 책장 한 칸, 검색 결과 한 쪽처럼 정보가 모여 있는 곳을 ‘정보 패치(Information Patch)’라고 부릅니다. 사람은 한 패치에서 정보를 거두다가 어느 순간 다른 곳으로 옮겨 갑니다.
(1) 수확이 줄어드는 순간
처음에는 쓸 만한 정보가 쉽게 나오지만, 계속 머물수록 새로 건지는 것은 줄어듭니다. 생태학의 ‘한계 가치 정리(Marginal Value Theorem)’처럼, 지금 자리의 수확이 다른 곳으로 옮겨 가 얻을 기대치보다 낮아지면 떠나는 편이 낫습니다.
(2) 옮겨 가는 비용
다른 패치가 멀고 찾기 어려우면 지금 자리에 더 오래 머뭅니다. 반대로 옮겨 가기가 쉬우면 금세 자리를 뜹니다.
(3) 무엇을 먹을지 고르기
동물이 먹이 목록을 정하듯 사람도 어떤 자료를 읽고 어떤 자료를 건너뛸지 고릅니다. 이를 ‘정보 식단(Information Diet)’이라고 합니다.
사용성 전문가 제이콥 닐슨(Jakob Nielsen)은 2003년, 검색 엔진이 좋은 사이트를 쉽게 찾아 주면서 사람들이 한 사이트에 오래 머물지 않고 더 빨리 떠나게 되었다고 이 이론으로 설명했습니다. 옮겨 가는 비용이 줄었기 때문입니다.
웹과 도서관에 주는 교훈
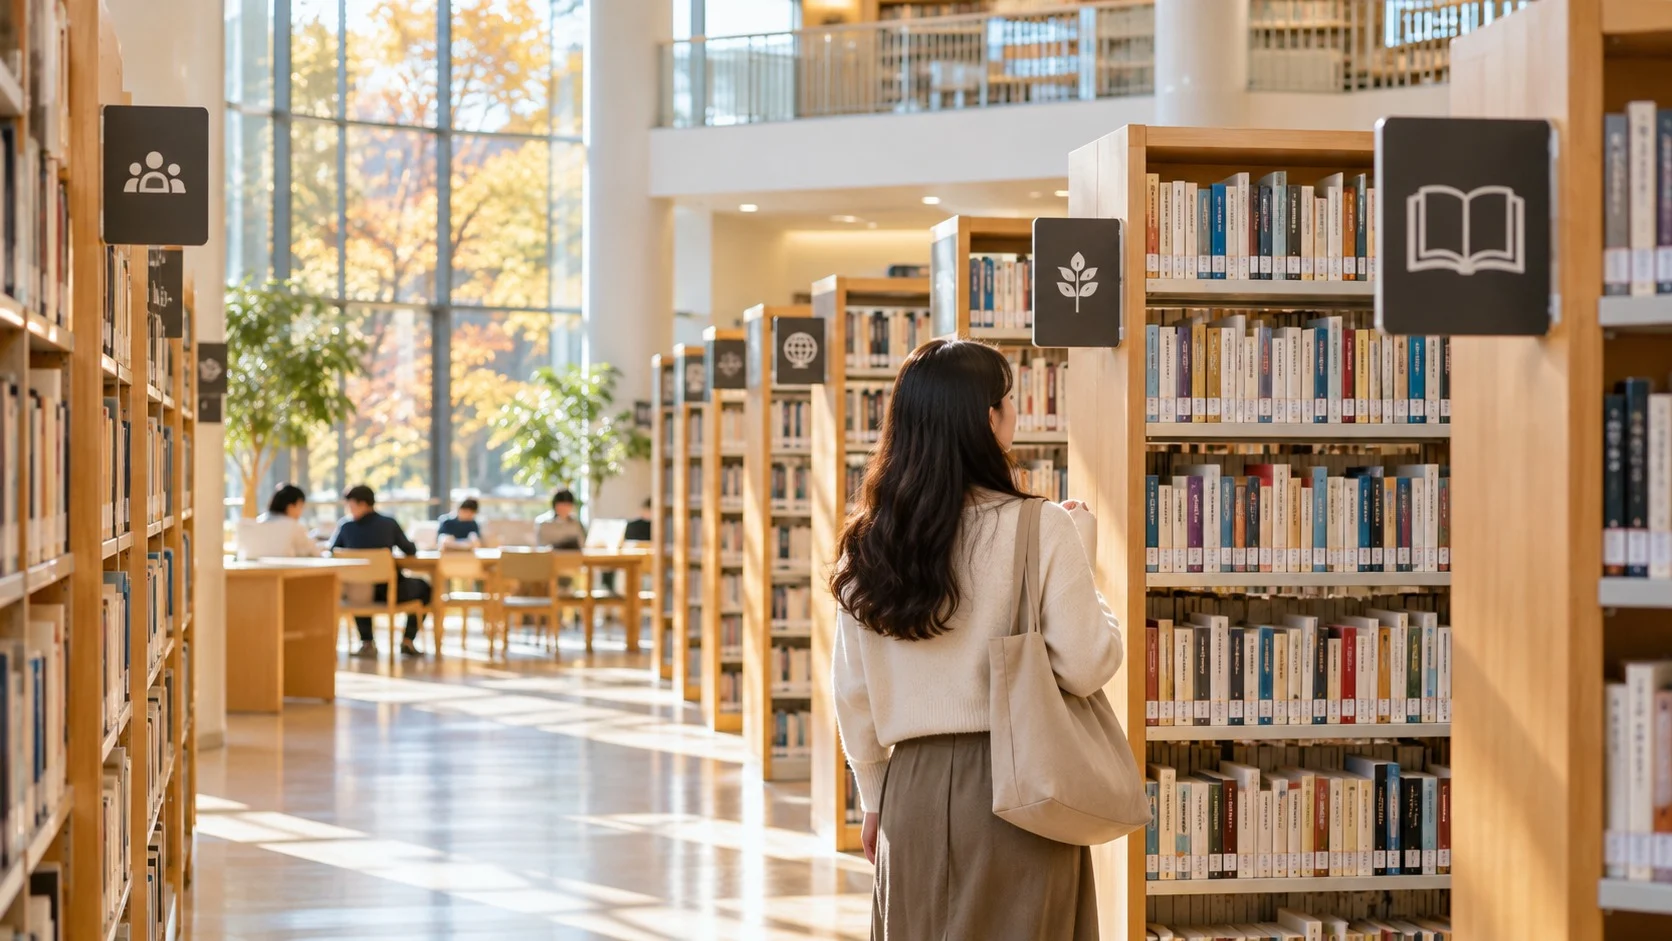
정보 채집 이론은 사람들이 길을 잃지 않도록 정보 공간을 설계하는 데 널리 쓰입니다.
- 분명한 이름 붙이기(Clear Labeling): 메뉴와 링크 이름에 이용자가 실제로 쓰는 말을 넣어야 냄새가 제대로 납니다. 전문 용어나 내부에서만 쓰는 이름은 냄새를 지웁니다.
- 첫 화면의 단서(Early Cues): 페이지에 들어오자마자 제대로 찾아왔다는 확신을 주지 못하면 이용자는 곧 다른 패치로 떠납니다.
- 약속 지키기(Matching Expectations): 링크가 풍긴 냄새와 실제 내용이 다르면 한 번은 클릭을 얻어도 신뢰를 잃습니다. 낚시성 제목이 오래가지 못하는 이유입니다.
- 함께 찾기(Social Foraging): 서평, 추천, 태그처럼 앞서 찾은 사람이 남긴 흔적은 뒤에 오는 사람에게 새로운 냄새가 됩니다.
도서관의 서가 안내판, 목록의 주제어, 이용자 맞춤 추천도 결국 이용자가 원하는 자료의 냄새를 맡고 따라올 수 있게 돕는 장치라고 볼 수 있습니다.
정보 채집 이론은 사람이 정보를 찾는 일이 생각보다 오래된 본능에 기대고 있다는 사실을 보여 줍니다. 찾는 사람이 냄새를 놓치지 않도록 길목마다 정직한 단서를 남기는 것, 그것이 찾기 쉬운 정보 공간의 첫걸음입니다.