统计学是一门通过数据分析得出重要结论的学科,在众多领域得到广泛应用。其中,变量(variable)在统计学中起着核心作用。变量是数据分析的基础,如果不能正确理解和运用,就难以获得准确的结果。
本文将深入分析统计学中变量的概念与定义、自变量与因变量的区别及应用实例、统计分析中选择变量的方法与标准,以及变量之间的相关关系与因果关系。
变量的概念与定义:为什么在统计学中如此重要?
 什么是变量?
变量的定义与作用
在统计学中,变量是指针对某一特定现象或实验可以测量或观察的要素。它是收集和分析数据时必不可少的要素,并且会根据研究目的以多种形式出现。例如,人的身高、体重、年龄等都可以被视为变量。这些变量可以量化,从而能够进行数据分析。
变量的重要性
变量的重要性与数据分析的准确性直接相关。如果没有选择正确的变量并加以适当管理,就可能对分析结果产生很大影响。例如,研究者如果在通过实验获得的数据中遗漏了重要变量,结果的效度和信度就会出现问题。因此,变量的定义与选择非常重要。
变量的类型
在统计学中,变量大致可分为两类:定性变量和定量变量。定性变量是分类数据,例如性别、血型等。而定量变量是数值数据,例如身高、体重等。分析方法也会因变量类型的不同而有所不同。
自变量与因变量
变量还可以分为自变量和因变量。自变量是研究者操纵或控制的变量,在实验中起提供原因的作用。相反,因变量是受自变量影响的变量,用于测量结果。清楚地理解变量的这些作用非常重要。
变量的理解与运用
清楚地理解变量的定义和概念,就如同为研究打下基础。它是数据分析的出发点,也是决定研究整体方向的重要因素。因此,需要深入理解变量的概念与定义,并具备恰当运用它们的能力。
通过实例理解变量
最后,为了强调变量的重要性,考察各种实例也很有帮助。例如,在医学研究中分析某种药物的效果时,将是否使用该药物设为自变量,将疾病的进展状况设为因变量。通过这样的实例,可以更清楚地理解变量的重要性和作用。
自变量与因变量:区别与应用实例
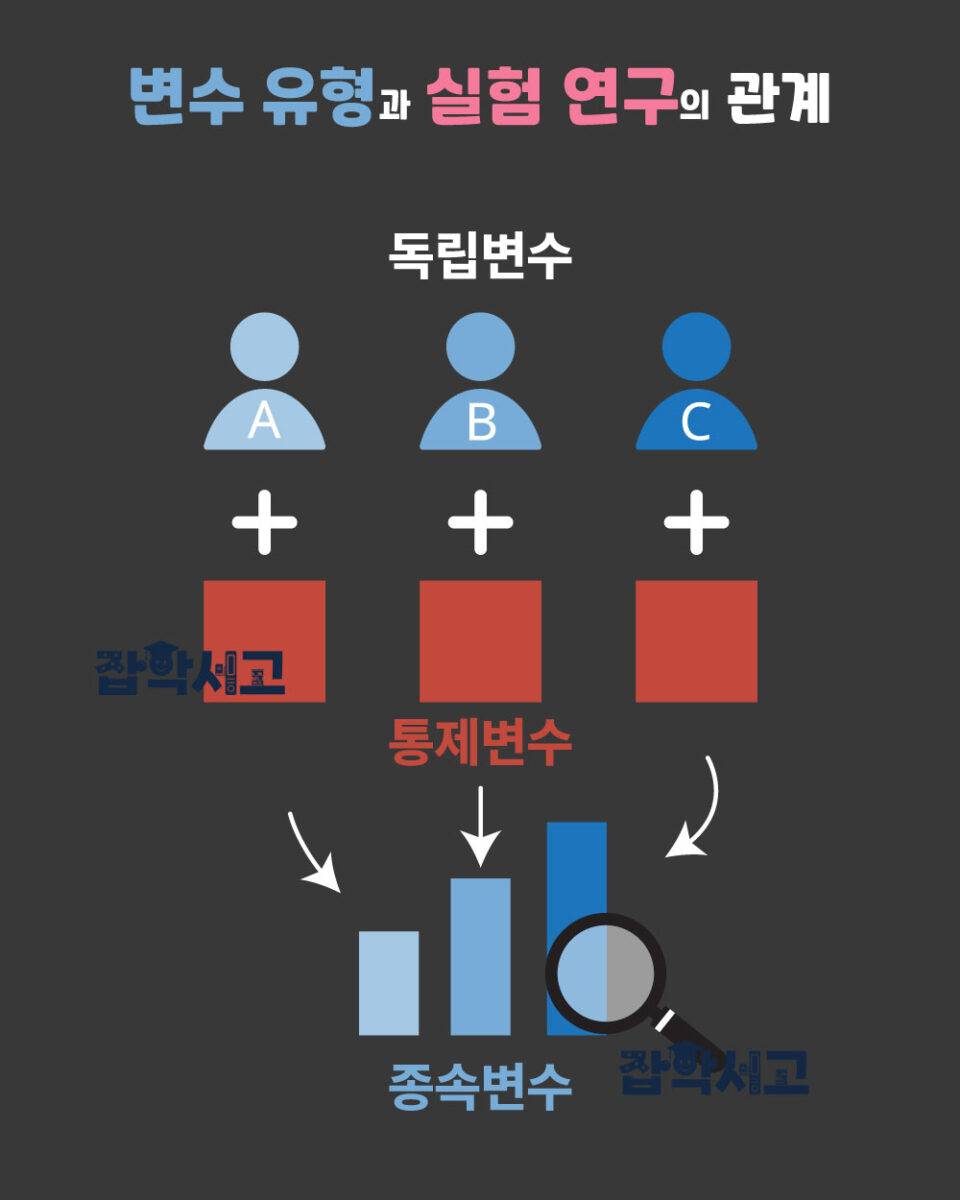 变量类型与实验研究的关系
自变量与因变量的概念
自变量与因变量是统计学中最基本也最重要的概念。自变量是指在实验或研究中由研究者操纵或控制的变量。而因变量是指受这种自变量影响的变量。也就是说,自变量提供原因,因变量测量其结果。
自变量与因变量的区别
理解自变量与因变量的区别,对于设计研究和解释数据至关重要。通过以下示例可以轻松理解。
- 自变量(Independent Variable):研究者操纵或控制的变量。例如,实验中所给予的某种药物的剂量。
- 因变量(Dependent Variable):受自变量影响的变量。例如,给药后患者病情的变化。
通过示例解释概念
教育研究
- 自变量:某一特定教育项目(例如:新的数学学习方法)。
- 因变量:学生的学业成就(例如:数学考试成绩)。
在这种情况下,研究者分析新的数学学习方法(自变量)对学生数学成绩(因变量)的影响。
医学研究
- 自变量:是否使用某种特定药物(例如:使用抗生素)。
- 因变量:患者病情的变化(例如:感染症状的缓解程度)。
在这种情况下,研究者评估使用抗生素(自变量)对患者感染症状(因变量)的影响。
心理学研究
- 自变量:某种特定疗法(例如:认知行为疗法)。
- 因变量:患者的焦虑水平(例如:焦虑量表得分)。
在这种情况下,研究者考察认知行为疗法(自变量)对患者焦虑水平(因变量)的影响。
市场营销研究
- 自变量:某一特定广告活动。
- 因变量:产品销量。
在这种情况下,研究者分析该广告活动(自变量)对产品销量(因变量)的影响。
社会科学研究
- 自变量:政府政策。
- 因变量:国民的生活质量。
在这种情况下,研究者研究政府政策(自变量)对国民生活质量(因变量)的影响。
健康研究
- 自变量:运动计划。
- 因变量:体能水平。
在这种情况下,研究者评估某一特定运动计划(自变量)对体能水平(因变量)的影响。
经济研究
- 自变量:降息政策。
- 因变量:消费者支出。
在这种情况下,研究者分析降息政策(自变量)对消费者支出(因变量)的影响。
通过这些示例,可以更清楚地理解自变量与因变量的概念,并在此基础上开展更加可靠的研究。
什么是控制变量?
控制变量是为了确保实验的公平性而固定不变的变量。在实验过程中对控制变量加以管理,使其不发生变化,就能更准确地测量自变量对因变量的影响。例如,在植物生长实验中,如果将光照量设为控制变量,就可以在保持光照量不变的同时,分析浇水量(自变量)对植物生长(因变量)的影响。
变量的相关关系与因果关系:深入分析与理解
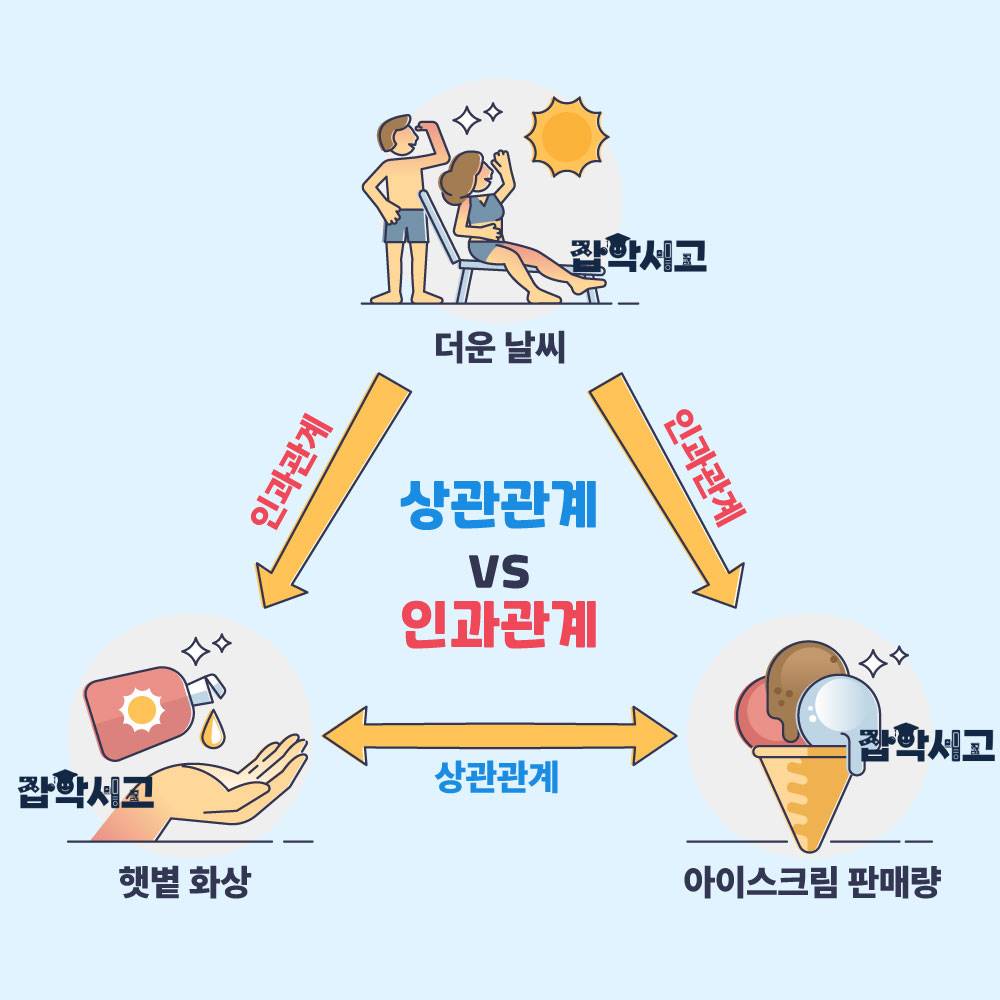 相关关系与因果关系的概念及示例
相关关系与因果关系的重要性
变量的相关关系与因果关系是统计分析中的重要概念,对于理解两个变量之间的关系必不可少。相关关系表示两个变量之间的关系,而因果关系是指一个变量对另一个变量产生的直接影响。清楚地理解并分析这两个概念,对于提高研究的准确性非常重要。
相关关系的概念
相关关系以数值形式表示两个变量之间的关系。例如,相关系数表示两个变量之间关系的强度和方向,取值介于-1到1之间。相关系数的绝对值越接近1,表示两个变量之间的关系越强;越接近-1,表示强负相关,越接近1,则表示强正相关。相关系数越接近0,表示两个变量之间的关系越弱。
相关关系的应用
相关关系在许多研究中都有应用,并在数据分析的初期阶段提供重要信息。例如,可以分析学生的学业成就与学习时间之间的相关关系。此时,如果相关系数是较高的正值,就意味着学习时间越多,学业成就往往也越高。这类信息有助于研究者理解数据中的规律。
因果关系的概念
另一方面,因果关系是指一个变量对另一个变量产生的直接影响。它主要在实验研究中探讨,分析自变量与因变量之间的直接关系。例如,可以分析某种药物(自变量)对患者病情(因变量)的影响。由此可以清楚地评估药物的效果。
相关关系与因果关系的区分
相关关系与因果关系容易混淆,但必须明确区分。存在相关关系意味着两个变量之间存在某种关系,但并不一定意味着存在因果关系。例如,冰淇淋销量与水上事故数量之间相关性很高,但不能因此认为冰淇淋的销售直接导致了水上事故。这只是表明两个变量之间存在相关关系而已。
用于分析因果关系的实验研究
因果关系主要通过受控的实验研究来确认。实验研究是研究者操纵自变量,并观察因变量随之发生的变化的方法。由此可以明确两个变量之间的直接关系。例如,为了分析某一特定教育项目(自变量)对学生学业成就(因变量)的影响,可以开展实验研究。
实验研究的重要性
实验研究是明确因果关系最直接的方法。研究者通过操纵自变量并观察因变量随之发生的变化,可以确认两个变量之间的直接关系。由此,研究者能够得出更准确的结论。
相关关系与因果关系的分析方法
分析相关关系与因果关系的方法有多种。相关分析以数值形式表示两个变量之间的关系,实验研究则确认两个变量之间的直接影响。恰当地运用这些方法来提高研究的准确性非常重要。
将相关关系与因果关系加以区分并进行分析,研究者就可以理解数据中的规律,并明确两个变量之间的关系。因此,透彻理解相关关系与因果关系的概念及分析方法,并在研究中加以恰当运用,是非常重要的。
统计分析中的变量选择:方法与标准
 在统计分析中如何选择变量?
变量选择的重要性
在统计分析中,变量选择是决定研究成败的重要过程。明确设定变量选择的方法与标准,对于提高研究的效度和信度必不可少。因此,理解变量选择的各种方法与标准并加以恰当应用非常重要。
与研究目的的相关性
变量选择的第一个标准是与研究目的的相关性。研究者应选择能够支持其所设定的研究问题或假设的变量。例如,在健康研究中分析吸烟对肺癌发生的影响时,应选择是否吸烟和是否发生肺癌作为主要变量。这些变量符合研究目的,是相关性较高的变量。
数据可得性
变量选择的第二个标准是数据的可得性。研究者可以使用的数据必须充足且可靠。为此,需要明确数据的收集方法和来源,并对数据质量进行审查。例如,通过问卷调查收集数据时,应确认受访者是否认真作答以及数据是否一致。
统计显著性
变量选择的第三个标准是统计显著性。所选变量应能够得出具有统计显著性的结果。为此,需要通过预先分析掌握变量的分布与关系,并进行统计检验。例如,通过回归分析考察自变量与因变量之间的关系,并选择显著的变量。
避免多重共线性
变量选择的第四个标准是避免多重共线性(multicollinearity)。多重共线性会因自变量之间的高度相关而降低分析结果的可靠性。为防止这一问题,应分析自变量之间的相关关系,并选择能够避免多重共线性的变量。例如,在回归分析中可以利用方差膨胀因子(VIF)来检查多重共线性。
实际效度
变量选择的第五个标准是实际效度。也就是说,所选变量必须与研究对象确实相关。这是帮助研究结果能够应用于实际情境的重要因素。例如,在教育研究中分析学生的学业成就时,应选择确实会影响学业成就的变量。
反复而系统的方法
最后,变量选择的过程需要采取反复而系统的方法。即使一开始考虑了许多变量,也应通过分析逐步选出合适的变量,并以此构建最佳的研究设计。这一过程对于提高研究的效度和信度起着重要作用。
综合运用变量选择标准的实例
健康研究
- 与研究目的的相关性:选择是否吸烟和是否发生肺癌作为主要变量。
- 数据可得性:利用医院记录和患者问卷调查数据。
- 统计显著性:通过回归分析考察显著的关系。
- 避免多重共线性:分析吸烟以外其他生活习惯变量之间的相关关系。
- 实际效度:选择与肺癌发生直接相关的变量。
教育研究
- 与研究目的的相关性:特定教育项目与学生的学业成就。
- 数据可得性:利用学校记录和成绩数据。
- 统计显著性:进行检验项目效果的统计检验。
- 避免多重共线性:分析教育项目以外学生背景变量之间的相关关系。
- 实际效度:选择影响学业成就的变量。
变量选择是决定研究方向的重要过程。通过变量选择,研究者可以收集可靠的数据,并得出有意义的结果。透彻理解并运用变量选择的各种标准,是研究取得成功的关键。
变量在统计学中起着非常重要的作用。深入理解变量的概念与定义、自变量与因变量的区别及应用实例、统计分析中选择变量的方法与标准,以及变量之间的相关关系与因果关系,对于提高研究的准确性和效度必不可少。
正确理解和运用变量,是为数据分析打下基础的重要过程。因此,需要时刻牢记变量的重要性,并努力将其恰当地应用于研究之中。今后,通过对变量的持续研究与理解,我们将能够开展更加可靠的数据分析。