現代社会において、データは企業や組織の中核となる資産として位置づけられています。データをどのように収集し、保存し、管理するかによって、ビジネスの成否が分かれることもあります。こうした状況の中、データベースへの理解と効率的なデータ管理戦略の重要性は、かつてないほど高まっています。
本資料では、データベースの基本概念をはじめ、データ管理の重要性、データベースの設計と最適化戦略、さらにはセキュリティとアクセス管理の方法まで、幅広く掘り下げて解説します。これにより、データ管理を体系的に行うための基盤を整えることを目指します。
データベースの基本概念と構造を理解する
データベースの基本概念と役割
データベースは、データを体系的に保存・管理するためのシステムであり、企業や組織がデータを効率的に管理するうえで不可欠な役割を果たします。データを保存するだけでなく、重複を最小限に抑えて一貫性を維持することにも貢献し、さまざまなアプリケーションのデータ保存先として機能します。データを効率的に管理するこのシステムを通じて、情報の一貫性を保ち、必要なデータを迅速に取得できるようになります。
データベースの構造:テーブル、列、行、インデックス
データベースは、基本的にテーブル、列、行、インデックスなどで構成されます。テーブルはデータを保存する基本単位であり、列はデータを区別する属性、行は実際のデータを意味します。インデックスは検索速度を高めるために、頻繁に参照される列に対して追加で設定する構造です。こうした構造により、データを論理的に区分し、効率的な保存と検索が可能になります。
DBMS:データベース管理システムの役割
データベース管理システム(DBMS)は、データの作成、保存、検索、更新に必要なソフトウェアであり、データベースの運用全般を管理します。DBMSは、ユーザーがデータを効果的に扱えるようにし、データの整合性とセキュリティを維持する役割を担います。代表的なDBMSには、Oracle、MySQL、Microsoft SQL Serverなどがあります。これらのソフトウェアは、さまざまな環境でデータベースの性能を最大限に引き出し、データの管理と保全における重要なツールとして使用されています。
データモデリング:データベース設計に不可欠なプロセス
データモデリングは、データベース設計における重要な段階であり、データベースの構造を定義し、データ間の関係を明確に可視化するプロセスです。これにより、データをどのように保存・処理するかを明確に把握でき、効率的なデータ管理とシステム設計が可能になります。エンティティ(Entity)、属性(Attribute)、関係(Relationship)などを定義してデータの流れを視覚的に表現し、それを基にデータベース全体の構造を設計します。
リレーショナルデータベースの特徴と利点
リレーショナルデータベースは、データをテーブル形式で保存し、SQLという言語を通じて管理します。リレーショナルデータベースは、データを論理的に関連づけて保存することで、データ間の一貫性と整合性を保証します。複雑なデータクエリを効率的に処理できるため、さまざまなビジネス環境で最も広く使用されているデータベースの種類です。また、データの重複を最小限に抑え、データの整合性を維持するうえで大きな利点があります。
非リレーショナルデータベースの柔軟性
非リレーショナルデータベース(NoSQL)は、リレーショナルデータベースが持つ限界を補うために登場した種類です。特に、大規模なデータ処理や柔軟なデータモデリングが必要な場合に適しています。MongoDB、Cassandra、Redisなどは非リレーショナルデータベースの代表例であり、スキーマレス(Schema-less)構造によってデータの柔軟性を最大限に高めます。データの形式が流動的な場合や、大規模な分散環境でデータ処理が必要な場合に、非リレーショナルデータベースは強みを発揮します。
データベースのインデックス:検索速度を向上させるツール
インデックスは、データベースで高速な検索を可能にするツールです。特定の列にインデックスを作成すると、その列を基準としてデータを素早く検索できます。ただし、インデックスを使用する際には注意が必要です。インデックスには検索速度を高める利点がある一方、データの挿入、修正、削除の際に追加のオーバーヘッドが発生する可能性があるためです。そのため、インデックスは慎重に設計することが重要です。
効率的なデータ管理の重要性を分析する
効率的なデータ管理の重要性
効率的なデータ管理は、現代企業の競争力を左右する中核的な要素です。データ量が指数関数的に増加する中、それをどのように管理するかによって、企業の情報活用や意思決定の水準が変わります。効果的なデータ管理により、情報提供が迅速になり、運用コストが削減され、正確な意思決定を支援できます。この点で、効率的なデータ管理は組織を成功に導く重要な基盤となります。
データの重複排除と一貫性の維持
データの重複排除と一貫性の維持が重要なのは、データの整合性を確保するためです。同じデータが複数の場所に保存されていると、更新時に一貫性が損なわれるリスクが高くなります。こうした問題を防ぐには、データの重複を最小限に抑え、一元的に管理することが不可欠です。これにより、データの信頼性を維持し、データに基づく意思決定の過程で誤りを減らせます。
データ管理とビジネスインテリジェンス
効率的なデータ管理は、ビジネスインテリジェンス(BI)とデータ分析の基礎となります。データを適切に管理し、構造化すれば、組織はデータから有意義な知見を引き出せます。これは、戦略的な意思決定や新たなビジネス機会の発見に役立ちます。データ分析を通じた情報の活用は、企業の競争力を強化し、新たな成長の原動力を生み出す重要な要素となります。
データライフサイクル管理
データライフサイクル管理は、データを生成から削除まで体系的に管理するプロセスです。これにより、データの価値と品質を維持し、効率的に管理できます。データライフサイクルには、データの保存期間を設定し、必要に応じてアーカイブを行い、使用されなくなったデータを安全に削除するといったプロセスが含まれます。これにより、データの活用度を高め、不要なデータの蓄積を防いで、システムの効率性を維持します。
データ品質管理の重要性
データ品質管理も、効率的なデータ管理の重要な要素です。データの正確性、完全性、一貫性は、データ品質を評価する主要な指標であり、データに基づく意思決定の信頼性向上に貢献します。高いデータ品質を維持すれば、企業内のすべての部門がデータを効率的に使用でき、全体的な成果の向上につながります。データ品質が確保された状態で意思決定を行うことは、企業の成功の可能性を大きく高めます。
データ管理の自動化による効果
データ管理の自動化は、データ管理の効率を最大限に高めるうえで重要な役割を果たします。自動化ツールを活用して、データの収集、変換、ロード(ETL)などのプロセスを自動処理すれば、手作業で発生しうる誤りを減らし、処理速度も向上させられます。これにより、データ管理の過程で正確性と迅速性を同時に実現でき、データ処理の効率を高めることで、企業運営全般に好影響をもたらします。
データベース構文の整理
データベース構文の重要性
データベース構文は、データベースでデータを操作・管理するために必要な規則とコマンドの集合です。これを通じてデータベースとやり取りし、データを効率的に処理できます。データベース構文を十分に理解して活用することは、データベース運用に不可欠な要素であり、データの正確な入力、修正、削除や、必要な情報の迅速な取得を可能にします。
SQL構文の基本構造
最も広く使用されているデータベース構文として、SQL(Structured Query Language)があります。SQLはデータを定義・操作するための言語であり、データベース内のデータを検索、挿入、削除、更新するコマンドで構成されます。SQLの基本構造は、SELECT、INSERT、UPDATE、DELETEなどのコマンドからなり、これらを通じてユーザーはテーブルに保存されたデータを目的に合わせて管理できます。例えば、SELECT文はデータの検索に使用され、INSERT文は新しいデータをテーブルに追加する際に使われます。
データ定義言語(DDL)
DDL(Data Definition Language)は、データベースの構造を定義するために使用するコマンド群であり、テーブルの作成、修正、削除を可能にします。代表的なDDLコマンドには、CREATE、ALTER、DROPなどがあります。CREATE文は新しいテーブルを作成する際に、ALTER文は既存のテーブルの構造を変更する際に、DROP文はテーブルやデータベース自体を削除する際に使用されます。DDLは、データベース全体の構造を定義・管理する重要な役割を果たします。
データ操作言語(DML)
DML(Data Manipulation Language)は、テーブルに保存されたデータを操作するためのコマンドであり、データの検索、挿入、削除、更新などを行います。代表的なDMLコマンドには、SELECT、INSERT、UPDATE、DELETEがあります。SELECT文は特定の条件に合うデータを検索する際に、INSERT文は新しいデータを追加する際に、UPDATE文は既存のデータを修正する際に、DELETE文は不要なデータを削除する際に使用されます。DMLは、データベース内のデータを直接管理するうえで重要な役割を果たします。
データ制御言語(DCL)
DCL(Data Control Language)は、データベースへのアクセス権限を制御するコマンドであり、ユーザーがデータにアクセスしたり操作したりする権限を付与・取り消すことができます。代表的なDCLコマンドには、GRANTとREVOKEがあります。GRANT文は、特定のユーザーにデータベースの特定の操作を実行する権限を付与する際に使用され、REVOKE文は、すでに付与された権限を取り消す際に使用されます。これにより、データベース内のセキュリティを強化し、必要なユーザーにのみ適切な権限を付与できます。
トランザクション制御言語(TCL)
TCL(Transaction Control Language)は、データベースでトランザクションを制御するために使用するコマンドです。トランザクションはデータベースにおける作業の単位であり、その中で複数のコマンドが実行され、結果はすべて成功するか、すべて失敗する必要があります。代表的なTCLコマンドには、COMMIT、ROLLBACK、SAVEPOINTなどがあります。COMMITは、トランザクションで行った変更を永続的に保存するために使用され、ROLLBACKは、トランザクションが失敗した際に変更内容を元の状態に戻します。SAVEPOINTは、トランザクション内の特定の時点を保存し、必要に応じてその時点に戻れるようにします。
条件文と関数の活用
データベース構文には、条件文と関数も含まれます。条件文は、特定の条件に合うデータを選択したり、演算を行ったりするために使用され、WHERE句で条件を指定できます。例えば、「年齢が30歳以上の人」という条件でデータを絞り込めます。また、SQLには多数の組み込み関数があり、データの集計や変換に活用できます。例えば、COUNT関数は特定の条件に合うデータの件数を返し、SUM関数は数値列の合計を計算するために使用されます。
データベース構文の実例
データベース構文の理解を深めるために実例を見ると、データベースでさまざまな操作をどのように実行するのかが明確になります。例えば、SELECT文で特定のデータを検索する場合を見てみましょう。'employees'テーブルから、年齢が30歳以上の従業員の名前と年齢を取得したい場合は、次のようなSQL文を使用できます。
SELECT name, age
FROM employees
WHERE age >= 30;
この例は、'employees'というテーブルからageが30以上のすべての行を探し、該当する従業員のnameとageの値を返すクエリです。このようなSQL文は非常に直感的であり、データベースから目的のデータを素早く取得するのに役立ちます。
また、INSERT文を使って新しいデータをテーブルに追加する例も挙げられます。例えば、'employees'テーブルに新しい従業員の情報を追加するには、次のようなSQL文を使用します。
INSERT INTO employees (name, age, department)
VALUES ('John Doe', 29, 'Marketing');
このコマンドは、名前が'John Doe'、年齢が29歳で、'Marketing'部門に所属する従業員の情報を'employees'テーブルに追加します。このようにデータを追加することで、データベースを常に最新の状態に保つことができます。
データベースの設計と最適化戦略
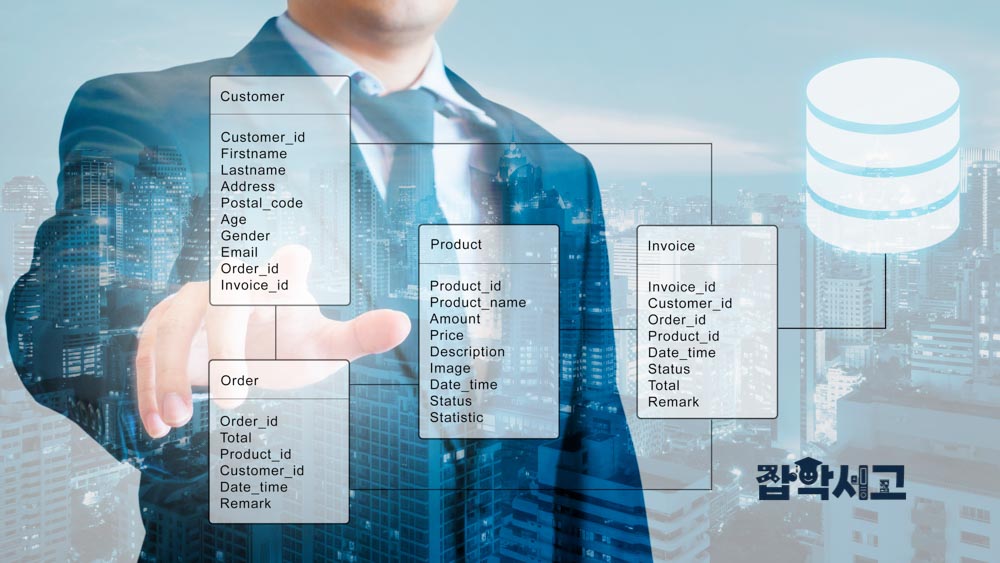
データベース設計の重要性
データベース設計は、データ管理の効率を決定する中核的な要素です。適切に設計されたデータベースは、データの重複を最小限に抑え、一貫性を維持し、性能を最適化できます。そのためには、ビジネスの要件を徹底的に分析し、それを基にデータモデルを慎重に定義することが重要です。データモデルは、組織のデータをどのように保存・管理するかを明確に定める設計段階であり、この段階での誤りは、その後のデータ管理プロセスに大きな影響を及ぼす可能性があります。
正規化:データの重複を最小限に抑える手法
正規化は、データベース設計で最も重要な手法の一つであり、データを複数のテーブルに分割して重複を減らし、整合性を維持するプロセスです。これにより、データが不必要に繰り返し保存されるのを防ぎ、データベースの構造を整理された状態に保てます。正規化は、データの整合性を保証し、データベースの一貫性を維持するうえで不可欠です。ただし、過度に正規化するとクエリが複雑になる可能性があるため、適切な程度に適用することが重要です。
インデックスの最適化:検索性能向上の鍵
データベースのインデックス最適化は、クエリ性能を最大限に高めるための中核的な戦略です。適切に設計されたインデックスにより、データベース内の特定のデータを素早く検索できます。例えば、大きなテーブルから特定の条件に合うデータを探す際、インデックスがなければ、テーブル内のすべてのデータを順番に検索する必要があるため、性能が低下する可能性があります。ただし、インデックスは挿入、削除、更新の際に追加のオーバーヘッドを発生させる可能性があるため、その数と種類を慎重に決定する必要があります。
非正規化:性能向上のためのデータ結合
非正規化は、性能向上を目的として、正規化されたテーブルを再び結合し、データを重複させる戦略です。非正規化は読み取り性能の向上に効果的であり、特に大規模なデータベースで頻繁に発生する検索処理の性能改善に適しています。ただし、データの重複を許容することになるため、書き込み処理で発生するオーバーヘッドを考慮する必要があります。非正規化は、読み取り処理が中心となる環境で、性能を最適化する方法として使用されます。
データパーティショニング:大規模データ管理のための戦略
データパーティショニングは、大規模なデータベースでデータを複数の物理的または論理的な部分に分割して保存する方法です。これにより、データベースの性能を大幅に向上させ、管理の複雑さを軽減できます。パーティショニングの方式には、レンジパーティショニング、ハッシュパーティショニング、リストパーティショニングなどがあり、データの特性に応じて適切な方式を選択します。パーティショニングは、特に大容量のデータを扱う場合に有用であり、クエリ性能の最適化とシステムの負荷軽減に効果的です。
性能監視とチューニング:継続的な最適化
データベースの性能監視とチューニングは、データベースの性能を継続的に最適化するプロセスです。データベース管理者(DBA)は、システムの性能を定期的に点検し、ボトルネックを特定して改善する方法を探る必要があります。性能チューニングには、クエリの最適化、インデックスの再構成、キャッシュの設定などが含まれ、これによりデータベースシステムの効率性と安定性を維持できます。定期的な性能点検とチューニングは、データベースの長期的な性能を保証するうえで重要な役割を果たします。
データベースのセキュリティとアクセス管理の方法
データベースセキュリティの重要性
データベースセキュリティは、データの機密性、整合性、可用性を保護する中核的なプロセスです。データ漏えいや不正アクセスを防ぐには、徹底したセキュリティ体制が必要であり、それによって重要な情報が悪意ある行為から保護されます。データベースセキュリティは、企業や組織の情報保護だけでなく、法規制の遵守にも不可欠な要素です。さまざまなセキュリティ手法を適切に活用することで、データベースシステムを安全に運用できます。
アクセス制御:データ保護の最初の段階
アクセス制御は、データベースセキュリティにおける最初の防衛線であり、ユーザーのデータへのアクセス権限を制限する重要な方法です。これにより、機密情報への不正アクセスを遮断し、各ユーザーに必要最小限の権限だけを付与することで、セキュリティを強化できます。ロールベースのアクセス制御(RBAC)は、こうしたアクセス制御手法の一つであり、ユーザーの役割に応じてアクセス権限を付与する方式です。これにより、組織内のデータアクセスを体系的に管理し、不要なデータアクセスを防止できます。
データ暗号化:機密性保護の中核
データ暗号化は、データを保護するための重要なセキュリティ手法であり、保存時や転送時にデータを暗号化して機密性を維持します。データが暗号化されていれば、たとえ漏えいしても暗号化された状態が保たれるため、権限のないユーザーは内容を理解できません。特に、金融情報や個人情報などの機密性の高いデータは暗号化によって保護する必要があり、個人情報保護規制の遵守においても不可欠です。暗号化は、データを安全に管理するための中核的なツールです。
監査ログ:活動の追跡とセキュリティ脅威への対応
監査ログは、データベース内で発生するすべてのアクセスと変更を記録し、セキュリティ上の脅威を迅速に検知して対応できるようにします。監査ログにより、ユーザーがどのデータにいつアクセスし、どのような変更が発生したかを詳細に追跡できるため、セキュリティ事故が発生した際の原因究明に重要な役割を果たします。また、内部方針が遵守されているかを確認し、セキュリティ方針の実効性を評価するうえでも役立ちます。このシステムを通じて、データベース運用の透明性を維持できます。
セキュリティパッチ管理:システムの脆弱性への対処
セキュリティパッチ管理は、データベースシステムの脆弱性に迅速に対処するための不可欠な手順です。新たなセキュリティ脅威が絶えず出現するため、データベース管理者は、最新のセキュリティパッチを定期的に適用し、システムを安全に保つ必要があります。パッチが適用されていないと、システムが攻撃に対して脆弱になる可能性があるため、継続的な管理がセキュリティ維持の鍵となります。セキュリティパッチ管理は、データベースの安全性を継続的に維持するうえで不可欠な役割を果たします。
データベースのバックアップと復旧計画
バックアップと復旧の計画は、データベースの可用性を保証するための最も重要な戦略の一つです。データの損失はビジネスに致命的な影響を及ぼす可能性があるため、定期的なデータベースのバックアップにより、事故発生時にデータを迅速に復旧できるようにしておく必要があります。バックアップは、日常の運用で予期せぬ障害やデータ破損に備えるための不可欠な対策であり、それを基に復旧手順を体系的に準備することが、データベース運用の継続性を保証する鍵となります。
データベースは、現代企業のデータ管理における中核的なツールとして定着しており、その重要性は日々高まっています。データベースの基本概念と構造を十分に理解し、効率的なデータ管理の必要性を認識したうえで、適切な設計と最適化戦略を適用することで、データベースの性能を最大限に高められます。
さらに、データベースのセキュリティとアクセス管理の方法を通じて、データを安全に保護し、持続可能な管理システムを構築できます。これらすべての要素は、データを価値ある資産へと変えるために不可欠な基盤を提供し、企業の情報戦略を成功へ導く重要な役割を果たすでしょう。