डेटा विश्लेषण व्यवसाय और अनुसंधान में अनिवार्य भूमिका निभाता है। डेटा विश्लेषण से प्राप्त अंतर्दृष्टियाँ निर्णय लेने की प्रक्रिया को बेहतर बनाने, प्रदर्शन सुधारने और नए अवसर खोजने में महत्वपूर्ण भूमिका निभाती हैं।
हालाँकि, सफलतापूर्वक डेटा विश्लेषण करने के लिए विभिन्न उपकरणों और तकनीकों को सही ढंग से समझने और इस्तेमाल करने की क्षमता आवश्यक है। इनमें वर्णनात्मक सांख्यिकी सबसे महत्वपूर्ण उपकरणों में से एक है, जो डेटा विश्लेषण की नींव बनाती है।
इस सामग्री में हम डेटा विश्लेषण के प्रमुख उपकरण वर्णनात्मक सांख्यिकी पर गहराई से चर्चा करेंगे और इसके प्रभावी उपयोग के तरीकों पर विचार करेंगे।
डेटा विश्लेषण के आवश्यक उपकरणों का महत्व समझना
डेटा विश्लेषण के लक्ष्य और उपकरणों का महत्व
डेटा विश्लेषण का मुख्य लक्ष्य डेटा से सार्थक जानकारी प्राप्त करना और उसके आधार पर समस्याएँ हल करना या नए अवसर खोजना है। डेटा की सही व्याख्या के लिए उसे व्यवस्थित करने, उसका दृश्यांकन करने और उसका विश्लेषण करने वाले विभिन्न उपकरणों और तकनीकों की आवश्यकता होती है। ये उपकरण डेटा की विश्वसनीयता और सटीकता सुनिश्चित करने में महत्वपूर्ण भूमिका निभाते हैं। गलत उपकरण चुनने या उसका सही ढंग से उपयोग न करने पर त्रुटियाँ हो सकती हैं, जो व्यावसायिक निर्णयों पर नकारात्मक प्रभाव डाल सकती हैं।
वर्णनात्मक सांख्यिकी की भूमिका और मूल अवधारणाएँ
वर्णनात्मक सांख्यिकी डेटा विश्लेषण के सबसे बुनियादी उपकरणों में से एक है और इसका उपयोग डेटा की विशेषताएँ पहचानने तथा उसका सार प्रस्तुत करने के लिए किया जाता है। इससे डेटा के समग्र वितरण और परिवर्तनशीलता को आसानी से समझा जा सकता है। उदाहरण के लिए, माध्य, माध्यिका और बहुलक डेटा की केंद्रीय प्रवृत्ति दर्शाते हैं, जबकि प्रसरण और मानक विचलन डेटा की परिवर्तनशीलता की व्याख्या करते हैं। इस तरह वर्णनात्मक सांख्यिकी के माध्यम से डेटा की समग्र तस्वीर समझना डेटा विश्लेषण की एक आवश्यक प्रक्रिया है।
डेटा की विश्वसनीयता और सटीकता सुनिश्चित करने वाले उपकरण
डेटा विश्लेषण की विश्वसनीयता और सटीकता उपयुक्त उपकरणों के चयन और उनके सही उपयोग पर निर्भर करती है। उपकरणों का गलत उपयोग विश्लेषण के परिणामों को विकृत कर सकता है, जिससे गलत निर्णय लेने का जोखिम पैदा होता है। इसलिए उपयुक्त उपकरण चुनना महत्वपूर्ण है और यह सही ढंग से समझना आवश्यक है कि डेटा विश्लेषण में प्रत्येक उपकरण क्या भूमिका निभाता है। इस प्रकार उपकरणों की विश्वसनीयता डेटा विश्लेषण के परिणाम सुनिश्चित करने वाला एक महत्वपूर्ण कारक है।
डेटा विश्लेषण के उपकरणों की दक्षता बढ़ाना
बड़े डेटासेट को संसाधित करते समय विश्लेषण प्रक्रिया में दक्षता अत्यंत महत्वपूर्ण होती है। उपयुक्त उपकरणों से विश्लेषण में लगने वाला समय कम किया जा सकता है और जटिल कार्यों को स्वचालित किया जा सकता है। उदाहरण के लिए, Python और R जैसी प्रोग्रामिंग भाषाएँ बड़ी मात्रा में डेटा संसाधित करने और उसका विश्लेषण करने के लिए उपयुक्त हैं तथा इनसे बहुत से कार्यों में हाथ से किए जाने वाले काम को कम किया जा सकता है। ये उपकरण डेटा विश्लेषण की दक्षता काफी बढ़ाते हैं।
डेटा दृश्यांकन का महत्व
डेटा विश्लेषण का एक अन्य महत्वपूर्ण पहलू डेटा दृश्यांकन है। दृश्यांकन से जटिल डेटा को अधिक आसानी से समझा जा सकता है और पैटर्न या रुझान स्पष्ट रूप से पहचाने जा सकते हैं। इससे निर्णय लेने की प्रक्रिया अधिक सहज बनती है और डेटा के आधार पर निर्णय लेने में सहायता मिलती है। डेटा दृश्यांकन डेटा विश्लेषण के अंतिम चरण में महत्वपूर्ण भूमिका निभाता है और डेटा को अधिक आसानी से प्रस्तुत करने में मदद करता है।
सफल डेटा विश्लेषण के लिए आवश्यक उपकरणों को समझना
डेटा विश्लेषण में आवश्यक उपकरणों का महत्व डेटा की विश्वसनीयता, विश्लेषण की दक्षता और दृश्यांकन की सुगमता जैसे विभिन्न पहलुओं में दिखाई देता है। इन उपकरणों का सही चयन और उपयोग सफल डेटा विश्लेषण की कुंजी है। वर्णनात्मक सांख्यिकी सहित विभिन्न उपकरणों का उचित उपयोग डेटा विश्लेषण की सटीकता और दक्षता सुनिश्चित करने के लिए आवश्यक है।
वर्णनात्मक सांख्यिकी की मूल अवधारणाएँ और प्रमुख माप
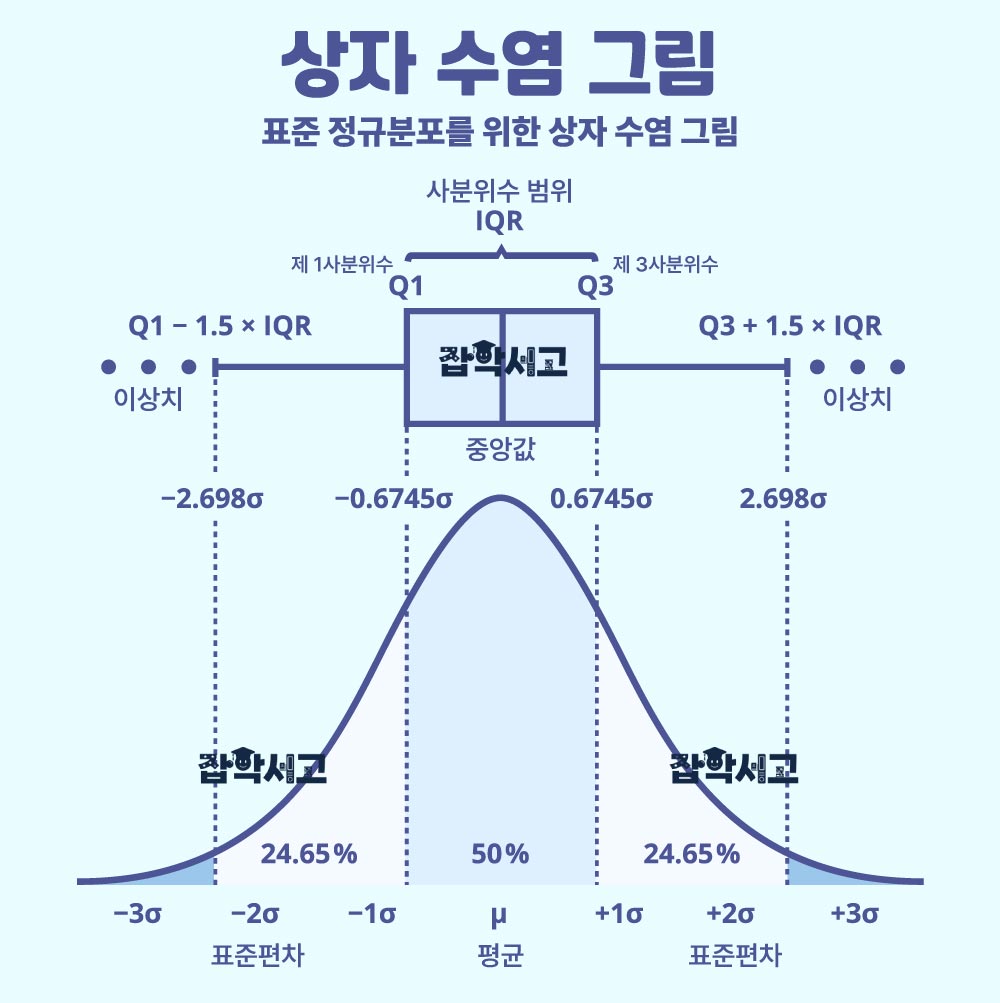
वर्णनात्मक सांख्यिकी की परिभाषा और भूमिका
वर्णनात्मक सांख्यिकी एक महत्वपूर्ण सांख्यिकीय तकनीक है, जिसका उपयोग डेटा विश्लेषण के शुरुआती चरण में किया जाता है। इससे जटिल डेटा का सार प्रस्तुत करके और उसकी बुनियादी विशेषताएँ पहचानकर डेटा की समग्र संरचना को आसानी से समझा जा सकता है। वर्णनात्मक सांख्यिकी डेटा के प्रमुख मापों के माध्यम से उसे सरल और स्पष्ट ढंग से समझाने में मदद करती है और अधिक गहन विश्लेषण की ओर बढ़ने के लिए एक आवश्यक उपकरण है।
केंद्रीय प्रवृत्ति: डेटा के केंद्रीय मान को पहचानना
केंद्रीय प्रवृत्ति डेटा के प्रतिनिधि मान को दर्शाने वाला माप है, जिसका उपयोग डेटा का केंद्र पहचानने के लिए किया जाता है। इसके प्रमुख माप माध्य, माध्यिका और बहुलक हैं। माध्य डेटासेट के सभी मानों को जोड़कर उनकी कुल संख्या से भाग देने पर प्राप्त होता है और पूरे डेटा के प्रतिनिधि मान को दर्शाता है। माध्यिका वह मान है जो डेटा को आकार के क्रम में व्यवस्थित करने पर बीच में आता है और डेटा के विषम होने पर भी केंद्रीय प्रवृत्ति को अच्छी तरह दर्शाता है। बहुलक डेटा में सबसे अधिक बार आने वाला मान है और डेटा की आवृत्ति से जुड़ी महत्वपूर्ण जानकारी प्रदान करता है।
परिवर्तनशीलता: डेटा के फैलाव को मापना
परिवर्तनशीलता दर्शाती है कि डेटा माध्य से कितना बिखरा हुआ है। इसके प्रमुख माप परास, प्रसरण और मानक विचलन हैं। परास डेटासेट के अधिकतम और न्यूनतम मान के बीच का अंतर है, जो डेटा के समग्र फैलाव को दर्शाता है। प्रसरण प्रत्येक डेटा मान की माध्य से दूरी के औसत का वर्ग करके प्राप्त किया जाता है, जबकि मानक विचलन प्रसरण का वर्गमूल होता है और डेटा के वितरण का फैलाव सहज रूप से समझने का एक प्रमुख माप है। अधिक परिवर्तनशीलता का अर्थ है कि डेटा के मान दूर-दूर तक फैले हुए हैं, जबकि कम परिवर्तनशीलता दर्शाती है कि डेटा माध्य के आसपास केंद्रित है।
वितरण: डेटा के पैटर्न को समझना
वितरण एक ऐसी अवधारणा है जो दर्शाती है कि डेटा समग्र रूप से किस तरह फैला हुआ है। इसके प्रमुख प्रकारों में सामान्य वितरण, पॉइसन वितरण और एकसमान वितरण शामिल हैं। सामान्य वितरण सममित और घंटी के आकार का होता है तथा प्रकृति और समाज में अक्सर देखा जाता है। पॉइसन वितरण का उपयोग एक निश्चित समय में होने वाली घटनाओं की संख्या दर्शाने के लिए किया जाता है, जबकि एकसमान वितरण में डेटा के सभी मानों की प्रायिकता समान होती है। वितरण को समझने से डेटा की विशेषताओं की अधिक गहरी समझ मिलती है और विशिष्ट पैटर्न या अपवाद मान आसानी से पहचाने जा सकते हैं।
विषमता और कुर्टोसिस: डेटा की असममिति और वितरण की पूँछों की मोटाई का विश्लेषण
विषमता दर्शाती है कि डेटा का वितरण माध्य के सापेक्ष कितना असममित है। धनात्मक विषमता का अर्थ दाईं ओर झुका वितरण है, जबकि ऋणात्मक विषमता का अर्थ बाईं ओर झुका वितरण है। कुर्टोसिस दर्शाता है कि डेटा वितरण की पूँछें कितनी मोटी हैं; कुर्टोसिस अधिक होने पर पूँछें मोटी और कम होने पर पतली होती हैं। विषमता और कुर्टोसिस का विश्लेषण डेटा वितरण के आकार को अधिक सटीकता से समझने में मदद करता है, जो असामान्य मानों या अपवाद मानों का पता लगाने में उपयोगी है।
डेटा विश्लेषण की नींव मजबूत करना
वर्णनात्मक सांख्यिकी डेटा विश्लेषण का शुरुआती बिंदु है और जटिल डेटा का सार प्रस्तुत करने तथा उसे समझने का एक महत्वपूर्ण उपकरण है। केंद्रीय प्रवृत्ति, परिवर्तनशीलता, वितरण, विषमता और कुर्टोसिस जैसे प्रमुख मापों के माध्यम से डेटा का विभिन्न दृष्टिकोणों से विश्लेषण किया जा सकता है और उसके आधार पर डेटा की मूल प्रकृति समझकर अधिक जटिल विश्लेषण की ओर बढ़ा जा सकता है। वर्णनात्मक सांख्यिकी की मूल अवधारणाओं की अच्छी समझ से डेटा के आधार पर बेहतर निर्णय लिए जा सकते हैं और विश्लेषण के परिणामों की विश्वसनीयता तथा सटीकता भी बढ़ती है।
वर्णनात्मक सांख्यिकी से डेटा संबंधी अंतर्दृष्टियाँ प्राप्त करने के तरीके
वर्णनात्मक सांख्यिकी के माध्यम से डेटा विश्लेषण का पहला कदम
वर्णनात्मक सांख्यिकी का उपयोग करके डेटा विश्लेषण की शुरुआत डेटा एकत्र करने और व्यवस्थित करने के बाद उसकी बुनियादी विशेषताएँ पहचानने से होती है। डेटा को सही ढंग से समझने के लिए पहले केंद्रीय प्रवृत्ति, परिवर्तनशीलता और वितरण जैसे प्रमुख मापों का विश्लेषण करना आवश्यक है। यह प्रक्रिया डेटा के समग्र रुझान पहचानने और उसका कुशलतापूर्वक सार प्रस्तुत करके अंतर्दृष्टियाँ प्राप्त करने में महत्वपूर्ण भूमिका निभाती है।
केंद्रीय प्रवृत्ति का विश्लेषण: डेटा के प्रतिनिधि मान को पहचानना
केंद्रीय प्रवृत्ति का विश्लेषण वह चरण है जिसमें डेटा का प्रतिनिधित्व करने वाले मान को पहचाना जाता है। माध्य, माध्यिका और बहुलक अलग-अलग तरीकों से डेटा के केंद्र की व्याख्या करते हैं। उदाहरण के लिए, ग्राहकों की औसत खरीद राशि की गणना से पता चलता है कि अधिकांश ग्राहक कितना खर्च करते हैं, जबकि माध्यिका चरम मानों से प्रभावित नहीं होती और डेटा के बीच का मान दर्शाती है। बहुलक का विश्लेषण करके सबसे अधिक बार आने वाला मान, अर्थात डेटा की आवृत्ति, जानी जा सकती है। इस प्रक्रिया से डेटा की केंद्रीय विशेषताओं को समझकर महत्वपूर्ण निर्णय लिए जा सकते हैं।
परिवर्तनशीलता का विश्लेषण: डेटा के फैलाव और एकरूपता का मूल्यांकन
परिवर्तनशीलता का विश्लेषण यह मापने का एक महत्वपूर्ण तरीका है कि डेटा माध्य से कितना फैला हुआ है। अधिक मानक विचलन का अर्थ है कि डेटा माध्य के आसपास व्यापक रूप से फैला है और अलग-अलग मानों में अधिक परिवर्तनशीलता है। इसके विपरीत, कम मानक विचलन दर्शाता है कि डेटा माध्य के पास केंद्रित है, जो डेटा की एकरूपता को दर्शाता है। पूर्वानुमान मॉडल बनाते समय परिवर्तनशीलता को समझना आवश्यक है और इससे डेटा की स्थिरता का मूल्यांकन करने के लिए महत्वपूर्ण जानकारी मिलती है।
डेटा वितरण का विश्लेषण: हिस्टोग्राम और बॉक्स प्लॉट से दृश्य रूप में समझना
डेटा के वितरण का दृश्य विश्लेषण उसे समझने में बहुत मदद करता है। हिस्टोग्राम और बॉक्स प्लॉट (box plot) जैसे दृश्यांकन उपकरण आसानी से दर्शाते हैं कि डेटा कैसे फैला हुआ है, वह सामान्य वितरण का अनुसरण करता है या असममित है। इससे डेटा की विशेषताओं को सहज रूप से समझा जा सकता है और अपवाद मानों या वितरण की असममिति का पता लगाया जा सकता है।
अनुपस्थित मानों और अपवाद मानों की पहचान: डेटा की गुणवत्ता बढ़ाना
अनुपस्थित मान (missing values) और अपवाद मान (outliers) डेटा विश्लेषण के महत्वपूर्ण तत्व हैं। अनुपस्थित मान डेटा की पूर्णता को प्रभावित कर सकते हैं और उनका समाधान न करने पर विश्लेषण के परिणामों पर नकारात्मक प्रभाव पड़ सकता है। अपवाद मान वे मान हैं जो डेटा के पैटर्न से अलग होते हैं और विश्लेषण के परिणामों को विकृत कर सकते हैं। अनुपस्थित मानों का उचित समाधान करके तथा अपवाद मानों का विश्लेषण करके और आवश्यकता पड़ने पर उन्हें हटाकर डेटा की गुणवत्ता बढ़ाई जा सकती है।
सहसंबंध विश्लेषण: चरों के बीच संबंध समझना
सहसंबंध (correlation) विश्लेषण का उपयोग दो चरों के बीच संबंध पहचानने के लिए किया जाता है। सहसंबंध गुणांक जितना अधिक होता है, दोनों चरों के बीच संबंध उतना ही मजबूत होता है, जिससे पूर्वानुमान मॉडल की विश्वसनीयता बढ़ाई जा सकती है। सहसंबंध विश्लेषण विशेष रूप से परिकल्पना परीक्षण और पूर्वानुमान मॉडल बनाने में महत्वपूर्ण भूमिका निभाता है।
दृश्यांकन से परिणाम प्रस्तुत करना: स्पष्ट जानकारी देना
वर्णनात्मक सांख्यिकी से प्राप्त विश्लेषण के परिणाम दृश्यांकन उपकरणों के माध्यम से स्पष्ट रूप से प्रस्तुत किए जा सकते हैं। जटिल डेटा को आसानी से समझने के लिए दंड आलेख, रेखा आलेख और पाई चार्ट आदि से विश्लेषण के परिणामों को दृश्य रूप में प्रस्तुत करने पर निर्णयकर्ताओं को अधिक स्पष्ट और सहज जानकारी दी जा सकती है। दृश्यांकन डेटा विश्लेषण के परिणामों को प्रभावी ढंग से संप्रेषित करने का एक महत्वपूर्ण उपकरण है।
वर्णनात्मक सांख्यिकी से प्राप्त डेटा संबंधी अंतर्दृष्टियों का महत्व
वर्णनात्मक सांख्यिकी के माध्यम से डेटा की केंद्रीय प्रवृत्ति, परिवर्तनशीलता, वितरण, अनुपस्थित मानों, अपवाद मानों और सहसंबंध आदि का विश्लेषण करने से डेटा की गहरी समझ प्राप्त होती है। इस विश्लेषण के आधार पर प्राप्त अंतर्दृष्टियाँ महत्वपूर्ण निर्णय लेने या पूर्वानुमान मॉडल बनाने में आवश्यक भूमिका निभाती हैं। साथ ही, दृश्यांकन उपकरणों से जटिल जानकारी को स्पष्ट रूप से प्रस्तुत करके डेटा पर आधारित निर्णय लेने की प्रक्रिया की दक्षता बढ़ाई जा सकती है।
व्यावहारिक परिस्थितियों में वर्णनात्मक सांख्यिकी का उपयोग
डेटा संग्रह और पूर्वप्रसंस्करण: विश्लेषण की शुरुआत
वर्णनात्मक सांख्यिकी लागू करने के लिए सबसे पहले डेटा एकत्र करना और उसका पूर्वप्रसंस्करण करना होता है। उदाहरण के लिए, किसी ऑनलाइन शॉपिंग स्टोर में ग्राहक ID, खरीद की तारीख, खरीद राशि और खरीदे गए उत्पादों का डेटा एकत्र किया जा सकता है। डेटा एकत्र करने के बाद उसकी गुणवत्ता जाँचना और अनुपस्थित मानों या त्रुटियों का समाधान करना आवश्यक है। डेटा के प्रारूप को एकसमान बनाना और अपवाद मानों या अनुपस्थित मानों का समाधान करना जैसी पूर्वप्रसंस्करण प्रक्रियाएँ सफल विश्लेषण की नींव होती हैं।
केंद्रीय प्रवृत्ति का विश्लेषण: ग्राहकों के खर्च के पैटर्न पहचानना
इसके बाद वर्णनात्मक सांख्यिकी से डेटा की केंद्रीय प्रवृत्ति का विश्लेषण किया जा सकता है। खरीद राशि के माध्य, माध्यिका और बहुलक की गणना करके देखा जाता है कि ग्राहक औसतन कितना खर्च करते हैं। उदाहरण के लिए, यदि ग्राहकों की औसत खरीद राशि 50,000 वॉन है, तो माना जा सकता है कि अधिकांश ग्राहक लगभग इतनी राशि खर्च करते हैं। साथ ही, माध्यिका से बीच के मान का पता लगाने पर ऐसी अंतर्दृष्टि मिल सकती है जो चरम मानों से प्रभावित नहीं होती। बहुलक सबसे अधिक बार आने वाली राशि को दर्शाता है और खर्च के प्रमुख पैटर्न दिखाता है।
परिवर्तनशीलता का विश्लेषण: खरीद के पैटर्न की विविधता समझना
ग्राहकों के खर्च की राशि में कितनी विविधता है, यह जानने के लिए परिवर्तनशीलता का विश्लेषण आवश्यक है। मानक विचलन से देखा जा सकता है कि खरीद राशि माध्य के आसपास कितनी फैली हुई है। अधिक मानक विचलन दर्शाता है कि ग्राहकों की खर्च राशि में बड़ा अंतर है और यह कुछ ग्राहकों द्वारा अधिक राशि खर्च किए जाने का संकेत हो सकता है। इससे खरीद के पैटर्न की विविधता का विश्लेषण किया जा सकता है और विपणन रणनीति बनाने के लिए महत्वपूर्ण जानकारी प्राप्त की जा सकती है।
डेटा वितरण का दृश्यांकन: हिस्टोग्राम से अंतर्दृष्टियाँ
हिस्टोग्राम जैसे दृश्यांकन उपकरणों से खरीद राशि के वितरण का विश्लेषण करने पर आसानी से पता लगाया जा सकता है कि डेटा सामान्य वितरण का अनुसरण करता है या उसका वितरण असममित है। उदाहरण के लिए, यदि कुछ ग्राहक अधिक राशि खर्च करते हैं, तो हिस्टोग्राम में लंबी दाईं पूँछ वाला वितरण दिखाई देगा। ऐसे दृश्यांकन से डेटा के समग्र वितरण को अधिक सहज ढंग से समझा जा सकता है और अधिक खर्च करने वाले ग्राहकों को लक्षित करने वाली विपणन रणनीतियाँ बनाई जा सकती हैं।
अपवाद मानों और अनुपस्थित मानों का समाधान: डेटा की गुणवत्ता सुधारना
अपवाद मानों और अनुपस्थित मानों का समाधान करना विश्लेषण की सटीकता बढ़ाने की एक महत्वपूर्ण प्रक्रिया है। अपवाद मान डेटा के समग्र पैटर्न से अलग मान होते हैं, जिन्हें हटाने या अलग से विश्लेषित करने की आवश्यकता होती है। उदाहरण के लिए, यदि कुछ ग्राहकों की खरीद राशि असामान्य रूप से अधिक है, तो इस डेटा की जाँच करके पता लगाया जा सकता है कि क्या इसका कारण कोई विशेष आयोजन या प्रचार अभियान है। अनुपस्थित मान विश्लेषण के परिणामों को प्रभावित कर सकते हैं, इसलिए उनके समाधान के लिए उचित तरीके तय करना आवश्यक है।
सहसंबंध विश्लेषण: चरों के बीच संबंध पहचानना
खरीद राशि और खरीद की आवृत्ति के बीच सहसंबंध का विश्लेषण करके दोनों चरों का संबंध पहचाना जा सकता है। अधिक सहसंबंध गुणांक का अर्थ है कि अधिक बार खरीदारी करने वाले ग्राहक अधिक राशि खर्च करने की प्रवृत्ति रखते हैं। इससे बार-बार खरीदारी करने वाले ग्राहकों की पहचान की जा सकती है और VIP ग्राहकों के लिए उनकी जरूरतों के अनुरूप विपणन रणनीतियाँ बनाई जा सकती हैं। डेटा के आधार पर निर्णय लेने में सहसंबंध विश्लेषण अत्यंत महत्वपूर्ण भूमिका निभाता है।
व्यावहारिक परिस्थितियों में वर्णनात्मक सांख्यिकी के उपयोग के लाभ
वास्तविक डेटा विश्लेषण में वर्णनात्मक सांख्यिकी का उपयोग करके डेटा का प्रभावी ढंग से सार प्रस्तुत और विश्लेषण किया जा सकता है, जिससे सार्थक अंतर्दृष्टियाँ प्राप्त होती हैं। ये अंतर्दृष्टियाँ व्यावसायिक प्रदर्शन सुधारने और डेटा के आधार पर निर्णय लेने में महत्वपूर्ण भूमिका निभाती हैं। ग्राहकों के व्यवहार को गहराई से समझने और उनकी जरूरतों के अनुरूप रणनीतियाँ बनाने में वर्णनात्मक सांख्यिकी व्यावहारिक रूप से बहुत उपयोगी होती है।
वर्णनात्मक सांख्यिकी एक महत्वपूर्ण उपकरण है, जो डेटा विश्लेषण की नींव बनाती है। इससे डेटा की बुनियादी विशेषताएँ समझकर, उसकी परिवर्तनशीलता और वितरण का विश्लेषण करके तथा सहसंबंध पहचानकर सार्थक अंतर्दृष्टियाँ प्राप्त की जा सकती हैं।
यह प्रक्रिया डेटा के आधार पर निर्णय लेने के लिए आवश्यक है और वर्णनात्मक सांख्यिकी की सही समझ तथा उचित उपयोग डेटा विश्लेषण की सटीकता और दक्षता बढ़ाने में योगदान देंगे। अंततः यह व्यावसायिक प्रदर्शन सुधारने में महत्वपूर्ण भूमिका निभाएगा।