假设某家地方报纸刊登了一篇报道,称“收入越高的地区,某个政党的支持率就越高”。许多人读完后会自然而然地想:“原来有钱人喜欢那个政党。”然而,如果真的逐一调查每个人,有时却会得到截然相反的结果。把群体的数字原封不动地套到个人身上时产生的这种错觉,就是“生态谬误(Ecological Fallacy)”。
简单来说,生态谬误是指把以地区、国家、学校等群体为单位收集的数据所得出的结论,推断为同样适用于属于该群体的每个人的错误。这里的“生态学”并非指生物学,而是一个统计术语,指的是围绕个人的群体层面的数据。
本文将依次探讨生态谬误这一名称的由来、群体数据与个人数据出现分歧的原理、现实中经常遇到的实例,以及避开这一陷阱的方法。
群体的数字为何无法代替个人
“生态谬误”这一名称的由来
生态谬误是在一位社会学家重新计算美国人口普查数据之后才广为人知的。
(1) 罗宾逊1950年的论文
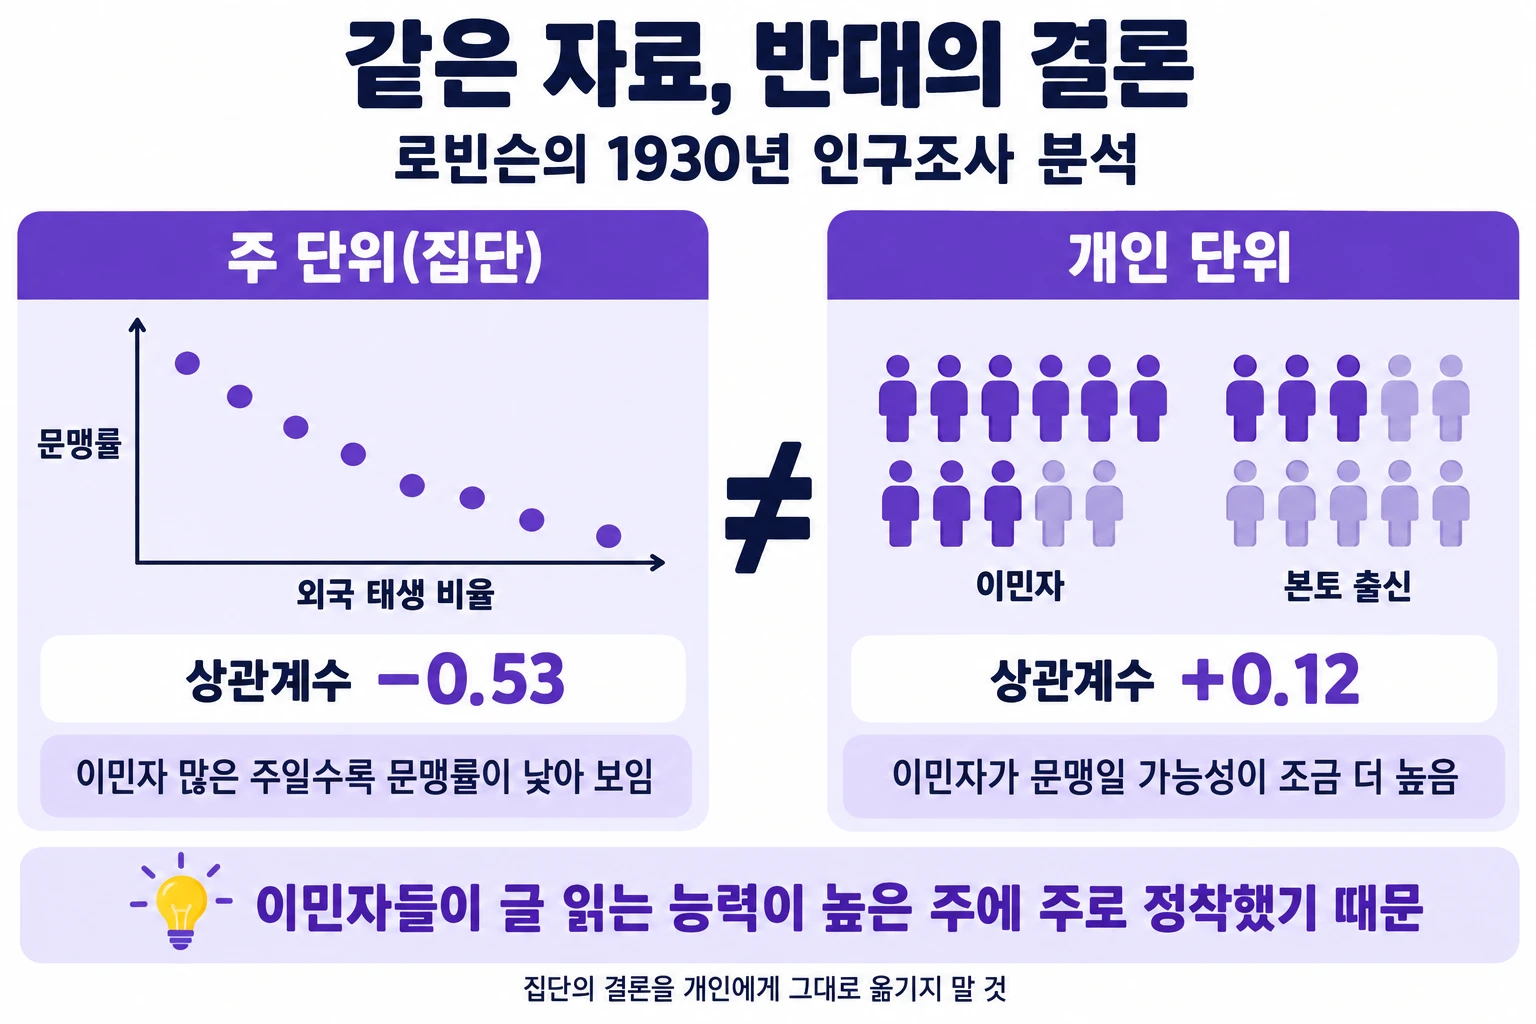
美国社会学家威廉·罗宾逊(William S. Robinson)利用1930年人口普查数据,逐州比较了外国出生人口的比例与文盲率。以州为单位来看,移民越多的州,文盲率反而显得越低。然而以个人为单位重新计算后,却得出了方向相反的结果:移民比本土出生者成为文盲的可能性略高。州层面的相关系数为负0.53,而个人层面的相关系数为正0.12。2011年有一项重新审视指出,罗宾逊在州层面计算中使用的部分数据有误,正确值应为负0.46,但方向发生反转这一核心结论依然不变。
(2) 出现分歧的原因
罗宾逊解释说,之所以出现这种差异,是因为移民主要定居在本土出生居民读写能力较高的州。可以说,群体的特征掩盖了个人的特征。
(3) 名称的确立
罗宾逊警告不要用群体数据来判断个人,而为这种错觉取名为“生态谬误”的,是1958年的统计学家哈南·塞尔文(Hanan Selvin)。
群体数据与个人数据出现分歧的原理
群体的平均值或比例是把许多人的数值笼统地合并为一个结果,因此无法显示个人在其中是如何分布的。
(1) 相关关系的层次差异
以群体为单位计算的相关关系被称为生态相关。这个值与个人层面的相关关系相比,不仅大小可能不同,连方向都可能不同。
(2) 平均值高并不代表可能性也高
假设A组有80%的人得40分、20%的人得95分,平均分为51分;B组一半人得45分、一半人得55分,平均分为50分。虽然A组的平均分更高,但如果从两组中各抽一人进行比较,在80%的情况下,B组的人得分更高。
(3) 群体本身产生的影响
如果个人的行为不仅受自身条件影响,也受周围群体氛围的影响,那么群体层面的关系与个人层面的关系就会呈现出不同的面貌。
在合并或拆分群体的瞬间趋势就发生反转的辛普森悖论,也是同根同源的现象,在统计学中有时被视为生态谬误的一个分支一并讨论。归根结底,关键在于在哪个层次上汇总数据,可能会改变结论本身。
生活中遇到的生态谬误
生态谬误隐藏在新闻、研究和日常对话的各个角落。
- 富裕的州与富裕的选民(Rich states and rich voters):在2004年美国总统选举中,布什赢得了最贫穷的15个州,而克里则在最富裕的11个州中赢得了9个。但以个人为单位来看,年收入超过20万美元的选民中有62%投票给了布什,比例远高于低收入选民。
- 涂尔干的自杀研究(Durkheim’s study of suicide):根据新教徒较多的地区自杀率较高这一结果,就断定新教徒个人的风险更高,这经常被列为生态谬误的典型例子。
- 各国的饮食习惯与健康(Diet and health by country):某种食物吃得多的国家平均寿命较长,并不意味着吃这种食物的人就会长寿。
由此可见,即使是相同的数据,从哪个层次去看,也可能讲出完全不同的故事。
避开生态谬误的方法
要避开生态谬误,在下结论之前,首先要确认数据是在哪个层次上收集的。
(1) 使问题与数据的层次一致
想了解个人,就要使用个人数据;想了解地区或国家,就要使用群体数据。问题的层次与数据的层次一旦错位,谬误就有了可乘之机。
(2) 同时考察多个层次的分析
也有一些统计方法会把两个层次放进同一个模型中加以区分,例如同时考量个人与群体影响的多层次分析。
(3) 也要警惕反方向的陷阱
反过来,只看个人数据就断定整个群体特征的错误也存在。这被称为原子谬误(Atomistic Fallacy),是与生态谬误相对应的概念。
生态谬误并不是因为数字错了,而是因为解读数字的视角错位而产生的错觉。群体的平均值只能说明群体,并不能代替其中的某一个人说话。
每次看统计数据时,先问一问这些数字是以谁为单位收集的,这就是正确解读数据的第一步。