
섬을 줄지어 찍어내는 땅속 불씨, 열점(Hotspot)
어느 지역 신문에 “소득이 높은 지역일수록 특정 정당 지지율이 높다”는 기사가 실렸다고 가정해 보겠습니다. 많은 사람이 이 기사를 읽고 자연스럽게 “부자들은 그 정당을 좋아하는구나”라고 생각합니다. 그런데 실제로 사람 한 명 한 명을 조사해 보면 정반대의 결과가 나오기도 합니다. 집단의 숫자를 그대로 개인에게 옮겨 붙일 때 생기는 이 착각이 바로 ‘생태학적 오류(Ecological Fallacy)’입니다.
생태학적 오류란 쉽게 말해 지역이나 국가, 학교 같은 집단을 단위로 모은 자료에서 얻은 결론을 그 집단에 속한 개인에게도 똑같이 들어맞는다고 추론하는 잘못을 의미합니다. 여기서 ‘생태학적’이라는 말은 생물학이 아니라 개인을 둘러싼 집단 수준의 자료를 가리키는 통계 용어입니다.
본 자료에서는 생태학적 오류라는 이름이 어떻게 생겨났는지부터 집단 자료와 개인 자료가 엇갈리는 원리, 실제로 자주 마주치는 사례, 그리고 이 함정을 피하는 방법까지 차례로 살펴보겠습니다.
집단의 숫자가 개인을 대신할 수 없는 이유
생태학적 오류라는 이름의 시작
생태학적 오류는 한 사회학자가 미국 인구조사 자료를 다시 계산해 보면서 세상에 널리 알려졌습니다.
(1) 로빈슨의 1950년 논문
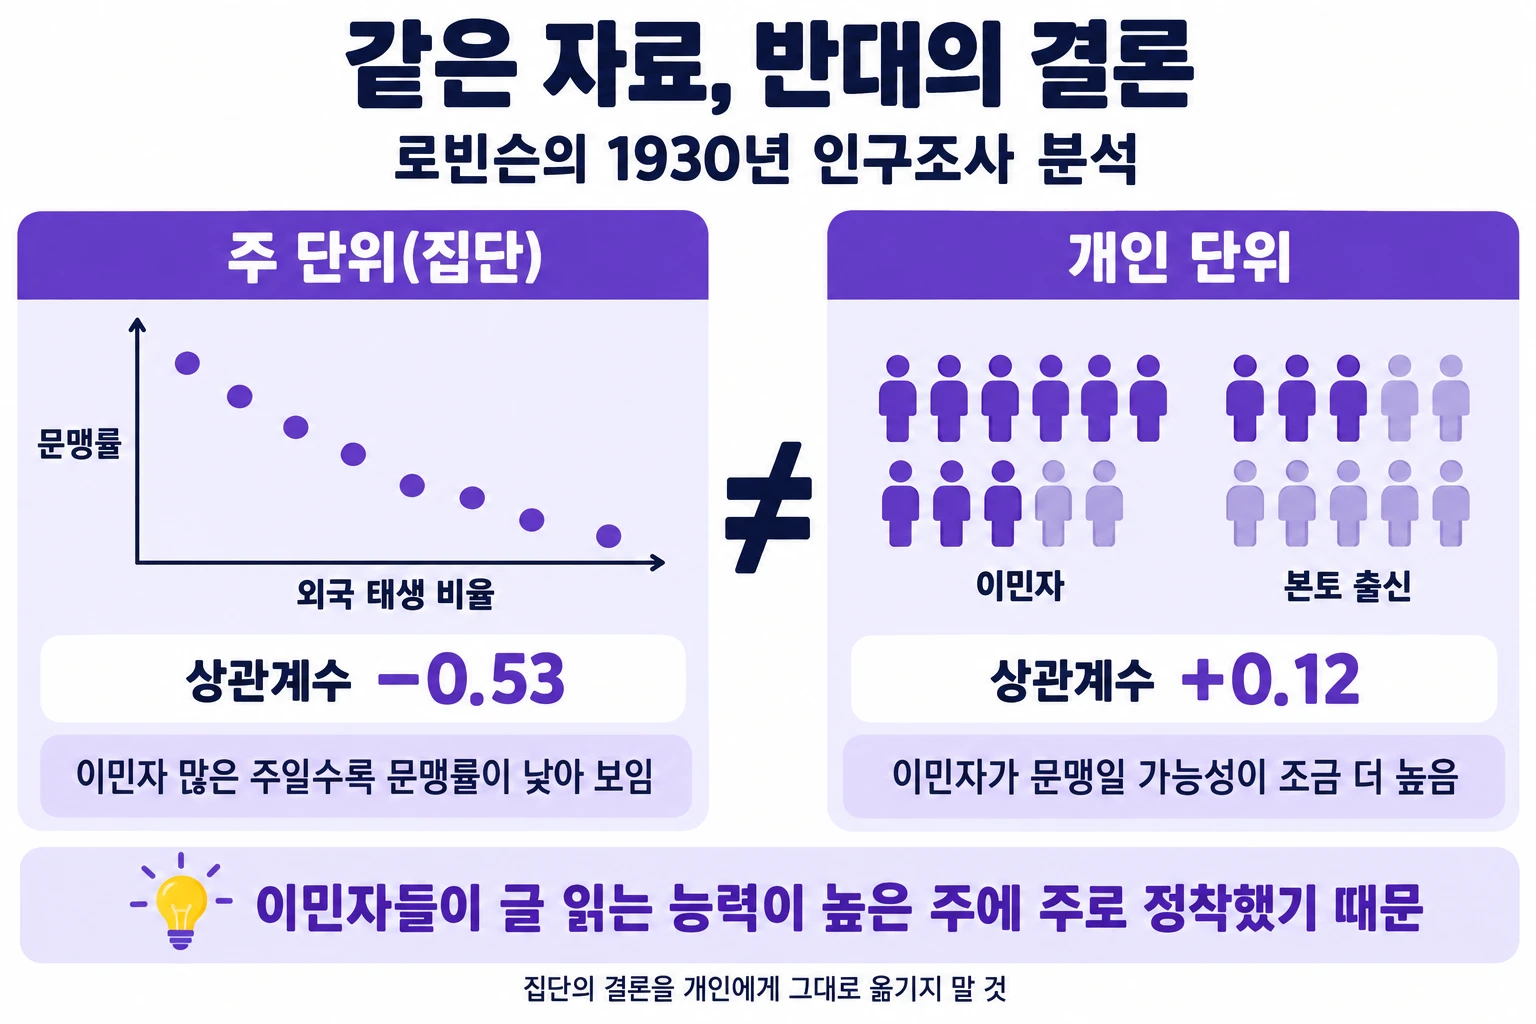
미국의 사회학자 윌리엄 로빈슨(William S. Robinson)은 1930년 인구조사 자료로 주마다 외국 태생 인구의 비율과 문맹률을 비교했습니다. 주 단위로 보면 이민자가 많은 주일수록 문맹률이 오히려 낮아 보였습니다. 그러나 개인 단위로 다시 계산하자 이민자가 본토 출신보다 문맹일 가능성이 조금 더 높다는, 방향이 반대인 결과가 나왔습니다. 주 단위 상관계수는 마이너스 0.53이었는데, 개인 단위 상관계수는 플러스 0.12였습니다. 2011년에는 로빈슨이 주 단위 계산에 쓴 자료 일부가 잘못되었고 바른 값은 마이너스 0.46이라는 재검토가 나왔지만, 방향이 뒤집힌다는 핵심은 그대로입니다.
(2) 엇갈림의 이유
로빈슨은 이민자들이 본토 출신 주민의 글 읽는 능력이 높은 주에 주로 정착했기 때문에 이런 차이가 생겼다고 설명했습니다. 집단의 특징이 개인의 특징을 덮어 버린 셈입니다.
(3) 이름이 붙기까지
로빈슨은 집단 자료로 개인을 판단하지 말라고 경고했고, 이 착각에 ‘생태학적 오류’라는 이름을 붙인 사람은 1958년 통계학자 해넌 셀빈(Hanan Selvin)이었습니다.
집단 자료와 개인 자료가 엇갈리는 원리
집단의 평균이나 비율은 여러 사람의 값을 하나로 뭉뚱그린 결과라서, 그 안에서 개인이 어떻게 흩어져 있는지는 보여 주지 않습니다.
(1) 상관관계의 수준 차이
집단 단위로 계산한 상관관계를 생태학적 상관이라고 부릅니다. 이 값은 개인 단위의 상관관계와 크기는 물론 방향까지 다를 수 있습니다.
(2) 평균이 높다고 가능성도 높은 것은 아니다
A 집단은 80%가 40점, 20%가 95점을 받아 평균이 51점이고, B 집단은 절반이 45점, 절반이 55점을 받아 평균이 50점이라고 가정해 보겠습니다. 평균은 A가 높지만, 두 집단에서 한 명씩 뽑아 비교하면 80%의 경우에 B 쪽 사람이 더 높은 점수를 받습니다.
(3) 집단 자체가 만드는 영향
개인의 행동이 자기 조건뿐 아니라 주변 집단의 분위기에도 영향을 받으면, 집단 수준의 관계와 개인 수준의 관계가 서로 다른 모습으로 나타납니다.
집단을 합치거나 나누는 순간 경향이 뒤집히는 심슨의 역설도 같은 뿌리를 가진 현상으로, 통계학에서는 생태학적 오류의 한 갈래로 함께 다루기도 합니다. 결국 어느 수준에서 자료를 묶느냐가 결론 자체를 바꿀 수 있다는 점이 핵심입니다.
생활 속에서 마주치는 생태학적 오류
생태학적 오류는 뉴스와 연구, 일상 대화 곳곳에 숨어 있습니다.
- 부유한 주와 부유한 유권자(Rich states and rich voters): 2004년 미국 대통령 선거에서 부시 후보는 가장 가난한 15개 주에서 이겼고 케리 후보는 가장 부유한 11개 주 가운데 9곳에서 이겼습니다. 하지만 개인 단위로 보면 연 소득 20만 달러가 넘는 유권자의 62%가 부시를 찍어, 소득이 낮은 유권자보다 훨씬 높은 비율을 보였습니다.
- 뒤르켐의 자살 연구(Durkheim’s study of suicide): 개신교도가 많은 지역에서 자살률이 높았다는 결과를 두고, 개신교도 개인이 더 위험하다고 단정하는 것은 생태학적 오류의 대표적 예로 자주 꼽힙니다.
- 나라별 식습관과 건강(Diet and health by country): 어떤 음식을 많이 먹는 나라의 평균 수명이 길다고 해서, 그 음식을 먹는 사람이 오래 산다는 뜻은 아닙니다.
이처럼 같은 자료라도 어느 수준에서 바라보느냐에 따라 전혀 다른 이야기가 만들어질 수 있습니다.
생태학적 오류를 피하는 방법
생태학적 오류를 피하려면 결론을 내리기 전에 자료가 어느 수준에서 모였는지부터 확인해야 합니다.
(1) 질문과 자료의 수준 맞추기
개인에 대해 알고 싶다면 개인 자료를, 지역이나 국가에 대해 알고 싶다면 집단 자료를 써야 합니다. 질문의 수준과 자료의 수준이 어긋나는 순간 오류가 끼어들 틈이 생깁니다.
(2) 여러 수준을 함께 보는 분석
개인과 집단의 영향을 동시에 따지는 다수준 분석처럼, 두 수준을 한 모형에 넣어 구분하는 통계 기법도 쓰입니다.
(3) 반대 방향의 함정도 조심하기
거꾸로 개인 자료만 보고 집단 전체의 특징을 단정하는 잘못도 있습니다. 이를 원자론적 오류(Atomistic Fallacy)라고 부르며, 생태학적 오류와 짝을 이루는 개념입니다.
생태학적 오류는 숫자가 틀려서가 아니라 숫자를 읽는 눈높이가 어긋나서 생기는 착각입니다. 집단의 평균은 집단을 설명할 뿐, 그 안의 한 사람을 대신 말해 주지는 않습니다.
통계를 볼 때마다 이 숫자가 누구를 단위로 모은 것인지 먼저 묻는 것, 그것이 올바른 데이터 해석의 첫걸음입니다.
이 글 PDF 구매
1,000원한국어 PDF · 같은 계정으로 다시 다운로드할 수 있어요.