Bạn đã từng thấy tin nói rằng ăn sô cô la mỗi ngày giúp giảm cân chưa? Năm 2015, kết quả nghiên cứu này được truyền thông nhiều nước đưa tin và gây xôn xao dư luận. Nhưng không lâu sau, nhà báo John Bohannon, người thực hiện nghiên cứu, đã trực tiếp thú nhận. Ông cho biết đây là một thí nghiệm được cố tình dàn dựng để cho thấy khoa học kém chất lượng có thể lan truyền dễ dàng đến mức nào; ông đã đo cùng lúc 18 chỉ tiêu như cân nặng, cholesterol và chất lượng giấc ngủ, rồi chỉ đưa ra những kết quả tình cờ có sự khác biệt.
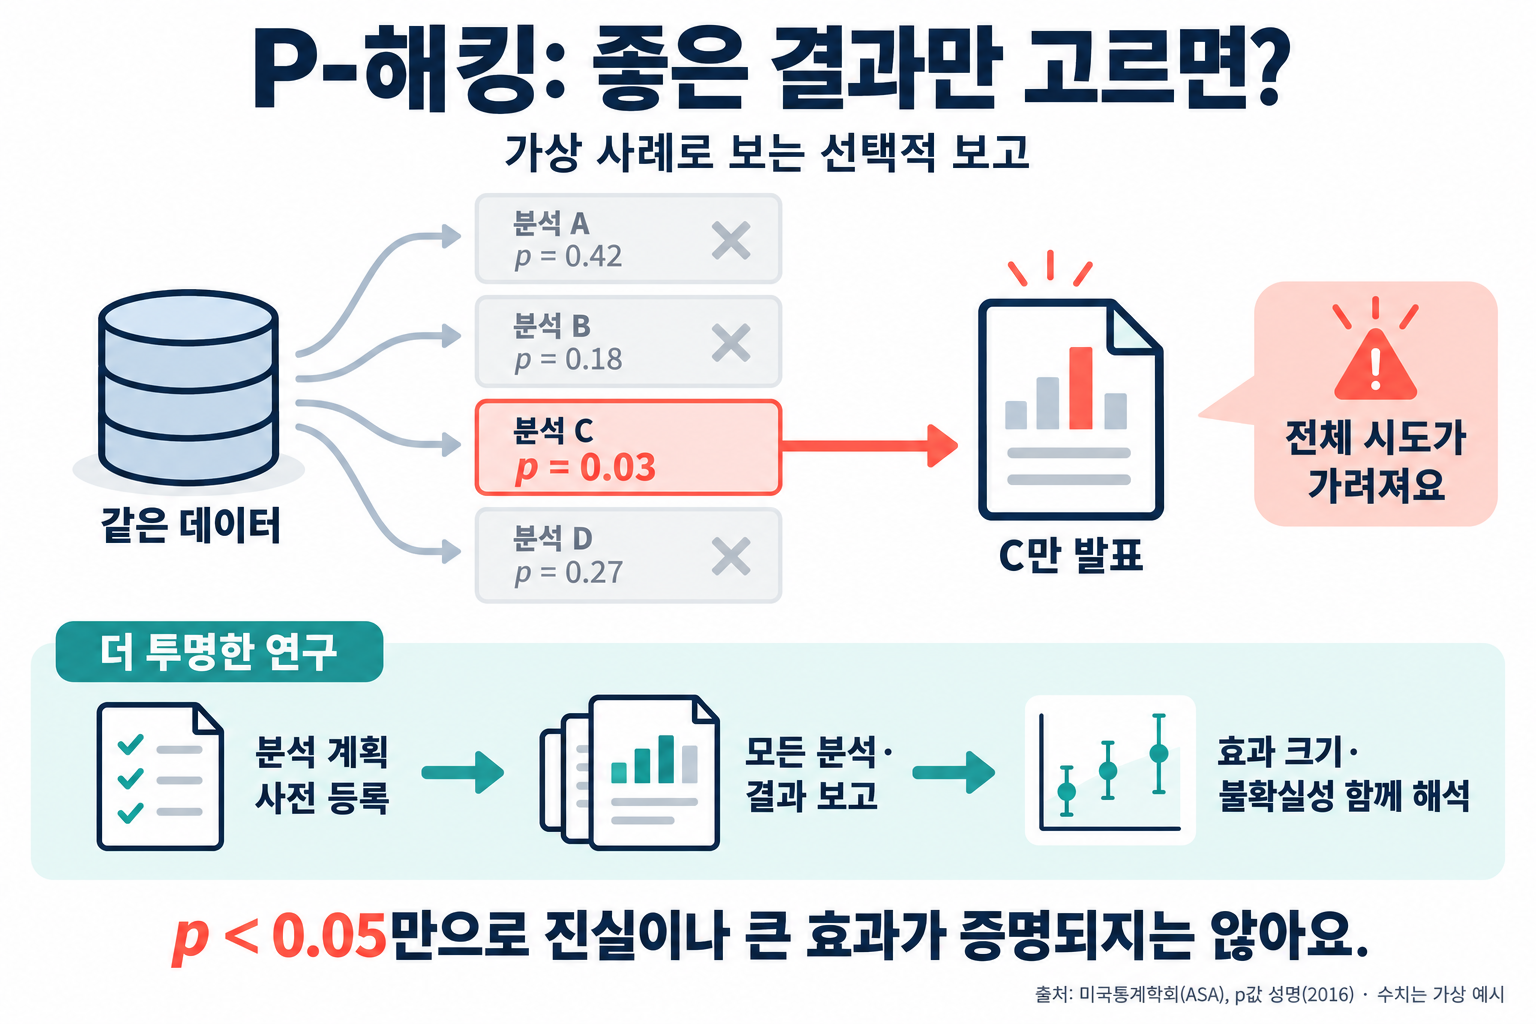
Việc phân tích dữ liệu theo nhiều cách cho đến khi có kết quả mong muốn, tạo ra những con số “có ý nghĩa thống kê” như vậy được gọi là “P-hacking (P-hacking)”. Dù không làm giả dữ liệu mà chỉ lựa chọn phương pháp phân tích, kết quả vẫn trông như một phát hiện thực sự, nên đây là cái bẫy mà ngay cả nhà nghiên cứu cũng dễ mắc phải mà không hay biết.
Trong tài liệu này, chúng ta sẽ lần lượt tìm hiểu từ ý nghĩa của giá trị p, điểm khởi đầu của P-hacking, đến những cách P-hacking thường diễn ra, cuộc khủng hoảng khả năng tái lập mà nó để lại cho giới khoa học và các biện pháp ngăn chặn.
Tra tấn các con số, chúng sẽ thú nhận: nguyên lý và cách ứng phó với P-hacking
Giá trị p và mức ý nghĩa là gì?
Để hiểu P-hacking, trước tiên cần biết giá trị p là gì. Nhà nghiên cứu thường đặt ra giả thuyết không rằng “không có tác động”, rồi xem xét khả năng kết quả thực tế thu được có thể xuất hiện chỉ do ngẫu nhiên là bao nhiêu.
- Giá trị p (P-value): Xác suất xuất hiện kết quả cực đoan bằng hoặc hơn kết quả đang quan sát, với giả định hoàn toàn không có tác động.
- Mức ý nghĩa (Significance Level): Ngưỡng để xác định kết quả không phải do ngẫu nhiên, thường được đặt ở 0.05 (5%).
- Dương tính giả (False Positive): Việc kết luận nhầm rằng có tác động khi thực tế không có tác động, do kết quả tình cờ vượt qua ngưỡng.
Vấn đề nằm ở chỗ ngưỡng này là 5%. Nếu thực hiện 20 phép kiểm định khi hoàn toàn không có tác động, trung bình sẽ có 1 lần tình cờ cho kết quả “có ý nghĩa”. Nếu thực hiện 20 phép kiểm định độc lập với nhau, xác suất có ít nhất một lần vượt ngưỡng lên tới khoảng 64%. Nếu thử nhiều lần rồi chỉ cho thấy những lần thành công, sự ngẫu nhiên cũng sẽ trông như một phát hiện.
P-hacking diễn ra như thế nào?
Thuật ngữ P-hacking được các nhà tâm lý học người Mỹ Uri Simonsohn, Leif Nelson và Joseph Simmons sử dụng lần đầu trong một bài báo năm 2014. Trước đó, vào năm 2011, họ cũng đã phơi bày vấn đề bằng cách biến kết luận vô lý rằng những người nghe bài hát “When I'm Sixty-Four” của The Beatles thực sự trẻ lại thành một kết quả “có ý nghĩa” thống kê.
(1) Đo nhiều kết quả rồi chỉ chọn những kết quả tốt
Giống như nghiên cứu về sô cô la, người ta tăng thật nhiều chỉ tiêu đo lường rồi chỉ báo cáo những chỉ tiêu vượt ngưỡng.
(2) Dừng lại khi có kết quả mong muốn
Người ta thu thập dữ liệu từng chút một, kiểm định sau mỗi lần và ngừng thu thập ngay khi giá trị p xuống dưới 0.05.
(3) Chia nhỏ nhóm và loại bỏ giá trị ngoại lai
Nếu không thấy tác động trong toàn bộ mẫu, người ta thử chia theo giới tính hoặc nhóm tuổi, rồi loại bỏ những dữ liệu gây trở ngại cho kết quả với lý do đó là “giá trị ngoại lai”.
(4) Viết lại giả thuyết sau khi xem kết quả
Người ta mô tả quy luật tìm thấy trong dữ liệu như thể đã dự đoán nó ngay từ đầu. Giả thuyết thu được qua quá trình khám phá cần được kiểm chứng lại bằng dữ liệu mới, nhưng nếu bỏ qua bước này, quy luật ngẫu nhiên sẽ trở thành kết luận. Việc này được gọi là HARKing.
Những con số dẫn đến cuộc khủng hoảng khả năng tái lập

Kết quả thu được bằng P-hacking là sản phẩm của sự ngẫu nhiên nên thường không xuất hiện trở lại khi nhà nghiên cứu khác thực hiện lại đúng thí nghiệm đó. Điều này đã lan rộng thành vấn đề về độ tin cậy của toàn bộ nền khoa học.
Những tác động biến mất khi thử lại
Năm 2015, Dự án Khả năng tái lập (Reproducibility Project), với sự tham gia của hơn 270 nhà nghiên cứu, đã thực hiện lại thí nghiệm của 100 nghiên cứu đăng trên các tạp chí tâm lý học nổi tiếng. Phần lớn nghiên cứu ban đầu báo cáo kết quả có ý nghĩa thống kê, nhưng tỷ lệ thu được cùng kết luận khi thực hiện lại thí nghiệm chỉ khoảng 36%. Thông tin này đã khiến thuật ngữ “khủng hoảng khả năng tái lập (Replication Crisis)” được biết đến rộng rãi.
Những thất bại bị chôn vùi trong ngăn kéo
Các tạp chí học thuật ưu ái những kết quả mới và có ý nghĩa thống kê hơn những kết quả cho thấy không có tác động. Vì vậy, các nghiên cứu thất bại không được công bố mà nằm lại trong ngăn kéo; hiện tượng này được gọi là thiên lệch công bố (Publication Bias) hoặc vấn đề ngăn kéo. Môi trường như vậy khiến nhà nghiên cứu bị cám dỗ kéo giá trị p xuống dưới 0.05.
Cách ngăn chặn P-hacking
Năm 2016, Hiệp hội Thống kê Hoa Kỳ (ASA) đưa ra tuyên bố chính thức về giá trị p, nhấn mạnh rằng không nên đánh giá giá trị của nghiên cứu chỉ bằng một giá trị p. Kể từ đó, nhiều biện pháp đã được áp dụng đồng thời.
(1) Đăng ký trước
Trước khi thu thập dữ liệu, nhà nghiên cứu đăng ký giả thuyết và phương pháp phân tích trên một kho lưu trữ công khai. Hình thức báo cáo đăng ký trước (Registered Report), trong đó tạp chí cam kết đăng bài bất kể kết quả ra sao, cũng ngày càng phổ biến.
(2) Siết chặt tiêu chuẩn theo số lần kiểm định
Nếu kiểm định nhiều giả thuyết, người ta siết chặt tiêu chuẩn bằng cách chia mức ý nghĩa cho số lần kiểm định, như trong hiệu chỉnh Bonferroni (Bonferroni Correction).
(3) Công khai dữ liệu và quá trình phân tích
Khi dữ liệu gốc và mã phân tích được công khai cùng nhau, các nhà nghiên cứu khác có thể trực tiếp kiểm tra kết quả và tính toán lại.
Như câu nói được cho là của nhà kinh tế học Ronald Coase, nếu tra tấn dữ liệu đủ lâu, bạn có thể khiến chúng thú nhận bất cứ điều gì. Các con số không nói dối, nhưng người lựa chọn các con số hoàn toàn có thể tạo ra câu chuyện theo ý mình. Vì vậy, nghiên cứu tốt bắt đầu từ việc minh bạch quá trình dẫn đến kết quả, hơn là từ những kết quả đáng kinh ngạc.
Khi đứng trước một kết quả nghiên cứu, hãy hỏi thêm một lần rằng con số ấy thu được sau bao nhiêu lần thử; đó là bước đầu tiên để biết đọc thống kê đúng cách.